从图片验证码到字符识别:YOLO 模型在验证码识别中的实践
从图片验证码到字符识别:YOLO 模型在验证码识别中的实践
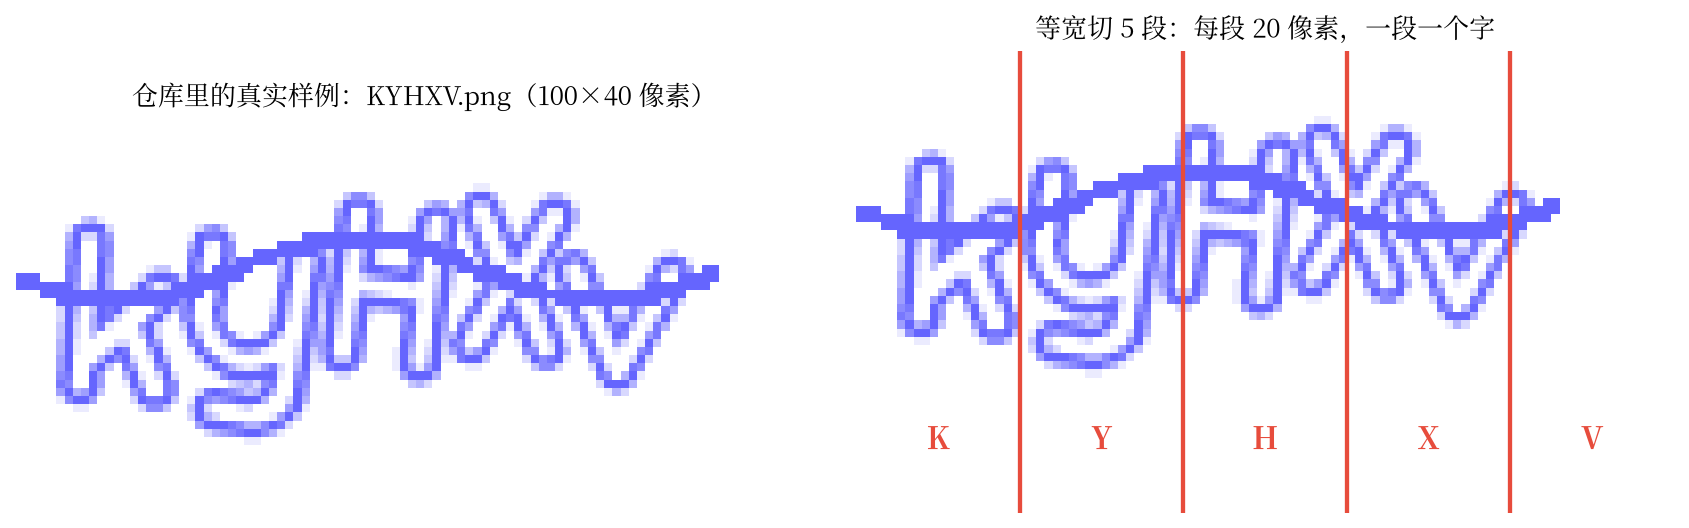
先看一张图。
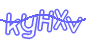
五个字母,歪歪扭扭,中间还划过一条线。这是网站登录框里那种验证码,练手项目里非常常见的一种。
你一眼能不能认出来是 KYHXV?大概能,但可能要盯两秒。
这篇文章想做的事,是把”机器怎么做到这件事”从头讲一遍。不讲玄乎的概念,只讲它到底在干什么。写完之后你会发现,整件事的骨架简单得有点意外。
配套的两个仓库:
image-captcha-recognition-yolo:数据集准备、训练脚本、推理脚本pyocrcaptcha:把训练好的模型打包成pip能装的包,带命令行
一、项目背景
验证码是干什么用的
网站为什么要给你看这五个歪字母?
因为它想区分”坐在电脑前面的人”和”写脚本的机器”。人认字很轻松,程序想认字就费劲了,在深度学习普及之前尤其费劲。所以早期的思路很朴素:这个任务对机器难,对人容易,那就拿它当门槛。
这个思路在二十年前是成立的。现在不太成立了。
为什么这类验证码容易被打穿
看几个数字。
这个项目用的字符集是 36 类:数字 0-9 加字母 A-Z。没有小写字母,没有区分易混字符。图片尺寸固定 100×40 像素,五个字符等宽排列,每个字符正好占 20 像素。
这三条凑在一起,等于把题目的答案提前交了一半:
字符集小,36 个选项,瞎猜一个也有 2.8% 的机会蒙对。
布局固定。字符不会飘、不会转、不会挤在一起,位置可以直接算出来,不需要让模型去”找”。
图像也干净,只有一条干扰线和轻微的倾斜,没有噪点、没有背景纹理、没有字符粘连。
三条加起来,识别这件事就从”看懂一张图”退化成”把图画成五格,每格问一次这是哪个字”。
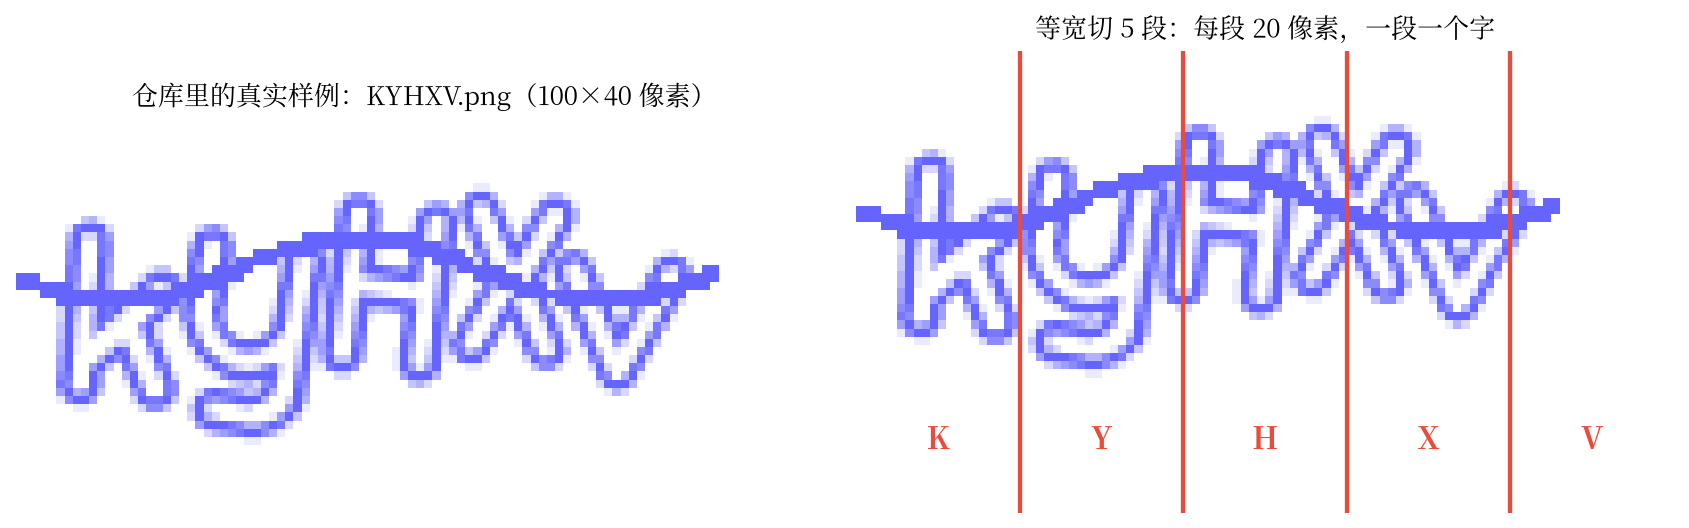
红色竖线是按宽度算出来的,不是模型找出来的。100 ÷ 5 = 20,一条线一个位置。这一步是这套方案能跑通的前提,也是它最脆弱的地方。
二、项目整体架构
技术栈
整条链路用到的东西不多:
| 环节 | 用什么 |
|---|---|
| 图片读写、切分 | Pillow(PIL) |
| 模型与训练框架 | Ultralytics 8.3+ |
| 底层张量计算 | PyTorch |
| 模型 | YOLO11n-cls(分类版,n 是最小的那一档) |
| 打包分发 | setuptools + PyPI + GitHub Actions |
注意模型名后缀那个 -cls。它代表 classification(分类),不是 detection(检测)。这个区别是这篇文章最想讲清楚的一件事。
识别流程
整条流程长这样:
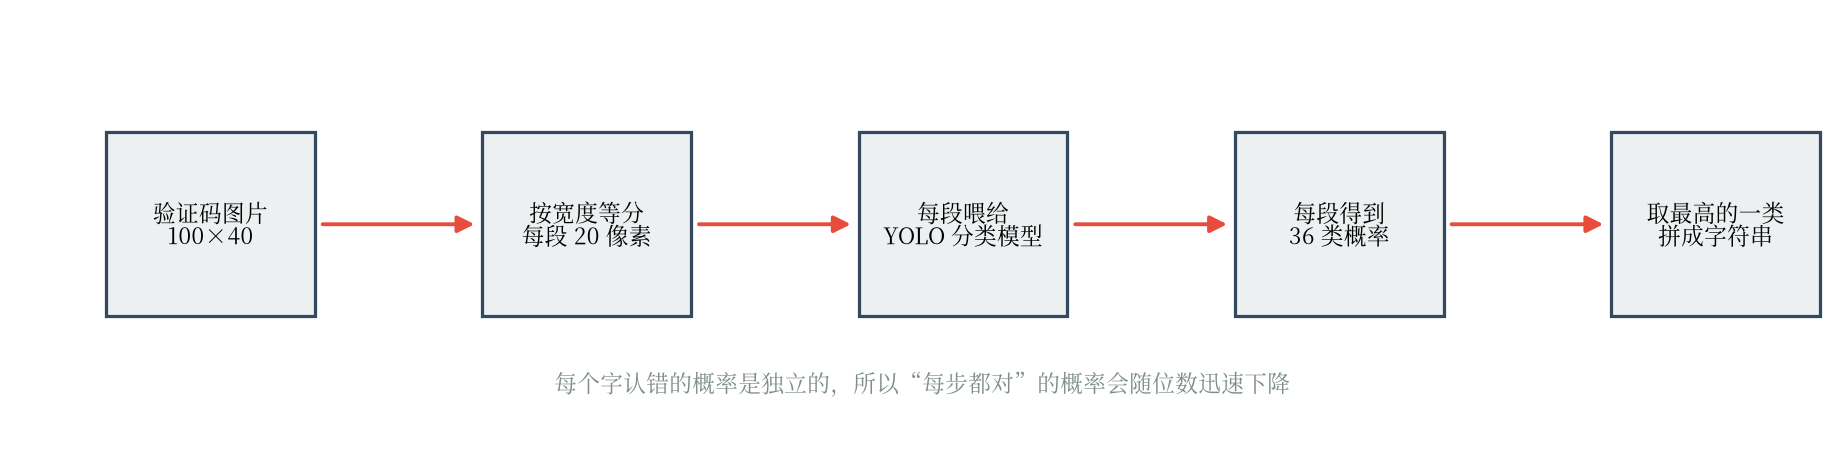
分成四步:切分 → 逐段分类 → 取最高概率的类别 → 拼接。
到这儿有人会问:说好的”目标检测”呢?
分类和检测,到底差在哪
这是最容易混的地方。两个任务都是看图片得出结论,但输出完全不同。
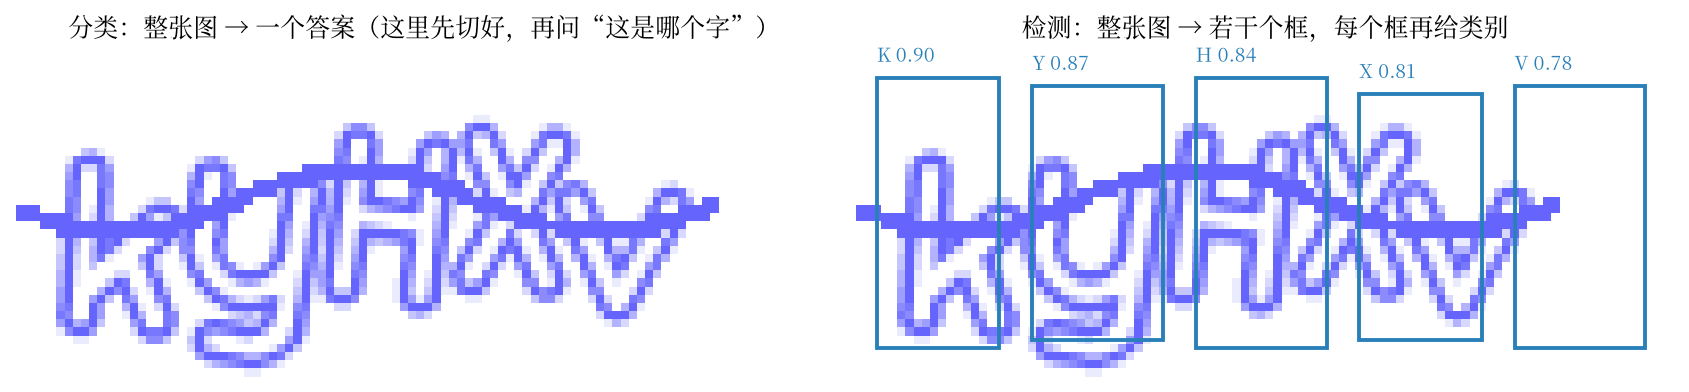
左边是分类:给一张图,回答”这是什么”。答案是一个类别。
右边是检测:给一张图,回答”这里有什么、那里有什么”。答案是若干个框,每个框带一个类别。
用一句话概括:
分类告诉你是什么,检测告诉你在哪、是什么。
于是选择哪条路,取决于”位置”这件事要不要模型去猜。
这个项目的字符是等宽的,位置直接除一下就算出来了。既然能算,何必让模型去猜?所以它选了分类,把图切成五段,每段问一次”这是哪个字”,问五次。
省下来的还有人工。让模型学”框在哪里”需要大量的标注(每张图都要人工画框),而”每段是哪个字”的标注可以直接从文件名里得到。工作量差了一个数量级。
后面第六节会讲:如果字符不等宽、有重叠、有旋转,情况就变了,那时必须上检测。
三、环境搭建
依赖只有两个:
1 | python -m pip install -r requirements.txt |
requirements.txt 的内容是:
1 | ultralytics>=8.3.0 |
Ultralytics 会自己把 PyTorch、TorchVision、NumPy、OpenCV 这些带进来,不用手动装。
确认一下装好了:
1 | python -c "import ultralytics, torch; print(ultralytics.__version__, torch.__version__)" |
有显卡的机器用 --device 0 训练,没显卡用 --device cpu。这个模型很小(yolo11n 里的 n 是 nano),CPU 也跑得动,只是慢一些。
四、数据集分析
图片长什么样
原始验证码是 100×40 的 PNG,五个字符,宽度正好被 5 整除。仓库里放了 10 张示例:
1 | KYHXV 6YNE2 Y3FV8 CHMHX CSZQX |
标注怎么来的
这是这个项目里最省事、也最值得学的一处设计。
文件名就是标签。图片叫 000a.png,那它的答案就是 000a;叫 KYHXV.png,答案就是 KYHXV。
不需要人工标注,也用不着额外的标签文件,数据集整理这一步直接变成了”读文件名”。
脚本里还留了另一条路:如果文件名没意义,就用 train.txt / val.txt 两个清单,每行写”图片名 验证码”,中间用空格隔开。
从整图到字符图
训练分类模型需要的是单字图片,不是整串。所以中间要切一刀:
1 | char_width = width // len(text) # 100 // 5 = 20 |
切完之后,磁盘上的目录结构自动变成了分类模型要的样子:
1 | data/characters/ |
每个文件夹的名字就是类别名,Ultralytics 直接读这个结构,不需要另外写类别映射表。
训练集和验证集怎么分?脚本用文件名的哈希值取前 32 位,折算成 0 到 1 之间的小数,小于 0.2 的进验证集。这样划分是确定的:同一批图片,不管在哪台机器上跑,分法完全一样,方便复现。
五、模型训练过程
训练参数
1 | python train.py --data data/characters --epochs 100 --imgsz 96 --device 0 |
关键参数:
| 参数 | 值 | 为什么 |
|---|---|---|
| 模型 | yolo11n-cls.pt |
最小的分类模型,验证码这种简单任务够用 |
| 轮数 | 100 | 实际在第 94 轮取得最佳结果 |
| 输入尺寸 | 96×96 | 比默认的 64 大,能保住笔画的细节 |
| 批量 | 128 | 一次喂 128 张字符图 |
| 早停 | 20 轮 | 连续 20 轮没进步就停 |
一个反直觉的细节:把翻转关掉
训练图像模型时,通常会给图片做各种随机变换来增加数据多样性,转一点角度、挪一点位置、放大缩小。这叫数据增强,是防止模型死记硬背的常用手段。
但这里有一条被特意关掉了:
1 | fliplr=0.0, # 左右翻转,关闭 |
为什么?因为镜像会改变字符的身份。
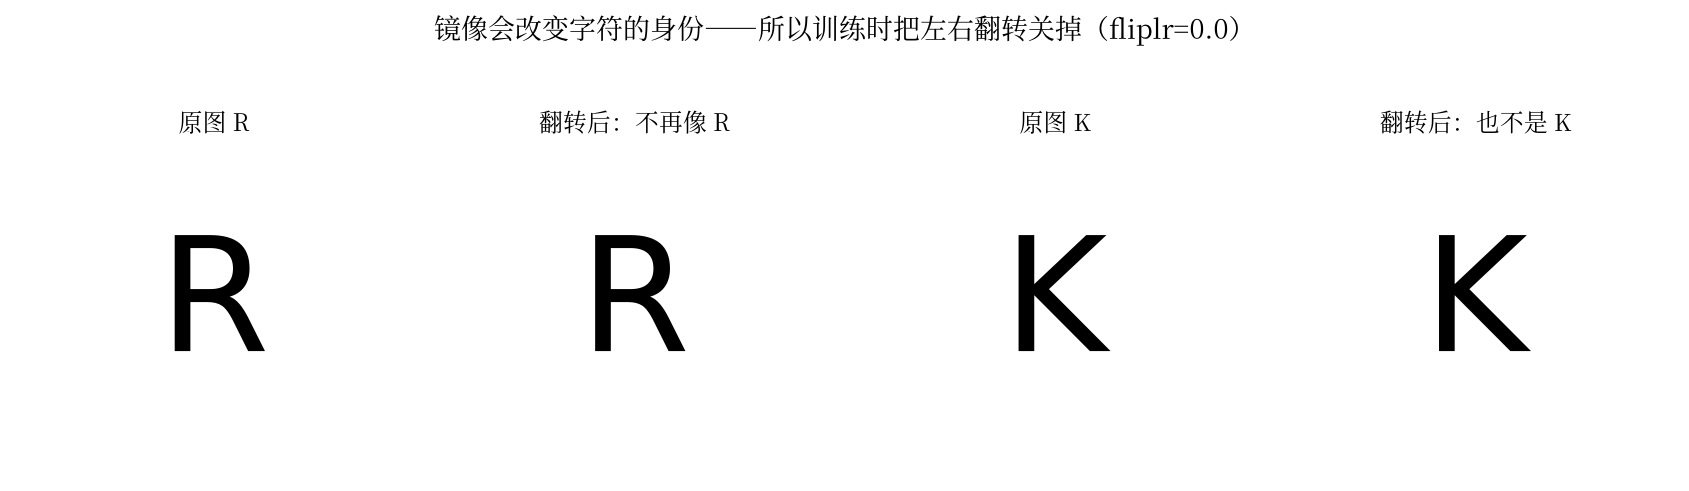
R 翻转过来不像任何一个字母,K 也一样。如果你把翻转后的图喂给模型,还告诉它”这是 R”,那等于在教错的东西,模型会困惑,准确率反而下降。
同一条道理:b 和 d、p 和 q、6 和 9,这些字符互为镜像或旋转关系。对它们做翻转增强,就是在制造标签冲突。
保留的增强是温和的:旋转 ±3 度、平移 5%、缩放 20%、随机擦除 10%。这些都不改变字符的身份,只是让模型见过更多”同一个字的不同写法”。
数据增强不是越多越好。判断标准只有一条:这个变换之后,答案还对不对? 对就留,错就扔。
训练产出
训练结果落在:
1 | runs/captcha/character_classifier/weights/best.pt |
这个 best.pt 就是最终模型,只有几兆。项目把它发布在 GitHub Release 上,可以直接下载。
成绩
| 指标 | 数值 |
|---|---|
| 单字符 Top-1 准确率 | 83.23% |
| 单字符 Top-5 准确率 | 94.59% |
Top-1 是”模型给出的第一名猜对了没有”,Top-5 是”正确答案在模型的前五名里”。
83% 看着还行,但下一节会看到,这个数字用到整串上会发生什么。
六、推理流程分析
图片输入
1 | with Image.open(image_path) as source: |
先检查一件事:宽度能不能被位数整除。100 ÷ 5 = 20,可以;要是 103 除以 5,除不尽,脚本直接报错。
这个检查暴露了方案的前提,它假设字符严格等宽。
字符定位:算出来的,不是找出来的
1 | char_width = width // positions # 每段多宽 |
第几个字符,就从第几个 20 像素开始切。位置是乘法算出来的。
那如果换成检测方案,这一步怎么做?
检测模型会对整张图输出一堆候选框,每个框带一个置信度分数。问题是同一个字符通常会被预测出很多个重叠的框,得挑一个留下。怎么挑?靠两个工具。
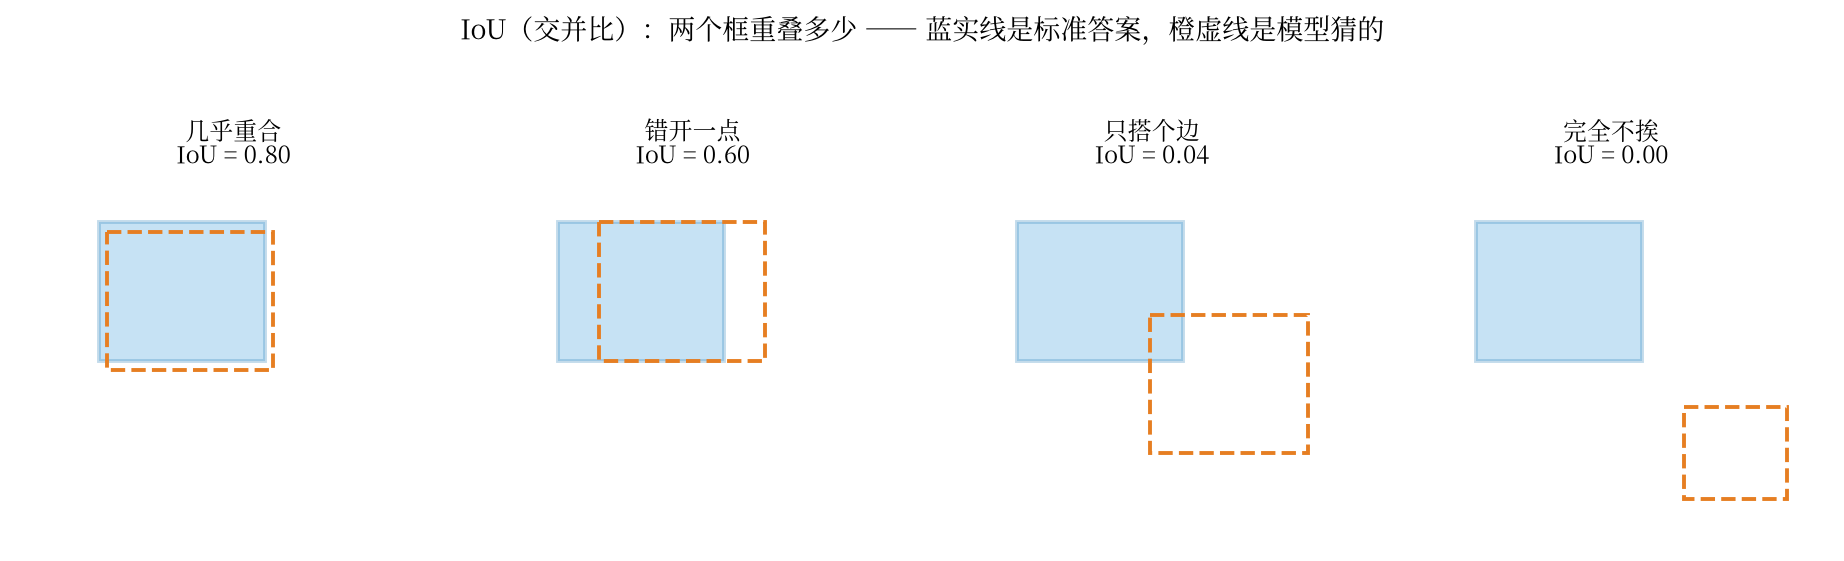
先说 IoU(交并比),它衡量两个框重叠了多少:
就是”两个框重合的面积”除以”两个框加起来占的总面积”。完全重合是 1,完全不挨着是 0。
再用 NMS(非极大值抑制)把重复的框压掉:先按分数从高到低排队,留下第一个;然后把跟它重叠超过阈值(通常是 0.5)的框全部删掉;再从剩下的里挑最高的,重复。
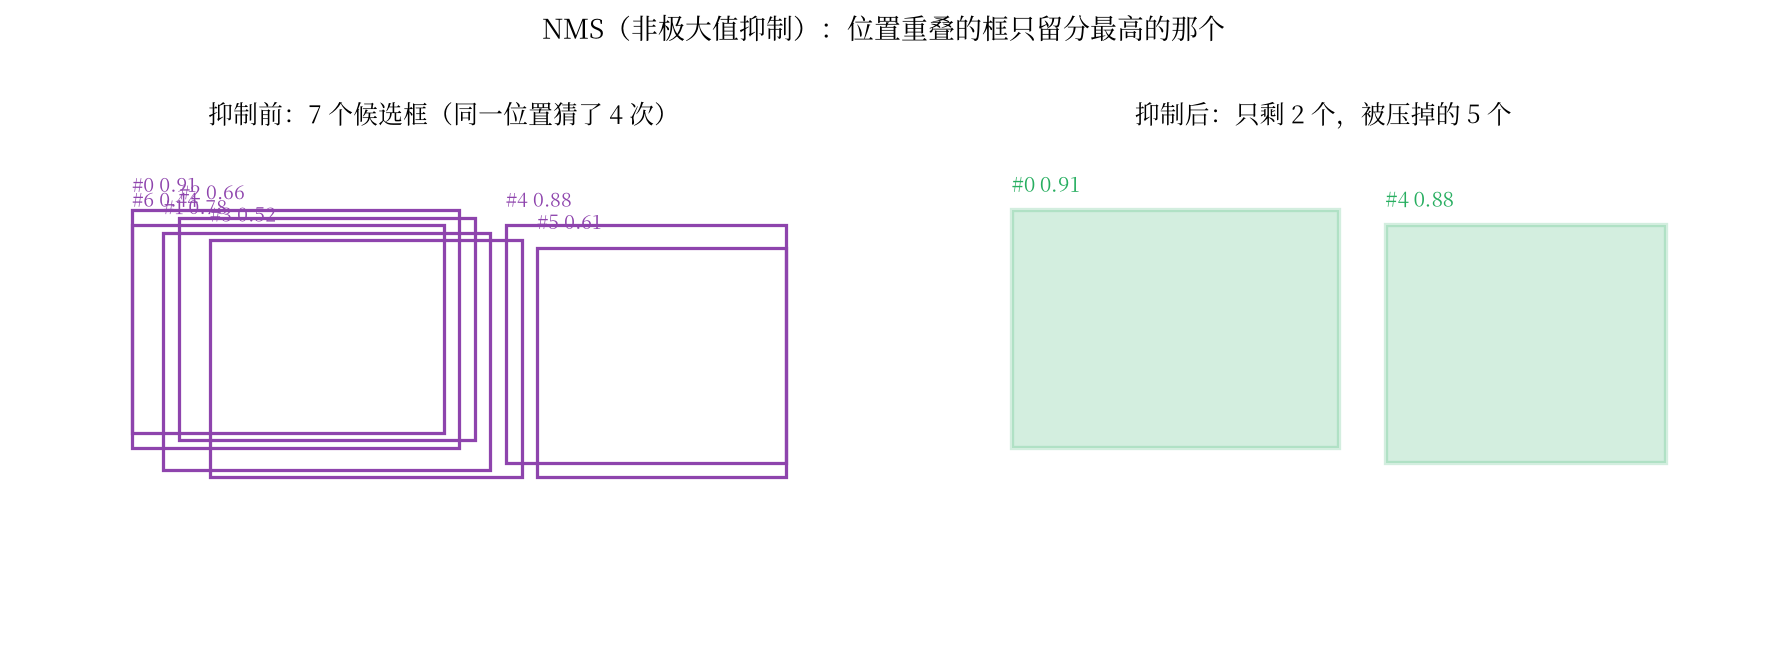
七个候选框进去,两个出来。左边那一堆同一个字符的猜测被压成了一个,右边同理。
下一步是坐标排序,把留下的框按左上角的 x 坐标从小到大排,从左到右读出来。这一步简单,但只有在”检测”路线里才需要。
回到这个项目:因为它提前算好了位置,IoU 和 NMS 整个环节都被省掉了。
结果输出
每一段送进模型,得到一个 36 维的概率向量,取最大的那个:
1 | result = model.predict(source=crop, imgsz=imgsz, verbose=False)[0] |
最后拼起来,顺带算出平均置信度:
1 | text = "".join(character for character, _ in results) |
命令行跑出来是这样:
1 | KYHXV confidence=0.9712 |
关键问题:单字 83%,整串是多少
这才是这篇文章最该看的一段。
整串验证码要每一个字都对才算对。而每个字认错的概率是独立的,所以:
p 是单字准确率,n 是字符个数。每个字都得过,所以要把单字准确率连乘 n 次,是乘,不是加。
拿 83.23% 代进去算:
| 位数 | 整串准确率 |
|---|---|
| 4 位 | 48.0% |
| 5 位 | 40.0% |
| 6 位 | 33.3% |
| 8 位 | 23.0% |
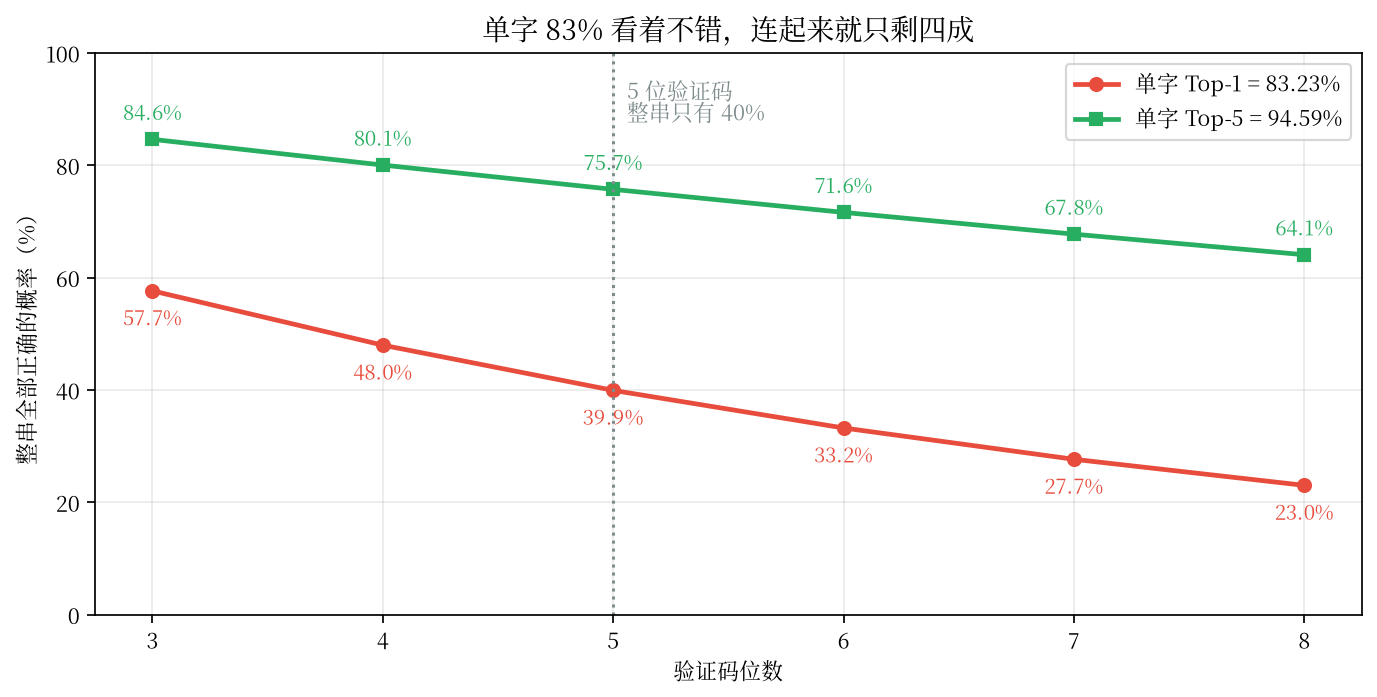
单字 83%,五个字连起来只剩 40%。
而如果用的是 Top-5 的 94.59%,这里要注意,Top-5 在单字场景下有意义(可以给五个候选让下游去选),在验证码场景下却没用:提交上去只有一个答案,模型必须自己挑出最可能的那一个。
这张图解释了一件容易被忽略的事:”单字准确率”是个偏乐观的指标。评价一个验证码识别模型,要看的是整串准确率,不是单字。
也顺便说明了为什么验证码做到 6 位、8 位就明显更难。不是验证码变聪明了,是连乘的尾巴拖得长。
七、安全角度分析
这一段从防守方的角度看。
这类验证码为什么不够
回到第一节的三条:字符集小、布局固定、图像干净。三条都是便利,也都是弱点。
字符集只有 36 类,信息量本来就小。5 位验证码的理论组合是 $36^5 = 60{,}466{,}176$ 种,看着挺多,但模型不需要穷举,它认字,一次就能给出答案。
布局固定,切分就成了理所当然的事。这一条最致命:它把”看懂一张图”这个困难任务,拆成了五个”认一个字”的简单任务。而认单字是老问题,几十年前就被神经网络解决了。
图像干净,等于没有防线。真正有用的干扰是让切分失效:字符互相重叠、宽度不等、随位置浮动、加入局部扭曲。只要位置不再是”宽度除以位数”,那一步乘法就崩了,方案要么退回到检测(成本立刻上升),要么直接失效。
自动化门槛有多低
这个项目的全部依赖是两个包,模型几兆,用的是最小的那一档,训练 100 轮。一台普通带显卡的笔记本,几个小时就能从头训出一个能用的模型。
也就是说,用固定字体的等宽验证码挡机器人,在今天基本等于没挡。这也不是什么高不可攀的技术。
要说明的是,这个项目本身在 README 里写明了仅供学习研究使用,并提醒遵守数据来源网站的服务条款。这里讨论的是防御视角:知道攻击怎么做,才知道自己的防线该怎么改。
对防守方的建议
如果哪天你需要自己设计验证码,或者评估正在用的那套,下面几条比较实用。
最容易犯的一条,是把答案放在布局里。尽量让字符位置、宽度、间距随机化,破坏”能算出来”这个前提。
加干扰线基本是心理安慰。一条线、几点噪点,对现在的模型几乎没影响。有效的干扰是破坏结构,比如字符粘连、局部扭曲、非等距排布。
图像本身也别太指望。图像验证码可以被自动化攻破,这一点最好当成前提接受。真正有效的是叠加行为与风险维度:请求频率、IP 信誉、鼠标轨迹,再加上无感验证和有感验证混着用。
最后是评价口径。别只看”单字准确率”或者”人工通过率”,要看整串准确率和人工通过率的差值,差值越大,防线越薄。
八、总结与优化建议
把整件事压缩成一句话:
图片验证码的识别,无非是”把图上的字符变成文字”。如果位置能算,就切成几段逐个认字;如果位置算不出来,就让模型画框找位置。
这个项目选了前一条路,因为它的字符是等宽的。
通用的流程只有四步:切分 → 逐个分类 → 取最高概率 → 拼接。没有别的玄机。
可以继续优化的地方
输入尺寸可以调大。96×96 已经比默认的 64 好,但笔画细节还能再榨一些出来,可以试 128。代价是训练和推理都变慢。
数据量是最直接的瓶颈。83.23% 这个数字的主要问题就出在这儿。同一套代码,把训练图片从几千张加到几万张,成绩通常会有明显提升。
集成思路也值得试试。同一个字符切得稍偏一点再认一次,两次结果不一致时按置信度裁决,能吃掉一部分切分误差。
再往下就得准备检测方案了。一旦遇到的验证码不是等宽布局,现在的脚本会直接报错。这时候要把标注方式从”文件名当标签”换成”每张图人工画框”,用 YOLO 的检测版本重训。工作量上一个台阶,但能应对真实世界的排布。
最后,报告成绩时把口径写清楚,是单字还是整串。前面算过,这两个数字能差一半以上。
最后一句
这件事没有想象中神秘。一张图进来,算法把它变成一堆数字,一层一层算下去,最后吐出 36 个概率,挑最大的那个。
如果你能把这个过程讲给一个没学过编程的人听明白,那你就是真的理解了它。讲不明白的地方,就是你还没搞清楚的地方。
就这么回事。