ZIP 为什么能让文件变小?—— 压缩的原理、格式与极限
ZIP 为什么能让文件变小?—— 压缩的原理、格式与极限
先看三个事实,它们看起来互相矛盾。
第一个:一个 221 KB 的中文文本文件,压成 ZIP 之后只剩 1.1 KB,砍掉了 99.5%。
第二个:一个 293 KB 的随机数据文件,压成 ZIP 之后变成 293.1 KB,不但没小,还胖了一点。
第三个:把一个已经压好的 ZIP 再压一遍、再压一遍、再压一遍。
这三个事实是同一件事的三个侧面。这篇文章想把它们串起来讲清楚。下面所有数字都是我在自己机器上跑出来的,不是抄的,代码逻辑在文中随手能找到。
顺便说一下这篇的写法。压这个话题有很多层,我打算把几套不同的思路混着用:用第一性原理拆它的成本结构,用它反过来想想什么时候不该压,用代码跑一遍验证,再盯一下那些极端情况。同一件事从几个角度各看一遍,比只从一个角度往下挖更容易看到全貌。
一、ZIP 文件格式分析
要理解压缩,先看看压缩出来的东西长什么样。很多人用了十几年 ZIP,从没打开过一个 ZIP 文件看里面。
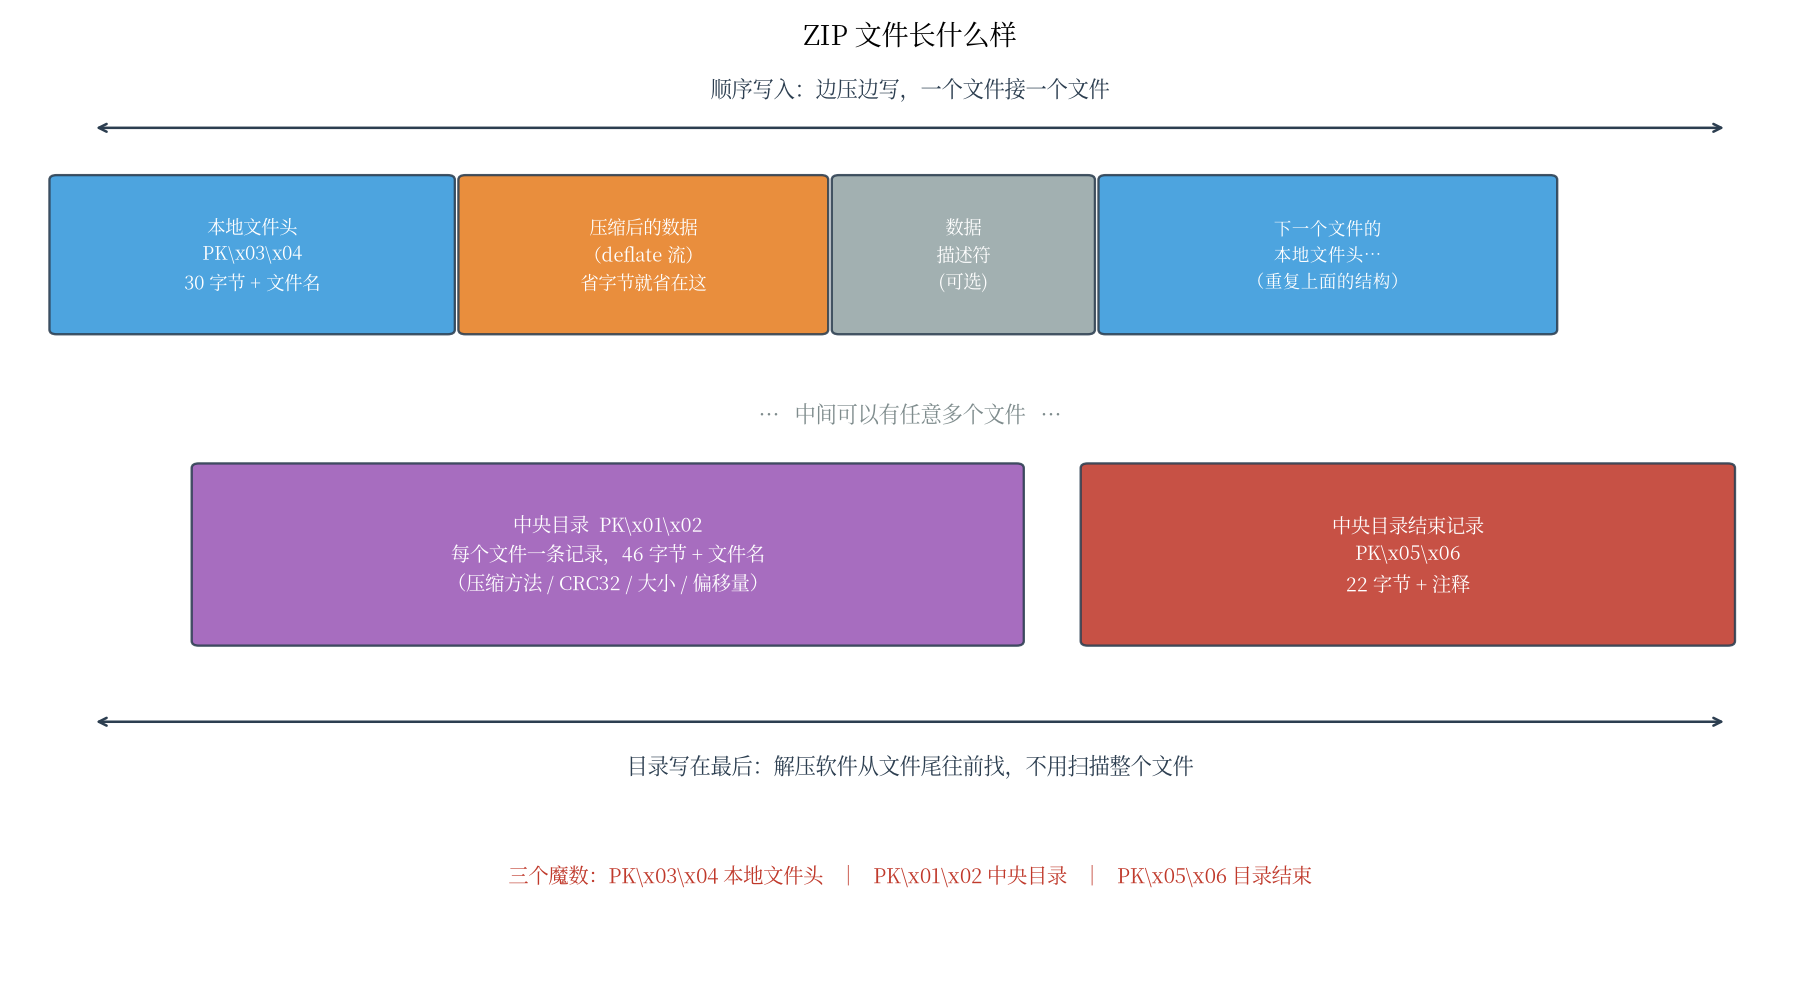
一个 ZIP 文件不是”一团压缩数据”,它是一个有结构的容器。它的结构大致是这样:
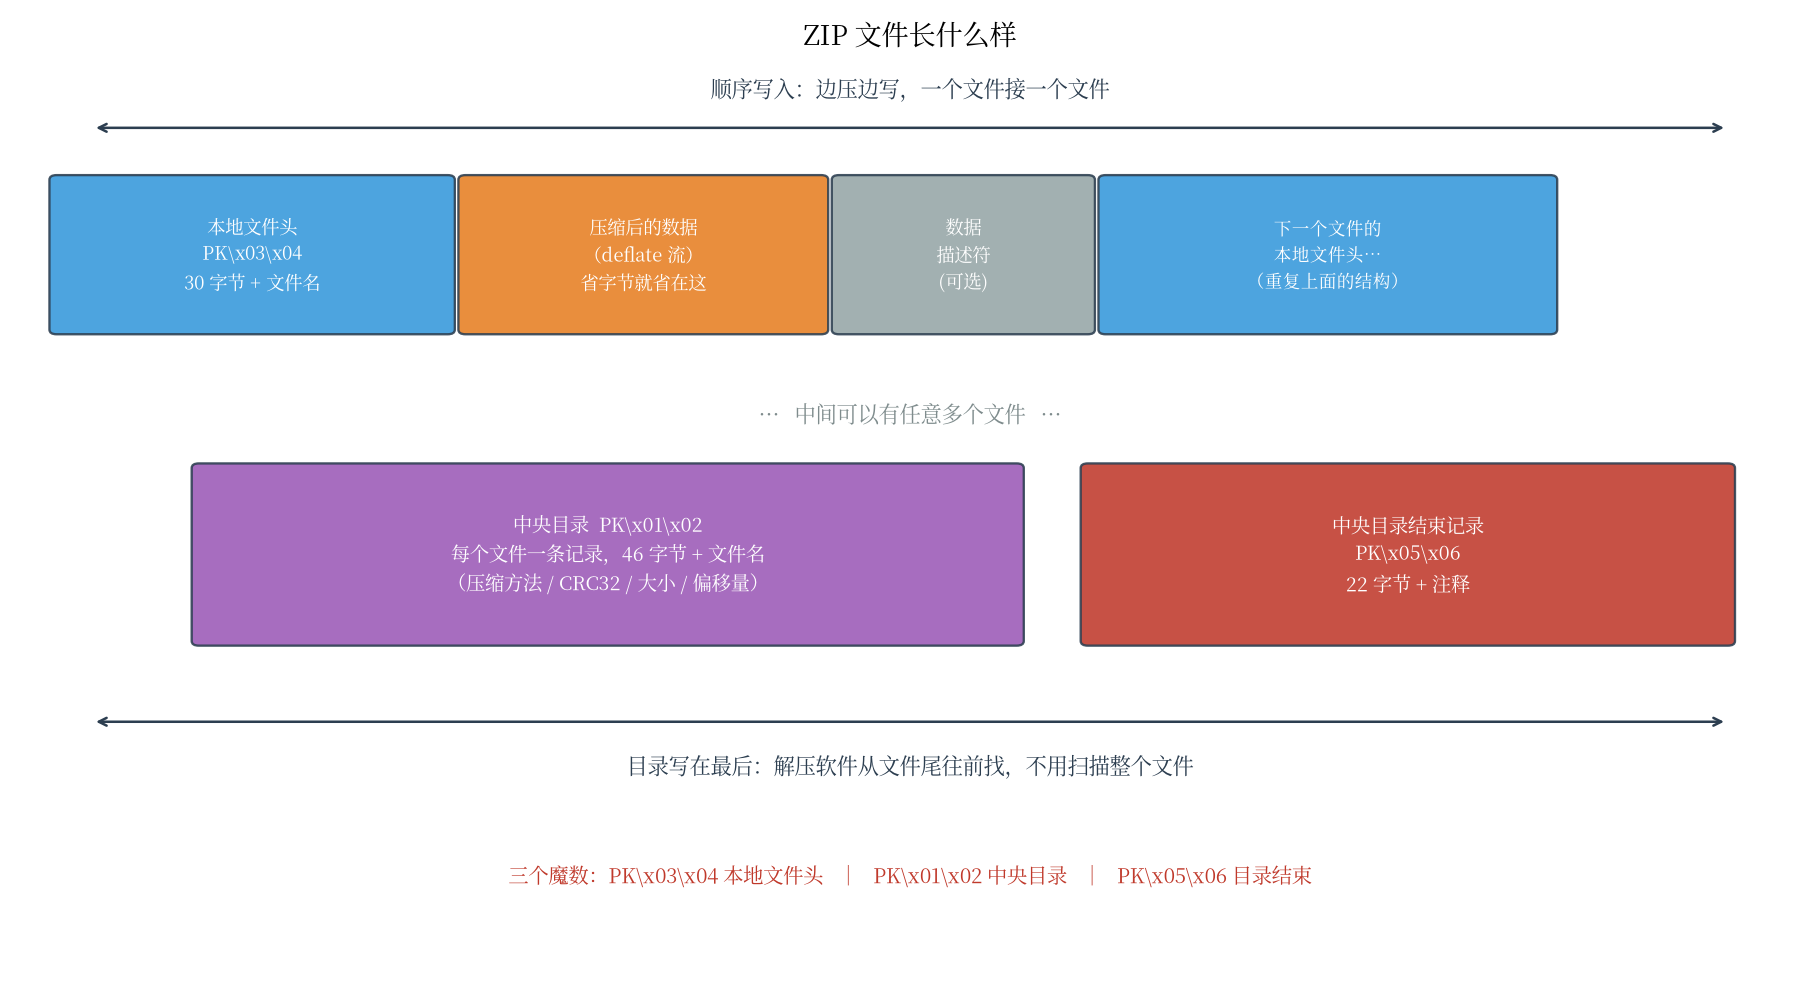
从左到右,重复出现的是本地文件头 + 压缩数据的组合,每加一个文件就重复一组。真正的目录信息不在开头,而是攒在文件最后面,叫做中央目录。
三个关键位置各有一个魔数(magic number),也就是固定字节序列:
1 | PK\x03\x04 本地文件头,每个文件一个 |
PK 是 Phil Katz 的缩写,ZIP 格式的发明者。他把自己的名字缩写塞进了每个 ZIP 文件的第一个字节里,这个签名就这么流传了四十年。
我实际造了一个最小的 ZIP,只放一个 hello.txt,内容是 "Hello, ZIP! " 重复 20 遍,一共 240 字节。整个 ZIP 文件 133 字节,十六进制长这样:
1 | 0000 50 4b 03 04 14 00 00 00 08 00 f3 2a 4e 5d 27 70 PK.........*N]'p |
一段段读:
开头 50 4b 03 04 就是 PK\x03\x04,本地文件头。
14 00 是版本号,00 00 是标志位,08 00 是压缩方法(8 代表 deflate),后面 f3 2a 4e 5d 是修改时间戳,27 70 7a 7e 是 CRC32 校验值。
再后面 11 00 00 00 是压缩后大小,17 字节。f0 00 00 00 是原始大小,240 字节。240 字节压到 17 字节,比例 14:1。09 00 是文件名长度,9 个字节,跟着就是 hello.txt。
然后是压缩数据本身,从 f3 48 cd c9... 开始。直到偏移 0x36 附近,出现 50 4b 01 02,中央目录开始了。
注意中央目录里存的是什么:压缩方法、CRC、压缩前后大小、文件名长度、以及本地文件头在文件中的偏移量。这些信息在本地文件头里已经出现过了,中央目录里又存了一份。
重复存两次,是故意的。 本地头是在写入数据前就得先写好的,那时候压缩还没完成,所以压缩后大小和 CRC 只能先占位、后面再回头补(或者在数据后面追加一个”数据描述符”)。而中央目录是最后写的,所有值都已经确定。解压软件打开文件时直接跳到文件尾部读中央目录,就能拿到完整目录,不用从头扫描整个文件。
这个设计还有一个后果:中央目录的偏移量是从文件开头算的。所以如果你在 ZIP 文件前面拼接一段数据,很多软件的中央目录偏移就对不上了,ZIP 会被”破坏”。这也是为什么 ZIP 有一个”自解压包”变种(前面拼一段可执行程序)需要特殊处理偏移。
ZIP 结构还有一点值得说:每条目录项和每个文件头都是”长度前缀 + 可变长字段”,是顺序解析的格式,不是定长结构。这种设计写起来方便、扩展起来方便(后来的 ZIP64 就是靠加新字段扩展的),但解析时必须严格按长度跳,跳错一个字节后面全乱。
二、什么是压缩
现在讲压缩本身。压缩这个词有误导性,它让人以为文件里”少了一些东西”。
实际上,压缩一个字节的信息都没丢(无损压缩的情况下)。变的是表示方式,不是内容。
有个特别直接的例子。假设你要记录一串抛硬币结果,正面写 H,反面写 T,抛 100 次:
1 | HHTHHTTTHTHTTHHHTTHHTTTTH... |
一个字符一个字节,100 字节。
但如果你数出来正面 52 次、反面 48 次,你完全可以用另一句话描述它:抛 100 次,正面 52 次,反面的位置是第 3、6、7、8……
两种说法描述的是同一件事,第二种明显更短,因为它利用了”硬币有规律”这件事。压缩做的就是这件事:找出数据里的规律,然后用更短的写法把规律表达出来。
关键在于,压缩赚的钱全部来自”规律”。没有规律的数据,压缩无从下手。这就是第二个事实的来源。
用一个更精确的说法:压缩的本质是预测。一个好的压缩算法,是在给定前面已经出现的内容时,对下一个字节做出准确预测。预测得准,就只需要存”预测错了什么”,而不是”实际是什么”。ZIP 里用的 deflate 就是这么干的,下一节展开。
三、ZIP 为什么能让文件变小
ZIP 默认用的算法叫 deflate,它是两个老技术拼起来的:LZ77 找重复,Huffman 编码压缩。
第一步:LZ77,把重复换成”往回数几个,抄几个”
LZ77 的思路朴素得不像话:如果一段内容前面刚出现过,就别再存一遍,存一个”往回几个字节、复制多长”的指令就行。
我用十几行代码实现了一个迷你版 LZ77,让它处理这段字符串:
1 | ababababababababababcccccc |
26 个字符,它的输出是 5 个记号:
1 | [('字面', 'a'), ('字面', 'b'), ('复制', 2, 18), ('字面', 'c'), ('复制', 1, 5)] |
翻译一下:先直接写个 a,再直接写个 b,然后”往回数 2 个字符,复制 18 个”,于是剩下的 18 个 ab 全出来了。再写个 c,”往回数 1 个,复制 5 个”,五个 c 到位。
26 个字符,用 5 个记号描述完了。这就是压缩的全部魔术,剩下的是细节。
真实数据没有这么规整,但规律无处不在。一段中文里”的””了””是”反复出现,一段英文里 “the” 反复出现,一段 JSON 里每个对象的 key 都一样。LZ77 就是在这些地方省字节。
ZIP 里 LZ77 的滑动窗口大小是 32 KB(后来有各种扩展),意思是它只能”往回看 32 KB”找重复。超过 32 KB 之外的重复,它看不见。这个数字以后会变成一个关键点。
第二步:Huffman 编码,给常出现的东西发短码
LZ77 的输出是一堆字面字节和一堆(距离, 长度)对。这些东西也不是均匀分布的,有些值出现得特别多。
Huffman 编码的做法是:统计频率,出现得多的给短码,出现得少的给长码。
比如正常情况下一个字节要 8 位。如果某个值占了 30% 的出现次数,给它一个 2 位的短码,平均下来每个符号占用的位数就降下来了。
举个最极端的例子,一个只含四种字符的文件,理论上每个字符只需要 2 位,能压到 1/4。而一个 256 种字符均匀分布的文件,每个字符 8 位,一点都压不动。
Huffman 的天花板是”符号的出现频率”。LZ77 的天花板是”重复的长度和距离”。这两者叠加,就是 deflate 的能力边界。
用前面那个 ZIP 例子收个尾:hello.txt 的内容是 "Hello, ZIP! " 重复 20 遍,240 字节。LZ77 立刻看到这 12 个字符重复了 20 次,第一个记号是 12 个字节的字面量,后面 19 次全是”往回数 12 个,复制 12 个”。输出压缩到 17 字节。
240 字节里的信息量其实只有 12 个字节那么多,剩下的都是同一句话说了二十遍。压缩把这份啰嗦收走了。
四、压缩的地板:香农熵
到这里有个自然的问题:能压多小?有没有下限?
有,而且这个下限在 1948 年就被算出来了。香农提出一个量叫熵,衡量一段数据里每个符号平均携带多少信息:
其中 $p_i$ 是第 i 种符号出现的概率。
公式的意思是:一个符号如果几乎必然出现,它携带的信息就接近零(因为不需要告诉别人);一个符号如果完全随机,它携带的信息就多。所有符号的信息量按概率加权平均,就是熵。
香农的结论是:无损压缩的平均码长不可能低于熵。这是一个定理,不是一个经验规律。任何压缩算法,无论多聪明,都撞不破这堵墙。
熵的单位是 bit/符号。一个字节有 256 种可能,最大熵就是 $\log_2 256 = 8$ bit。
我测了几类数据的熵,和它们的实际压缩效果放在一起:
| 数据 | 原始 | gzip 后 | 熵 (bit/字节) |
|---|---|---|---|
| 全零数据 | 293.0 KB | 0.3 KB | 0.000 |
| 中文文本(重复段落) | 221.5 KB | 1.1 KB | 5.471 |
| 英文文本(重复段落) | 159.1 KB | 0.8 KB | 4.018 |
| JSON 结构化数据 | 100.8 KB | 6.9 KB | 4.354 |
| 源代码 | 23.0 KB | 3.8 KB | 5.946 |
| PNG 图片 | 10.6 KB | 4.5 KB | 6.518 |
| JPEG 图片 | 18.9 KB | 3.3 KB | 5.847 |
| 随机数据 | 293.0 KB | 293.1 KB | 7.999 |
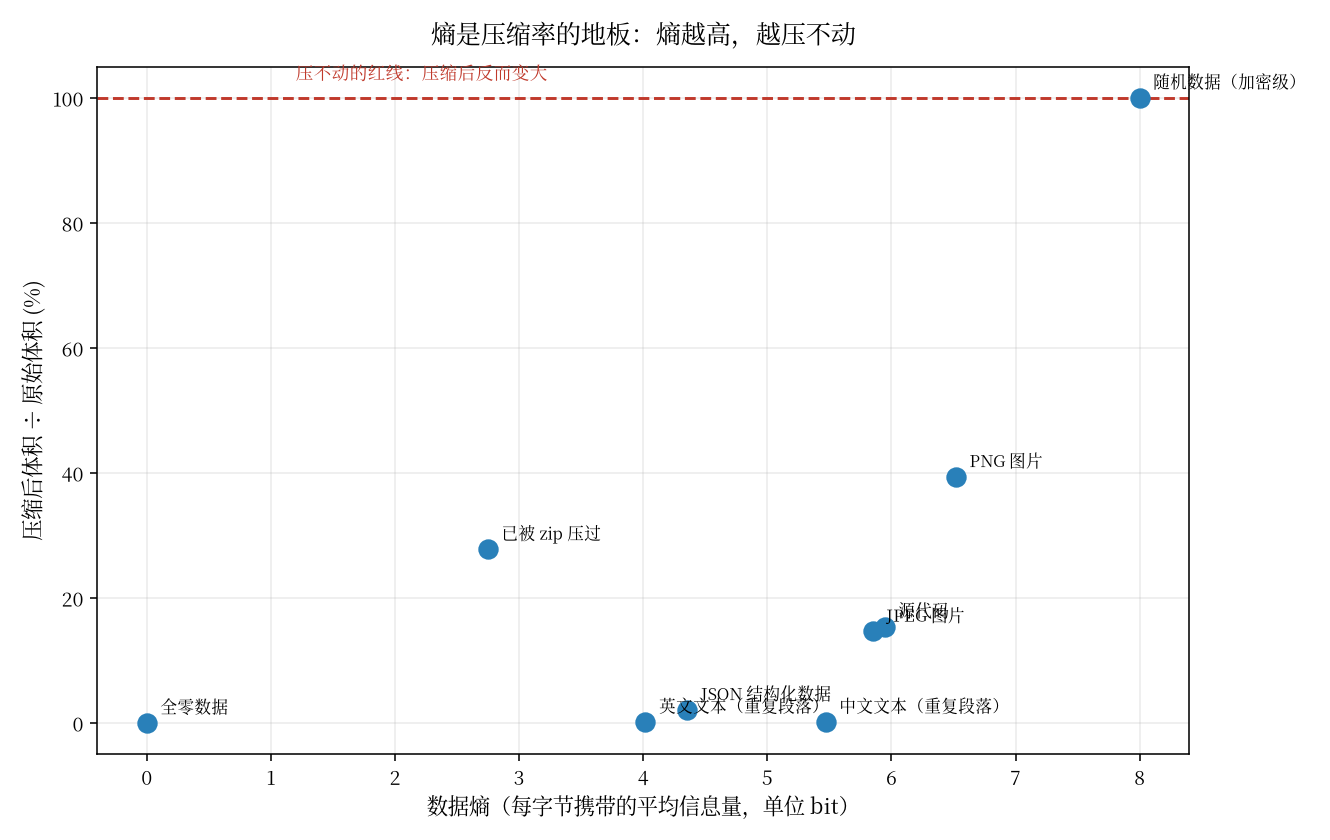
图二把熵和压缩率画在一起。横轴是熵,纵轴是压缩后体积占原始体积的百分比。点越往右,越压不动。全零数据(熵 0)压到千分之一,随机数据(熵 7.999)压完还多了两个字节,正好落在 100% 以上那条红线上方。
不过这里有个必须交代的技术细节,不交代就是骗人。
我算的这个熵是零阶熵,它只看单个字节出现的频率,完全不管字节的顺序。对于”重复了 900 遍同一段话”的中文文本,零阶熵给出 5.471 bit/字节,换算一下理论下限是 68%,但实测压到了 0.5%。差距巨大。
原因不难理解。那段文本真正的规律不在”哪些字节出现得多”,而在”下一段和上一段完全一样”。这种跨距离的重复,零阶熵看不见。
要衡量它,得用更高阶的模型:考虑字节之间的条件概率,或者考虑重复结构本身。阶数越高,估计越准,但计算也越贵。
所以准确的说法是:熵告诉你”在给定模型下还剩多少可压的空间”。模型越强,看到的规律越多,估出来的下限越低。而真实的信息量下限(那个算法无论如何都撞不破的)需要最理想的模型才能算出来。
零阶熵虽然粗糙,但方向是对的:全零数据熵为 0,怎么压都行;随机数据熵接近 8,谁都救不了。这两端它判得很准。
五、为什么有的文件压不动
现在可以回答第二个问题了。
压不动的原因只有一个:里面已经没有规律了。
随机数据是最典型的。我造了 293 KB 的真随机字节(os.urandom),它每个字节值都均匀分布,零阶熵 7.999,接近理论上限 8。任何压缩算法面对这种数据都无从下手,因为下一个字节和前面的字节没有任何关系。
压缩之后那 0.1 KB 是哪来的?是头部开销。gzip 带 18 字节头部,zip 还有本地文件头、中央目录、CRC,这些是固定的元数据。所以压随机数据的结果是变大。
这里有个常见说法需要改一下:”已经压过的文件就压不动了”。
这句话大体对,但不够准。看我测的数据:PNG 图片(本身就是 deflate 压过的)还能被 gzip 再压掉 57%,JPEG(有损压缩过的)还能再压 82%。看起来像是推翻了那句话。
不完全是。原因在于这两张图是我生成的渐变色,PNG 自身的 compress level 和块结构未必最优;PNG 内部有多个 IDAT 块、每块都有块头和对齐,这些结构本身有冗余;而 JPEG 里那段量化表、霍夫曼表,也是每个文件都一样的固定结构,gzip 一眼就能识别。
所以更准确的说法是:决定能不能压的,是”还有没有可利用的规律”,而不是”它是不是已经压过”。已经压过的文件通常规律被榨得比较干,所以一般压不动。但压缩算法不是完美的,它的输出里往往还残留着格式级的结构,二次压缩偶尔还能捡一点。捡到多少,取决于原格式留了多少余地。
这就引出了最有趣的一部分。
六、套娃为什么不管用
第三个问题:压了再压再压,会不会越压越小?
实测最直接。把那段 221 KB 的中文文本连续 gzip 五次:
1 | 原始 226,800 bytes |
用 ZIP 套 ZIP 再套五层:
1 | 原始 226,800 bytes |
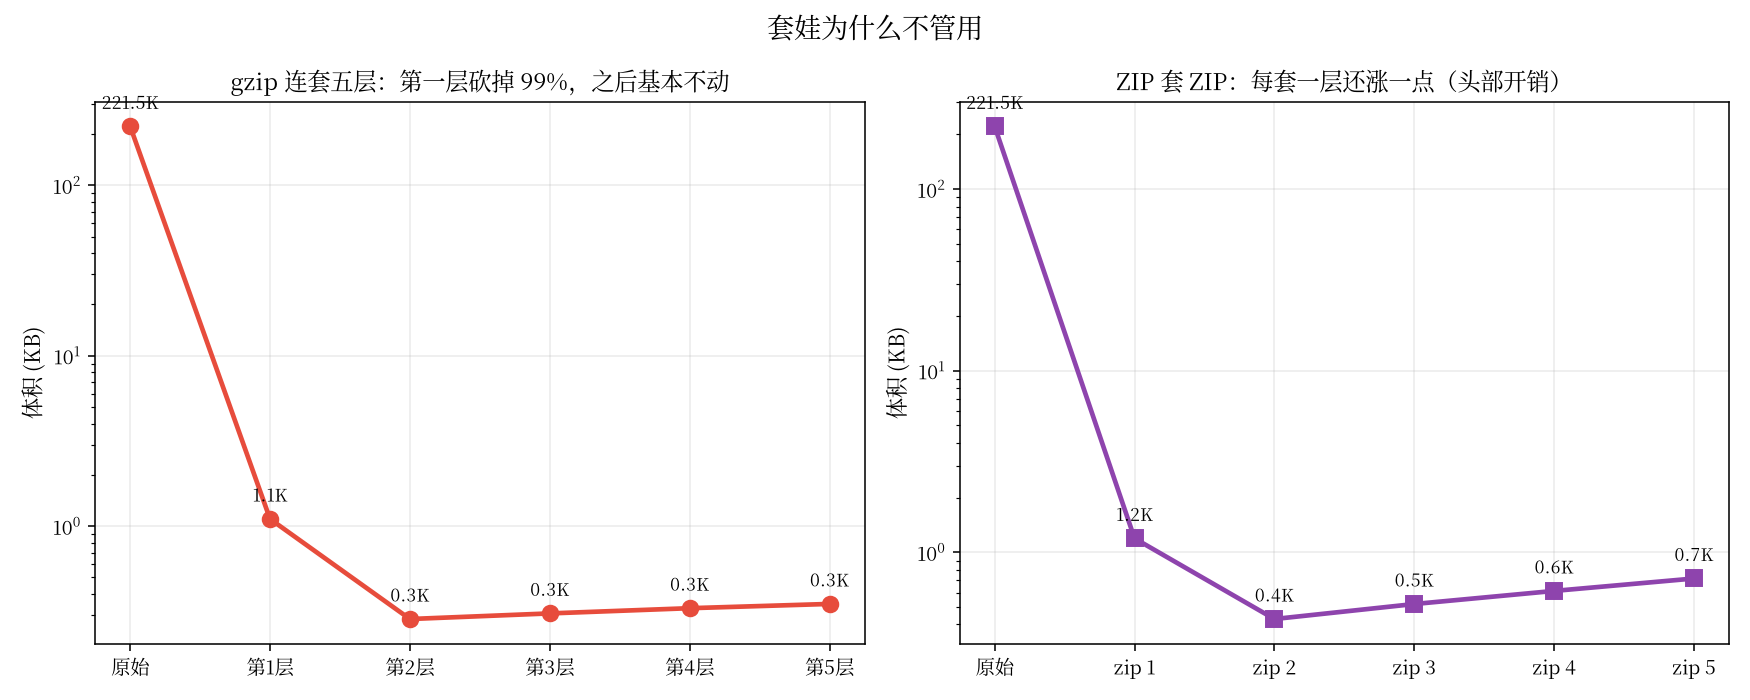
看清楚这个曲线。第一层砍掉了 99.5%,剩下 1.1 KB。
第二层居然还能再砍,砍到 292 字节。这个现象值得停下来想一下,因为它打破了很多人的直觉。
为什么第二层还能压?因为 deflate 的输出不是理论最优的。第一层用的滑动窗口只有 32 KB,而原始文本是 226 KB,里面有跨 32 KB 的重复它够不着。它输出的一串(距离, 长度)记号里,这些记号本身又形成了新的规律模式。第二层压缩面对的是”第一层输出的字节流”,它能看到一些第一层看不到的结构。
从第三层开始,曲线掉头向上:315、338、358,一路涨。
因为到了这个阶段,数据已经接近熵的下限了。里面剩下的规律少得可怜,压不动了,而每一层都会增加自己的头部开销。gzip 每层加 18 字节,ZIP 每层加几十字节的本地头加中央目录。压不动的同时还在往里塞元数据,于是净结果就是变大。
用一句话总结这个规律:每一层压缩都在”还剩下的规律”里捞最后一点油水。第一层捞走最多,第二层捞一点渣,第三层开始,你付的头部开销已经超过捞到的东西了。
再换个角度看。压缩是在做一笔交易:你用”计算时间 + 头部开销”换”体积缩小”。这笔交易在第一层几乎稳赚,因为原始数据里规律遍地都是。到了第三层,一次压缩要扫描整个文件、建 Huffman 表、输出各种头,而这些成本换来的收益接近零,交易就亏了。
所以那些”压个十遍文件就小到看不见了”的说法,纯属想象。
一个必须提的极端情况
刚才说每层都在缩小,这有个前提:内容真的在变小。
如果内容不缩小,而是反过来膨胀呢?
有一类文件叫 ZIP 炸弹,专门利用这一点。公开资料里最著名的是 42.zip,文件本身只有几十 KB,解压出来有几 PB。它的做法就是多层嵌套:每一层里放 16 个文件,每个文件又是下一层,层层相乘。因为它压的东西是全零数据(我实测全零数据熵为 0,能压到千分之一以下),每一层都能缩小十倍以上。
这就是那种典型的边界情况:平时看起来温良无害的机制,在极端参数下会变成攻击面。一个正常的压缩工具,遇到一个压缩比异常高的文件时,不应该直接按头部声明的原始大小去分配内存。这是解压软件的基本防御。
七、常用压缩算法与格式科普
无损压缩的几大家族
| 算法 | 出现在哪 | 特点 |
|---|---|---|
| DEFLATE | zip, gzip, PNG | 最通用的老将,速度和压缩率都中庸 |
| Bzip2 | .bz2 | 用 BWT 变换,压缩率优于 DEFLATE,慢、内存大 |
| LZMA / LZMA2 | .xz, 7z | 压缩率很高,慢,内存吃得凶 |
| Zstandard | .zst | 现代算法,速度接近 DEFLATE 而压缩率更好,可调 |
| Brotli | 网页 (br) | 内置一本常见词字典,专为文本优化 |
| LZ4 / Snappy | 数据库、日志 | 追求极致的速度,压缩率让位于吞吐 |
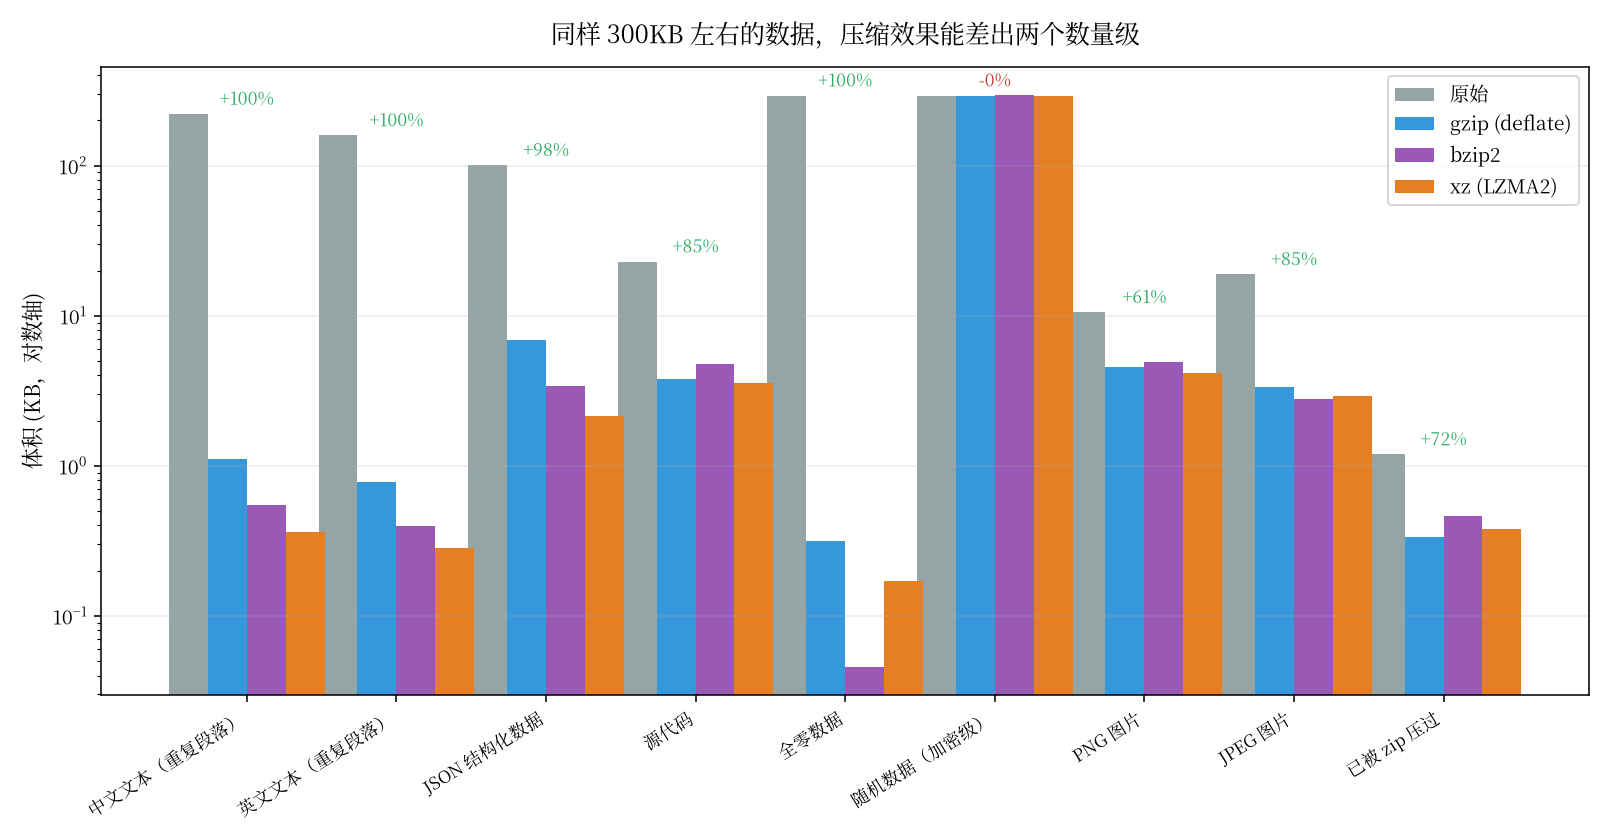
我实测了同一份数据在几种算法下的表现:
| 数据 | gzip | bzip2 | xz |
|---|---|---|---|
| 中文文本 221.5 KB | 1.1 KB | 0.5 KB | 0.4 KB |
| 英文文本 159.1 KB | 0.8 KB | 0.4 KB | 0.3 KB |
| JSON 100.8 KB | 6.9 KB | 3.4 KB | 2.1 KB |
| 源代码 23.0 KB | 3.8 KB | 4.8 KB | 3.5 KB |
| 随机数据 293.0 KB | 293.1 KB | 294.7 KB | 293.0 KB |
规律很清楚:压缩率上 xz > bzip2 > gzip,代价是速度。
但看源代码那一行。源文件只有 23 KB,bzip2 压出来 4.8 KB,反而比 gzip 的 3.8 KB 更大。
这不是 bzip2 算法差,是它吃亏在了块结构上。bzip2 会把数据切成块处理,每块有自己的头和变换开销,对短输入还没摊薄成本就先付了固定开支。大力士去搬一只蚂蚁,力气都花在热身上了。小文件用 gzip 通常比 bzip2 划算,就是这个道理。
有损压缩是另一回事
上面说的全都是无损压缩,解压后和原始数据一个字节都不差。
还有一类叫有损压缩,它会主动扔掉一些信息,换取大得多的压缩率。JPEG 就是这样:它把图像切成 8×8 的小块,做一次离散余弦变换,然后把高频细节(人眼不敏感的部分)粗略量化掉。丢掉的那些细节,你肉眼看不出来,但数据上确实没了。
音频的 MP3、视频的 H.264、以及新一代的 AVIF 和 AV1,都是这个路子,只是利用的是听觉和视觉的心理特性。
这是压缩能突破香农极限的唯一方式:改变游戏规则,不再要求”完全相同”。香农熵管的是无损压缩的下限,有损压缩不在这个坐标系里。
容器和算法是两件事
这是新手最容易混淆的地方,值得单独拎出来。
tar 只打包,不压缩。它把一堆文件首尾相接拼成一个大文件,加上每个文件的名字、权限、时间戳。拼完的文件通常比原来还大(多了那些元数据),但它把”很多小文件”变成了”一个大文件”。
gzip 只压缩,不打包。它处理一个字节流,输出一个字节流,不知道什么叫”文件名”。
所以要归档一堆文件,得两步:先 tar,再 gzip,得到 .tar.gz。
zip 两件事都干,因为它的格式是专门为此设计的(中央目录里存文件名)。
这个区别在压缩率上能差多少?我拿 200 个内容相似的小文件测了一遍:
1 | 原始合计 55,490 bytes |
同样的数据,同样的算法,差出近十倍。
原因还是那个滑动窗口。每个小文件单独压缩时,算法只能看见这一个文件内部的重复。而每个文件里都有一段相同的中文段落,这段文字在 200 个文件里重复了 200 次,分头压的时候完全利用不上。打包成一个大文件后,第 2 个文件里的那段话和第 1 个文件的完全一样,LZ77 一句”往回数 3000 个字节,复制 150 个”就打发了。
打包和压缩是两个正交的维度,把”相关的数据放在一起”本身就是一种压缩手段。这就是 tar 存在的理由。
八、反过来想:什么时候不该压缩
前面全在讲压缩怎么有用,但芒格那句”反过来想”在这里同样适用。列一下压缩帮倒忙的情况:
数据本来就小。几十字节的配置文件压一下,头部固定开销比省下的还多。
数据已经接近随机。加密过的数据就是典型。加密的设计目标之一就是让输出不可预测(消除规律),这恰好也让它不可压缩。所以你不需要给加密文件加压缩,也不会成功。
要频繁随机读取。压缩文件要读取中间某个位置,得先解压前面全部内容(除非用支持随机访问的格式)。数据库和日志系统宁可少压一点,也要保证随机读的快。
要写入的流式数据。一边写一边压,一旦中间出错,整个流可能全废,而且没法回退修改前面的内容。
最重要的一条:压缩是在拿计算换空间。当空间不贵(今天的硬盘很便宜)而计算贵(CPU 时间、电量、延迟)的时候,这笔交易是亏的。很多系统默认关掉压缩,就是这个原因。
把这些和前面的收益放在一起看,压缩的决策其实很清楚:有规律可压、体积值得压、不需要随机访问、计算资源有余,这四个条件同时成立,压缩才划算。
九、回到那三个问题
为什么压缩能让文件变小?
因为文件里有规律。压缩算法找出这些规律(重复的内容、偏斜的符号频率),用更短的写法表达同一份内容。你损失的是”啰嗦”,不是”信息”。
为什么有的文件压不动?
因为它已经没规律可捡了。随机数据和加密数据每个字节都是独立均匀的,熵接近 8 bit/字节,压缩算法面对它无计可施,还要倒贴头部开销,所以压完变大。已经压过的文件(JPEG、PNG、MP4)接近这一类,但未必完全无规律,偶尔还能再挤出一点。
为什么套娃不管用?
因为第一层已经捞走了绝大部分油水,后面的每一层能捞到的越来越少,而每层都要新增自己的头部开销。收益递减,成本叠加,很快就开始亏。实测里 gzip 第二层还能从 1128 压到 292,第三层就掉头向上了。
这三件事其实是同一条规律的三种表现:压缩的收益来自规律,规律的多少决定压缩的空间,规律被榨干之后,任何额外的压缩动作都只是在增加开销。
十、自己动手
想真明白,跑一遍最快。用不到二十行代码就能全部复现:
1 | import gzip, os, io, zipfile |
如果只让你做一个实验,做第三个。看着那个数字先猛掉、然后回头上涨,比读十页论文都清楚。
十一、最后
压缩这件事有意思的地方在于,它的道理简单到一句话就能说完:把重复的东西写成一次,其他地方引用回去。但这句话往下挖,能挖出 LZ77 的滑动窗口、Huffman 的变长编码、BWT 的块变换、香农的熵下限、以及整个文件格式的设计取舍。
ZIP 格式里那个”目录写在文件最后”的设计,LZ77 里”只往回看 32 KB”的限制,bzip2 在小文件上的劣势,tar 和 gzip 分成两个工具,每一个都是具体的设计决策,每一个都有它要解决的问题,也都有它留下的遗憾。理解这些取舍,比记住”ZIP 能压缩文件”有用得多。
最后留一句给以后会踩的坑:压缩不是一种让文件变小的魔法,它是一种用计算换空间的交易。既然它是交易,就有划算和不划算的时候。看清这笔交易的两头,就知道什么时候该压,什么时候该算了。