时间复杂度与空间复杂度详解
时间复杂度与空间复杂度详解
时间复杂度和空间复杂度,是衡量算法效率的两个核心度量。下面从”数一数”这种最直观的方式讲起,给出大 O 的形式化定义,配上 C++ / Python 双版本代码、公式推导和三张图,中间点几个常见误区,也说说这篇讲不到的地方。
这两天在教一个小孩子学习算法,用一种简单的思维讲解时间复杂度和空间复杂度。
一、先别管名字,来数一数
假设你妹妹让你帮她在书包里找一本作业本。
书包里有 3 本本子的时候,你抓两下就找到了,用了 2 秒。
书包里有 30 本本子的时候,你要翻一会儿,用了 20 秒。
书包里有 300 本本子的时候,你翻了两个小时。
现在我问你一个问题,“找本子”这件事,到底”有多快”?
你可能会说:”2 秒。”
错。2 秒是书包里有 3 本时的答案。 本子变成 300 本,答案就变成了两个小时。
所以真正要问的,是下面这句话。
本子每多一倍,我要多用多少时间?
这就是”复杂度”这个词真正在问的东西。它不关心你跑得多快,关心的是东西变多了以后,你变慢的速度有多快。
我觉得这是理解复杂度的唯一入口。如果你记住了 O(n²) 这四个字符,但不知道它在问这个,那你只是在背咒语——飞机不会因为机场修得像飞机场就降落。
二、大 O:一种”只留主干”的写法
我妹妹真正找本子的动作是这样的:
1 | 翻开第 1 本 → 不是 |
一共翻了 n 次。(n 就是本子的数量。)
如果每翻一本要花 0.1 秒,还要先花 2 秒拉开书包拉链,那总时间是:
翻本子的力气(
0.1n)是主角,拉开书包拉链那两秒(+2)是个跑龙套的。
现在把 n 取几个数:
| n(本子数) | 0.1n | +2 | 总时间 |
|---|---|---|---|
| 10 | 1 | 2 | 3 |
| 100 | 10 | 2 | 12 |
| 1000 | 100 | 2 | 102 |
| 10000 | 1000 | 2 | 1002 |
看最后一列,n 从 100 涨到 10000(100 倍),总时间从 12 涨到 1002,涨了大约 83 倍。
再看 0.1n 这一项,12 里它占 10,1002 里它占 1000。它一直是主角。 而那个 +2(拉链的时间)在 n 很小的时候还有点存在感,n 一大就完全不算数了。
这就是大 O 的全部秘密。
当 n 变得很大很大时,只留下涨得最凶的那一项,把前面的系数和后面加的小尾巴都扔掉。
写成数学语言,就是:
这就像报身高,1.83 米报成 1.8 米,没人跟你较真那 3 厘米;报成 2 米,那就要吵一架了。
更严谨一点,大 O 的定义是:存在两个正常数 $c$ 和 $n_0$,使得对所有 $n \ge n_0$ 都有
就是「不管你怎么跑,我这条线永远压在你头上」。大 O 是一根天花板,它不保证贴得多近,只保证你撞不穿。
这时我们就写 $T(n) = O(f(n))$。翻译成人话就是,
“从某个 n 开始,它的增长速度不会超过 f(n) 的某个倍数。”
注意这里我用了”增长”和”不超过”,大 O 说的是一根上限,不是一个精确值。 它天生就是个偷懒的写法,而且这个偷懒是第一流的。因为当 n 足够大时,你根本不需要知道精确值,你只需要知道它在怎么涨。
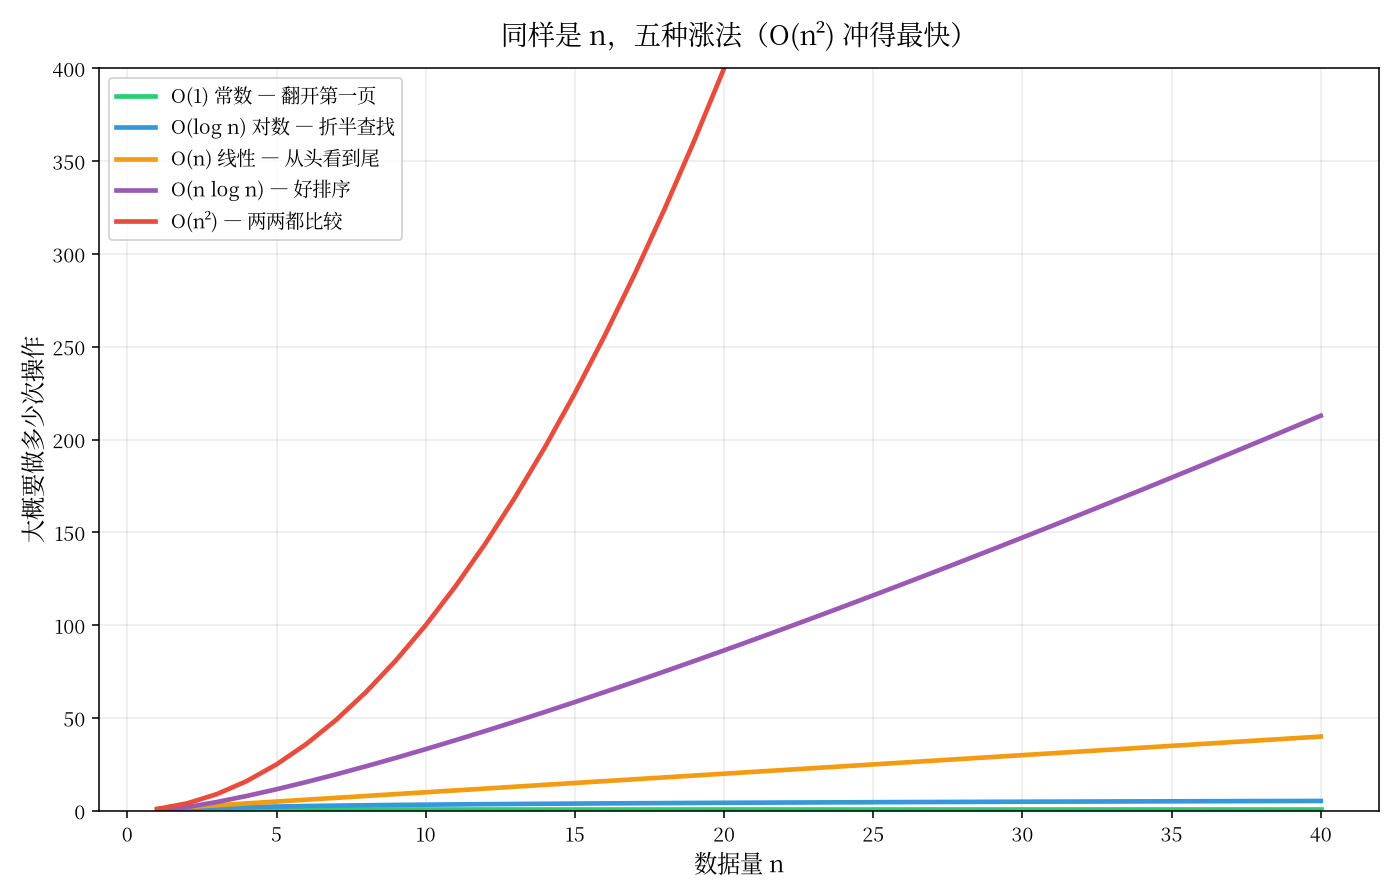
三、五种涨法(图一)
把最常见的那几种”涨法”画出来,你会一眼看懂为什么计算机老师总在念叨它们:
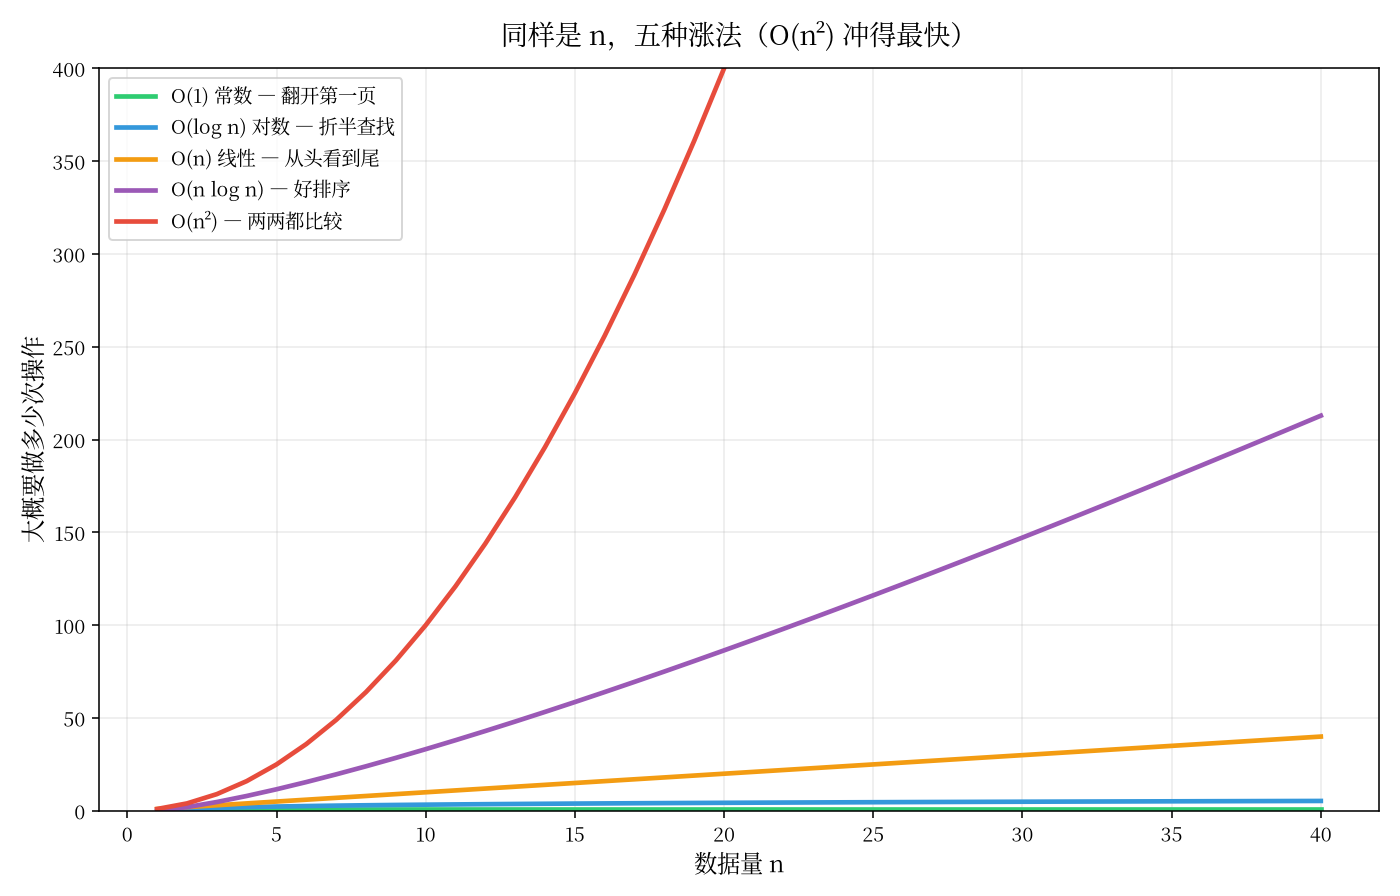
图一,横轴是数据量 n,纵轴是要做的操作次数。注意红色那条 O(n²),它一开始很谦虚,到后面直接冲上天。
我用找本子来翻译这五条:
| 记号 | 名字 | 找本子的版本 |
|---|---|---|
| $O(1)$ | 常数 | 本子就在你手上,不用找 |
| $O(\log n)$ | 对数 | 每次翻到中间,直接砍掉一半 |
| $O(n)$ | 线性 | 一本一本翻 |
| $O(n\log n)$ | 线性对数 | 先分成小堆再整理(好排序的做法) |
| $O(n^2)$ | 平方 | 每两本都要互相比一遍 |
这里有个特别容易搞混的点。你一定会听到有人说”$O(n)$ 比 $O(n^2)$ 快”,这句话不完全对。
它准确的说法是,当 n 足够大的时候,$O(n)$ 才一定比 $O(n^2)$ 快。 n 小的时候,一条 O(n²) 的代码完全可能跑赢一条 O(n) 的代码,只要它每条指令写得更精简。
看图二你就明白了。同一份代码,n=8 的时候两条线几乎贴在一起,你根本看不出谁好谁坏;n=60 的时候,一个上一个冲天。
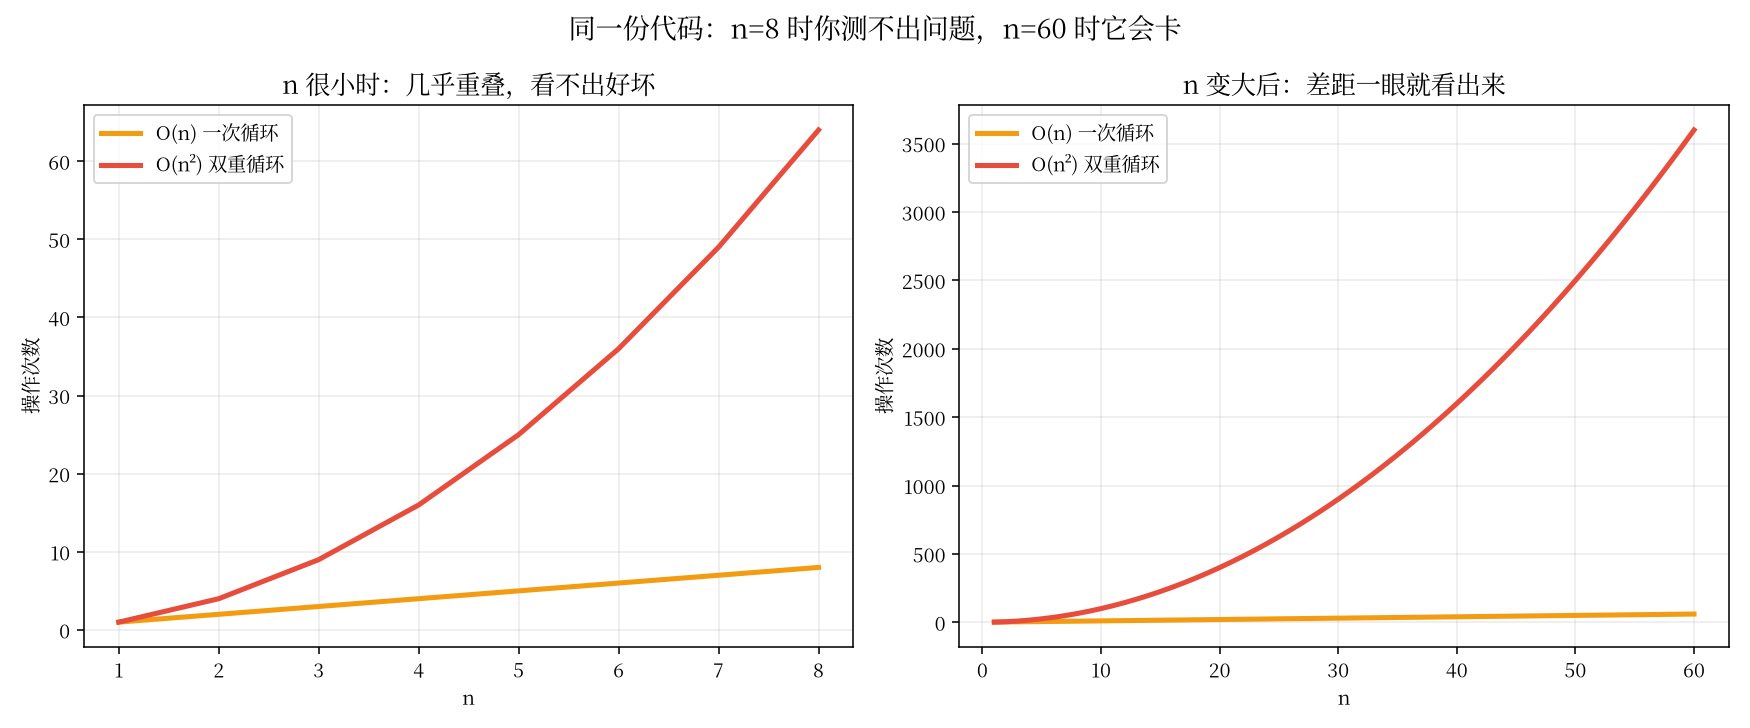
这是我见过的、最值得记住的一件事:如果数据不够大,你测出来的快慢可能是假的。
我是做工程的人,对这种事特别敏感——实验做得不对,数据就会骗你,而且它骗得特别自然,让你觉得你懂了。
四、例子一:找人($O(n)$ 对上 $O(\log n)$)
现在上代码。同一件事,我们写两种做法。
做法 A:一本一本翻($O(n)$)
1 | # Python |
1 | // C++ —— 同一件事 |
最坏情况下要看 n 次。所以:
做法 B:每次砍掉一半($O(\log n)$)
但是,如果名单是排好序的(比如按拼音排好),你就能干一件聪明得离谱的事。
先翻中间那本。
- 如果中间这本的拼音在你找的名字前面,那你要找的肯定在后半边,前边一半整块扔掉。
- 如果在后面,后边一半扔掉。
每翻一次,名单就少一半。
1 | # Python |
1 | // C++ —— 同一件事 |
为什么是 $\log$?我们来推一下。n 本本子,每次砍一半:
像剥洋葱,每次把剩下的对半撕。只不过这个洋葱剥 20 层就没了——哪怕它有 100 万片。
砍了几次?设砍了 k 次:
这就是 log 的来历。「我要撕几次才能把这一摞纸撕成一张?」答案给出来就是 $\log_2 n$。所以撕 100 万张纸只要 20 下,因为纸是成摞撕的。
所以:
log 是复杂度里的「温柔型选手」,数据翻一倍,它只多干一趟活。
这两个差多远?我给你算个实在数。一本 100 万条的名单:
- 做法 A:最坏要找 1,000,000 次。
- 做法 B:$\log_2 1000000 \approx 20$ 次。
20 次。
我第一次算这个的时候是有点恼怒的。你想,你妹妹找本子找两个小时,你只消翻 20 下。就这么个”每次都从中间下手”的笨办法,把人家的两个小时变成了 20 下。这不是什么高深技巧,无非是换了个问法,不问”下一个在哪儿”,问”它可能在左半边还是右半边”。
这就是我一直在说的事。不懂的东西你没法简单地说出来,等你真能简单地说出来了,你会发现它本来就很朴素。
(顺便:C++ 标准库的 std::binary_search、Python 的 bisect 模块,干的就是这件事。别人已经写好了,你直接叫即可。)
五、例子二:两两都比较($O(n^2)$),以及它为什么可怕
给你一个名单,问你:谁和谁同名?
最笨的做法,是让每个人跟其他每个人都比一遍:
1 | # Python |
1 | // C++ —— 同一件事 |
为什么会变成 n²?因为这是两层循环:外层跑 n 次,每跑一次内层又跑 n 次。乘起来:
两层循环不神秘,就是「每个人挨个跟所有人握手」,握手次数 = 人数 × 人数。人一多,握到手软。
看图二右边那条红色曲线,那就是它。
为什么我说它可怕?拿数字说话:
| n(人数) | n²(比较次数) | 假设每次比较 1 微秒 |
|---|---|---|
| 100 | 10,000 | 0.01 秒(没感觉) |
| 1,000 | 1,000,000 | 1 秒(还行) |
| 10,000 | 100,000,000 | 100 秒(你开始眨眼) |
| 100,000 | 10,000,000,000 | 2.8 小时(你可以睡一觉) |
注意这个感觉,n 变 1000 倍,时间变 1,000,000 倍。这就是平方的恐怖之处,它慢得越来越离谱。
所以我让你记住一句话:
一个 $O(n^2)$ 的算法能不能用,不取决于你的电脑有多好,取决于 n 会不会长大。
电脑快 4 倍,你只能扛住 n 翻一倍。而现实里的数据,往往不止翻一倍。
六、例子三:排序,以及为什么好的排序是 $n\log n$
排序的朴素做法是:每次从剩下的里面挑一个最小的放前面(选择排序)。挑一个要扫一遍,扫 n 次:
挑出最小的放前面,每挑一次都得把剩下的人全体扫一遍。你这不是在排序,你是在点名,而且每挑一个都重新点一次名。
而聪明做法(归并排序、快速排序)的核心思想是:先把问题切一半,解决两个小问题,再拼起来。
「把活儿劈成两半干($2T(n/2)$),干完再花点力气粘回去($O(n)$)」,分治的哲学就这一句,会分活儿的人不吃亏。
这个式子的意思是一行一行读出来:
- $T(n)$:排 n 个数要花的时间;
- 右边:分成两个 n/2 的问题(两个 $T(n/2)$),
- 再花 O(n) 把它们拼回一起。
解这个式子(一层层展开,得到 $\log n$ 层,每层总共 O(n)):
听起来很唬人,其实只是「n 个东西,每个花 $\log n$ 步就找到自己的位置」。这是排序界的天花板。
对比一下(还是 100 万条):
| 算法 | 操作次数 | 大致倍数 |
|---|---|---|
| $O(n^2)$ 选择排序 | $10^{12}$ | 1 |
| $O(n\log n)$ 归并排序 | $2 \times 10^{7}$ | 约 1/50000 |
这就是为什么全世界的库函数里,排序都不用”挑最小”那种笨办法。 这跟学术洁癖没关系,差的是 5 万倍。
七、空间复杂度:不光要能跑,还要占得住
到这里我们一直在数时间。但还有另一半故事:它要占多大地方。
这个不难理解。你去搬东西:
- 时间=你跑了几趟;
- 空间=你要多大的仓库。
空间复杂度问的是同一类问题:
数据量 n 变大,占用的内存会涨多快?
看这段代码:
1 | # 空间 O(1):不管 n 多大,只多用一个格子 |
1 | // C++ —— 同样是 O(1) |
再看这个:
1 | # 空间 O(n):每次递归都新开一份 |
1 | // C++ —— 同样是 O(n) |
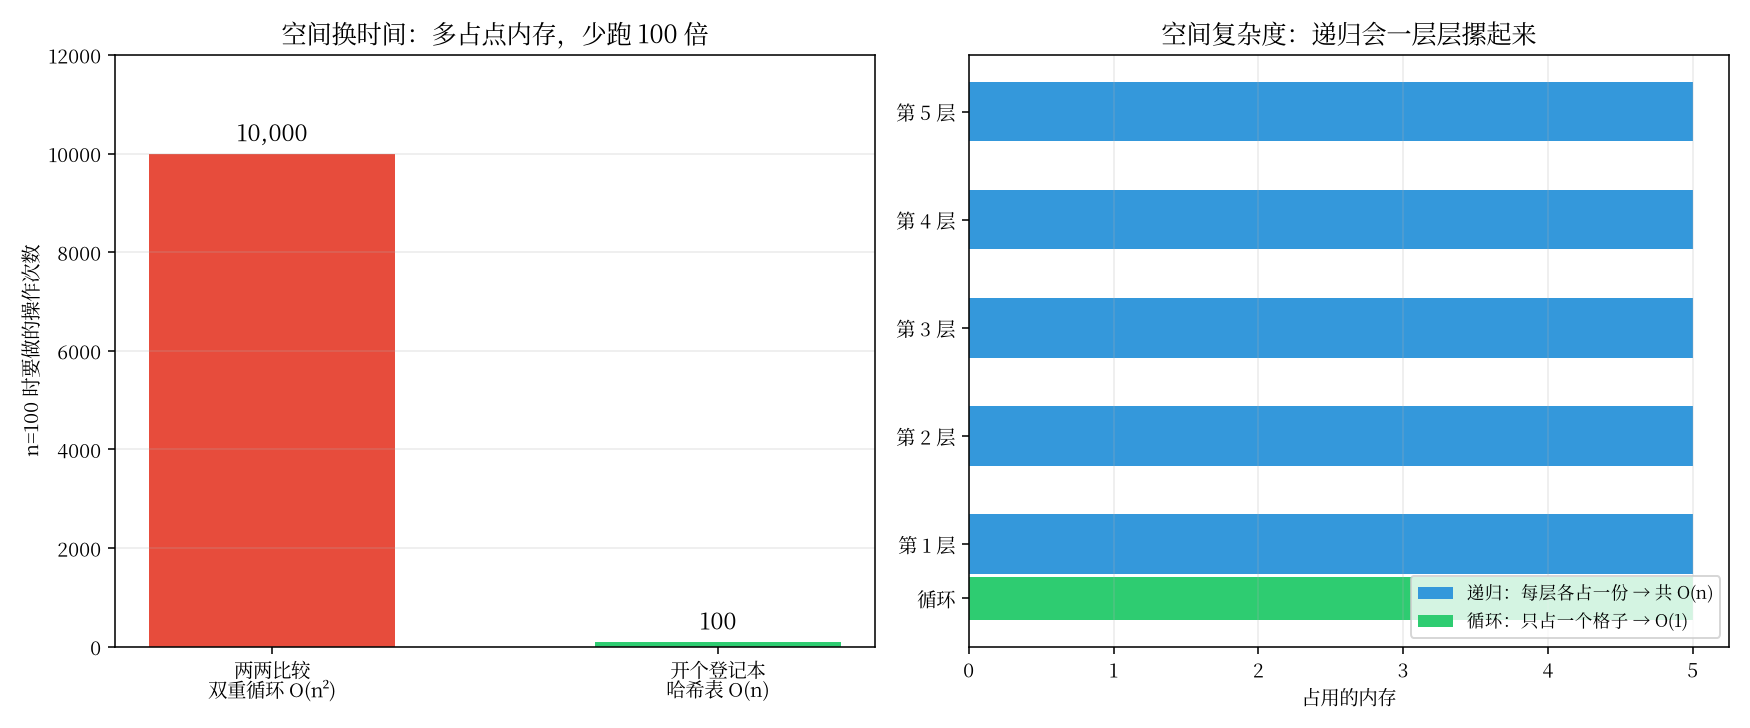
为什么递归是 O(n) 空间? 因为计算机执行递归,就像你打电话找人,每一层的人都在线上等着,谁都没挂。第 1 层调用第 2 层,第 2 层调用第 3 层……到第 n 层时,前面 n 层全都在内存里挂着。看图三右边,那摞起来的柱子就是这个意思。
一个我必须说实话的地方:这段 Python 里
列表[1:]还会额外复制一份新列表,所以它其实更浪费。真正的工程写法会用下标i往前挪(像上面那段 C++ 那样),避免复制。这算个挺好的教训,代码怎么写,直接决定复杂度。 我一开始举这个例子就是为了让你看见它。
八、最有用的那一招,空间换时间
如果你今天只带走一件事,带走这个。
回到第五节那个”两两比较找重名”。有没有办法不找死?
有。开个登记本。
1 | # 空间 O(n),时间 O(n) |
1 | // C++ —— 同一件事 |
我们干了什么?我们多花了一点内存(那个”登记本”),换来时间从 $O(n^2)$ 变成 $O(n)$。
n=100 时:从 10,000 次比较,变成 100 次。图三左边那两根柱子就是这个对比。
代价是:多占 O(n) 的内存来存登记本。
这是一笔交易。 时间和空间本来就是一对可以互换的东西,你几乎总是在拿一个换另一个。整个计算机科学里一半的工程技巧,说到底就是在做这笔买卖。
九、别骗自己:三个常见的自欺
这一段是我最想说的。因为复杂度这东西,特别容易让人假装懂了。
① “我测过了,它很快。”
看图二。n=8 的时候,$O(n^2)$ 和 $O(n)$ 的线是重合的。你用 8 个数据测,然后下结论说”我的代码没问题”,这在实验设计上就是个错误。你没测错,你只是测了一个不说明任何问题的东西。
② “我用了最新的库,所以肯定快。”
用了复杂算法库里最快的函数,不代表你的那段代码变快了。工具是形式,你的算法才是实质。去掉工具的名字,看你的代码在做什么,这才是真的。
③ “大 O 越大就越慢。”
不对,是”n 够大以后越慢”。$O(n^2)$ 的 C++ 代码跑赢一个 $O(n)$ 的 Python 代码,太正常了。大 O 比较的是自己和自己在不同 n 下的表现,不是两门语言打架。
十、我不知道的部分(以及它为什么不丢人)
我不想让这篇文章显得比它实际的样子更完整。有几个地方我要说清楚:
- 大 O 只是”上限”,它不管你平时的实际快慢。现实中还有”平均复杂度””最坏复杂度”的区别。快速排序最坏是 $O(n^2)$,但你天天在用它,因为它平均是 $O(n\log n)$,而且常数很小。“理论最坏”和”实际天天”完全是两回事。
- 常数真的会被忽略吗? 数学上会。工程上不会。一个常数是 1000 的 $O(n)$ 算法,在 n 小于某个数之前,跑不过一个常数是 1 的 $O(n^2)$。所以真实的程序里要”两个都写,小了用笨的、大了用聪明的”,这个技巧叫混合策略,Python 和 C++ 的排序里都藏着它。
- 内存的”快”不止一层。 你的 CPU 里有一层层的缓存(缓存比内存快几百倍)。两个复杂度一样的算法,谁把数据摆得更近,谁就真快。这部分(cache-oblivious、内存局部性)我不知道得足够深,就不装懂了。
- 我这篇文章里的所有时间估算(比如”1 微秒一次比较”)都是为了让你有感觉的随手假设,不是实测数据。真要看真实数字,你得自己在你的机器上跑一遍,而且要用足够大的 n。
最后一条我不知道,但我认为它比前面所有我知道的都重要:
“我不知道”不是终点。它是你唯一能站上去的地板。
十一、一句话,带走就行
如果你明天全忘了,只记得一句话,我希望是这句:
「东西变多了,你会怎么变慢」,这才是复杂度真正在问的。
再用一句话配上一个动作:
$O(1) < O(\log n) < O(n) < O(n\log n) < O(n^2)$
这条链背下来比背单词有用。但它有个前提,「n 足够大的时候」。不加这五个字,这条链就是耍流氓。
但顺序里那个”<”要加前缀:「n 足够大时」。
十二、自己试(别光看,看没用)
我最后想说:这篇文章你读完,你什么都没学会。
难不难先不说,光读不算学。要用上手,你得自己动手。给你三个练习,每个都只要几十行:
- 亲手做个实验:把第四节的两个查找函数各写一遍,n 取 1000、10000、100000,真的计时,把结果画成表格。
你会看到你的电脑”骗”了你多少次。 - 把 $O(n^2)$ 改成 $O(n)$:用第五节的”找重名”,先用双重循环,再用哈希表,n 取 10000,比较真实耗时。
你会第一次真切体会”空间换时间”不是一句口号。 - 把它讲给别人:找一个完全不懂编程的人,用找本子这个例子给他讲一遍二分查找,直到他问出”那为什么不一开始就翻中间”,到那一刻你就懂了。
如果你讲不清楚,别急着说自己笨。说不清楚的地方,正是你还没懂的地方。 这就是我全部的方法,没什么神秘的。