什么是均摊复杂度?均摊分析?
什么是均摊复杂度?均摊分析?
上篇文章里我们聊了复杂度和它那个偷懒的写法,大 O。这次聊一个更刁钻的问题。
你妹妹的书包又出场了。她每次往书包里塞一本作业本,就是一次操作。书包满了怎么办?只能换一个更大的书包,然后把旧书包里的本子一本一本倒进新书包。
现在问题来了:“往书包里放一本本子”这个操作,到底有多快?
- 平时:掀开盖子塞进去,一秒钟。
- 换书包那次:要把旧书包里所有本子全部倒过去,本子越多越慢。
如果只盯着最坏那一次,你会说:这个操作很慢,跟本子数量成正比。但如果盯着整个过程,你会发现换书包的次数少得可怜。
同一个操作,两个完全不同的答案。 均摊分析就是用来处理这种事的。
一、先说清楚:均摊不等于”平均”
这是我见过最多人搞错的地方,所以放在最前面。
听到”均摊”两个字,很多人立刻想到”平均”。然后就想:平均嘛,就是对所有情况取个平均。
不是这么回事。
平常说的”平均复杂度”,背后藏着一个概率假设。比如快排的平均复杂度是 $O(n\log n)$,这个”平均”的意思是:假定输入数据是随机排列的,在这种假定下取平均。如果对手故意构造一组最坏数据喂给你,快排立刻掉到 $O(n^2)$。
均摊复杂度不一样。它不需要任何概率假设,也不需要假定输入是随机的。它说的是:
连续做 n 次操作,总代价除以 n,是多少。
这个结论对任意操作序列都成立,包括最坏的那种序列。它不是”通常情况下的平均值”,它是”无论如何,摊到每一次头上都不会超过多少“。
一句话区分:
| 前提 | 结论适用于 | |
|---|---|---|
| 平均情况分析 | 需要对输入分布做概率假设 | 只在那套假设下成立 |
| 均摊分析 | 不需要任何假设 | 任意操作序列都成立 |
所以”均摊 O(1)”是一个非常硬的结论,比”平均 O(1)”硬得多。
二、动态数组:这件事的最好的例子
现在回到书包,我们把这件事写成代码。
Python 的 list 和 C++ 的 vector 都是动态数组。它们一开始分配一块固定的内存,你往里加元素,加满了,它们就悄悄做一件事:申请一块更大的内存,把老数据全部搬过去,再继续往新地方加。
1 | # Python:往里加元素 |
1 | // C++:同样的事 |
关键问题是:新内存申请多大?
如果每次只多申请一格,那就灾难了。每加一个元素都要搬一次家,搬 m 个元素要 m 步,做 n 次就是 $1+2+\dots+n = O(n^2)$。这时候 append 就真的变成 $O(n)$ 了,没人用得起。
实际的做法是倍增:满了就开两倍大。于是搬家发生的时机是第 1、2、4、8、16……次。
那么 n 次 append 一共搬了多少个元素?
这是一个等比数列求和。用初中就学过的方法:设
反过来写一遍:
两个式子相加,每一项都变成 $2 \times$ 对应的项,中间全部消掉:
所以搬运的总代价小于 $2n$。再加上 n 次插入本身:
这是均摊分析里最干净的一个推导,值得记住。 贵的操作不是消失了,是它们出现的次数足够少,少到可以被便宜的操作分摊掉。
三、实测:那些”偶尔很贵”的操作到底长什么样
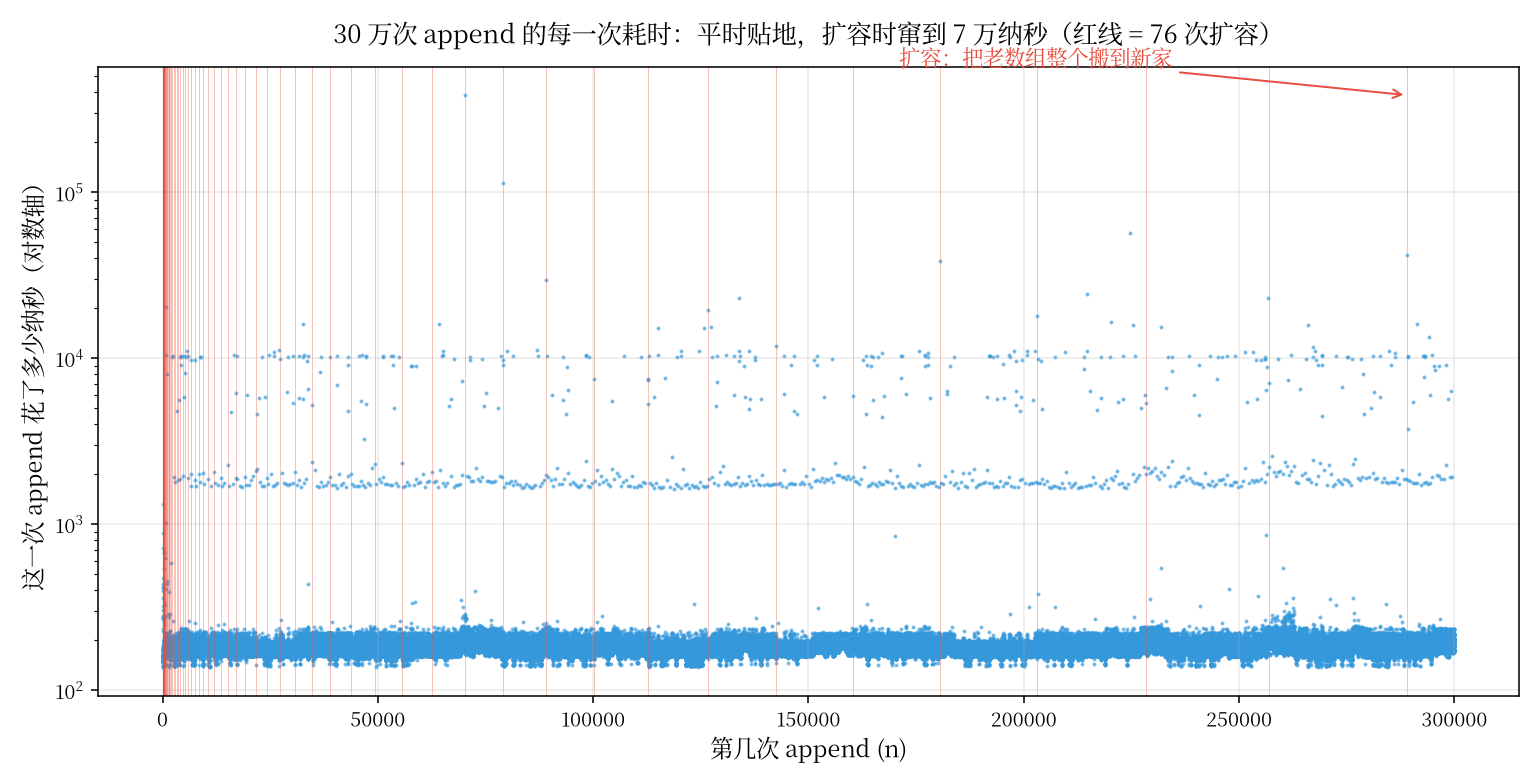
上面是数学。我更喜欢看真的东西,所以我在自己机器上跑了 30 万次 append,把每一次花的时间都记了下来。
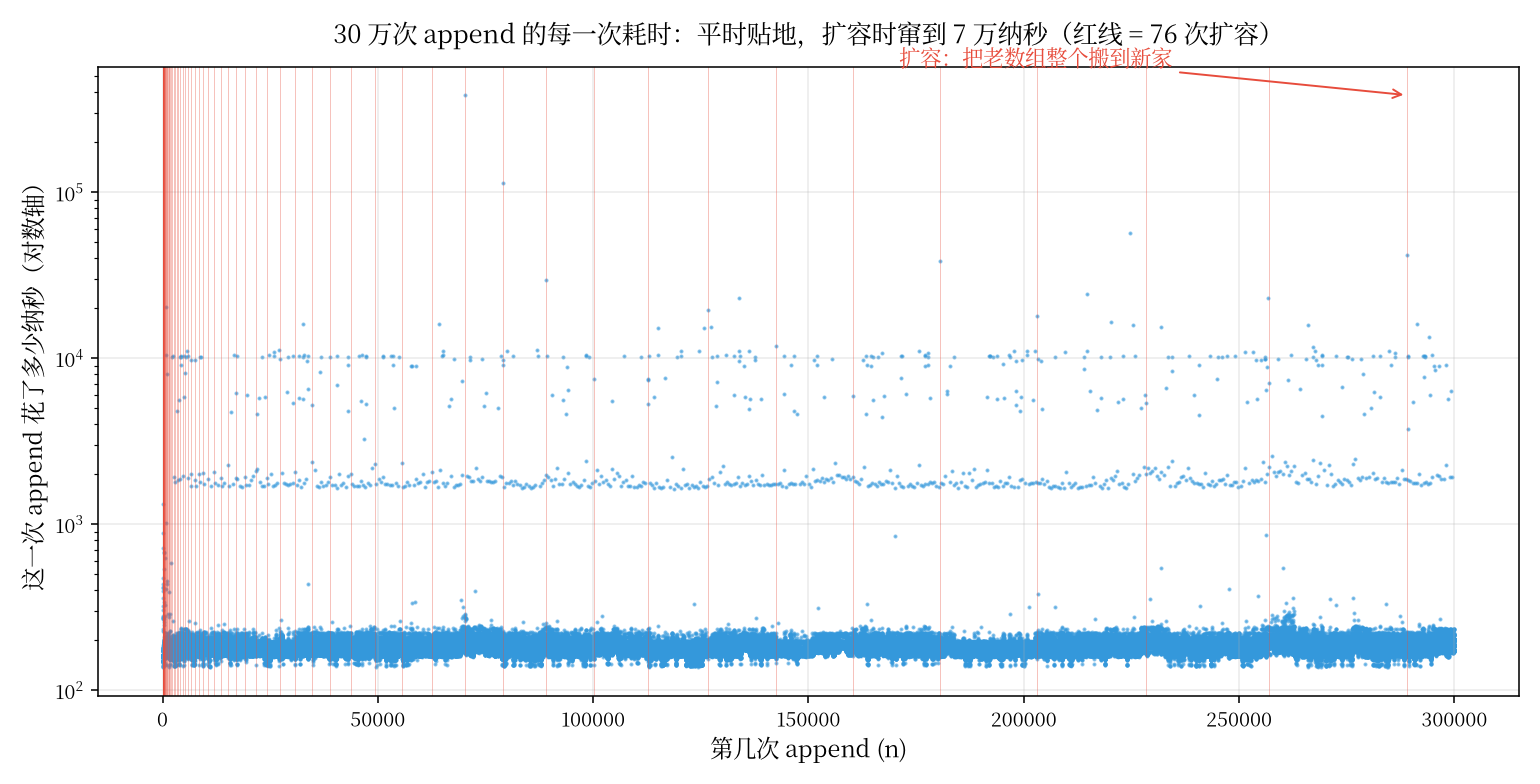
看图一。纵轴是对数刻度,也就是说每一格差 10 倍。绝大多数点趴在底下,那是一次普通的插入。红色的竖线是扩容的位置,一共 76 条。尖刺就是从这些线上窜起来的。
具体数字:
| 指标 | 数值 |
|---|---|
| 测试规模 | 300,000 次 append |
| 单次耗时中位数 | 156 纳秒 |
| 全程平均耗时 | 676 纳秒 |
| 最慢一次 | 74,269 纳秒 |
| 扩容次数 | 76 次(占全部操作的 0.0253%) |
注意中位数和平均差了 4 倍多。原因是那 76 次扩容(占总数的万分之二点五)非常贵,把平均值整个拉了起来。
现在关键的一步在这里:
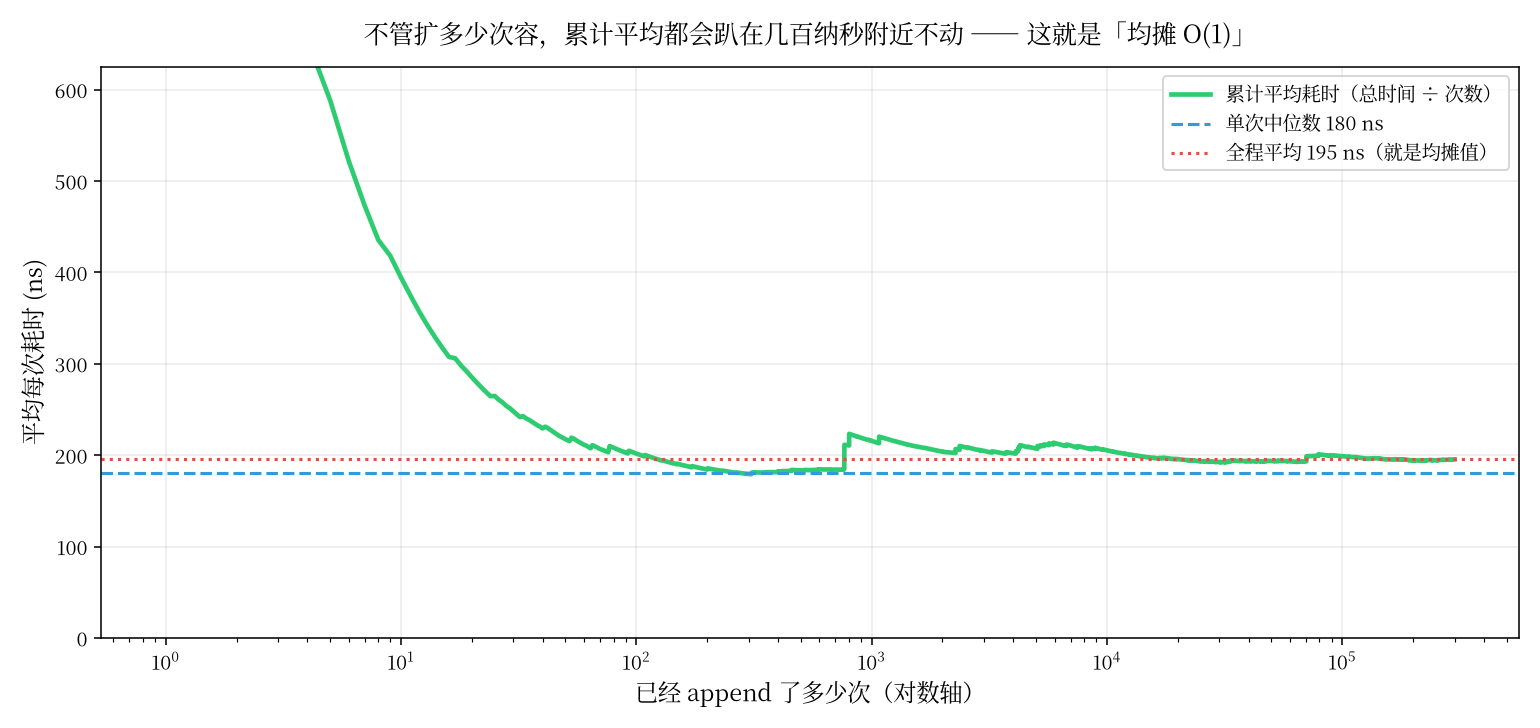
图二横轴是”已经 append 了多少次”(对数轴),纵轴是”到目前为止平均每次耗时”。你会看到这条线一开始剧烈波动,然后越来越稳,最后趴在 676 纳秒附近不动了。
这条平稳的线就是”均摊 O(1)”的真身。 它不是对某一次操作的预言,它是总账除以次数的结果。扩容还会不时发生,尖刺还会不时出现,但累计平均不会再涨上去。
我又用 C++ 的 std::vector 跑了一遍同样的规模:中位数 29 纳秒,平均 65 纳秒,最慢一次 722,283 纳秒。最慢比中位数慢了将近 25,000 倍。 这个倍数听着吓人,但它仍然是均摊 O(1),因为它在 30 万次里只出现了 20 次。
四、三种分析方法
均摊分析不是只有一种做法。教科书里讲了三种,我按好用的顺序说。
方法一:聚合法
就是上面做的那件事:先把 n 次操作的总代价算出来,再除以 n。
适合”整体好算、单次不好算”的情形。动态数组和二进制计数器都属于这一类。
方法二:记账法
这个方法最像生活。思路是:每次便宜操作的时候,多收一点钱存着;等到昂贵操作发生时,从存款里付。
拿 append 举例。假设每存一个元素收费 3 块:
- 1 块用来完成这次插入;
- 2 块存进一个”搬家基金”。
等到需要搬家时,要复制 m 个元素,花 m 块。而搬家基金里有多少钱?从上次搬家到现在,一共插入了 $m/2$ 个元素(因为容量翻倍),每个存 2 块:
正好够付。
这个推导里最漂亮的地方在于:我们不需要知道搬家什么时候发生,只需要保证存款始终够用。这就叫”用便宜的操作给贵操作预付”。
方法三:势能法
记账法很直白,但它有个弱点:你得凭直觉去设”收费多少”。势能法把这个直觉变成了公式。
定义一个函数 $\Phi$,叫势能,表示数据结构当前”存了多少没付的账”。第 i 次操作的均摊代价定义成:
其中 $c_i$ 是真实代价,$D_i$ 是第 i 次操作后的状态。
这一行读出来就是:均摊代价等于真实代价,加上这次操作为未来存下的账。
把 n 次加起来,中间的势能项会一路对消:
只要 $\Phi(D_n) \ge \Phi(D_0)$,就有 $\sum \hat{c}_i \ge \sum c_i$。也就是说,用均摊代价去估计总代价,只会高估,不会低估,这是安全的。
对动态数组,取 $\Phi = 2 \times \text{size} - \text{capacity}$(size 是元素数,capacity 是已分配的空间)。不扩容时,每次操作势能增加 2,均摊代价 $1 + 2 = 3$;扩容那一次,势能大幅下降,正好把真实代价抵消掉,均摊还是 3。
三种方法算出来的都是同一个数。聚合法最好懂,记账法最直观,势能法最通用,也最难看懂。工程上你几乎不会真的去写势能函数,但是读论文的时候会碰到它。
五、再练一个:二进制计数器
这是均摊分析的另一个标准例子,我拿它又跑了一次实测。
一个 $k$ 位的二进制计数器,从 0 开始,每次 +1。加的时候可能会有连锁进位,比如 7 变成 8:
这一下翻动了 4 位。看起来很贵。那么每次 +1 平均翻几位?
数一下:第 1 位每次 +1 都翻;第 2 位每 2 次翻一次;第 3 位每 4 次翻一次。所以 n 次自增的总翻转次数是:
均摊到每次:
我实测了 1 到 5000 的自增:平均每次翻转 2.00 位,最坏一次 13 位。
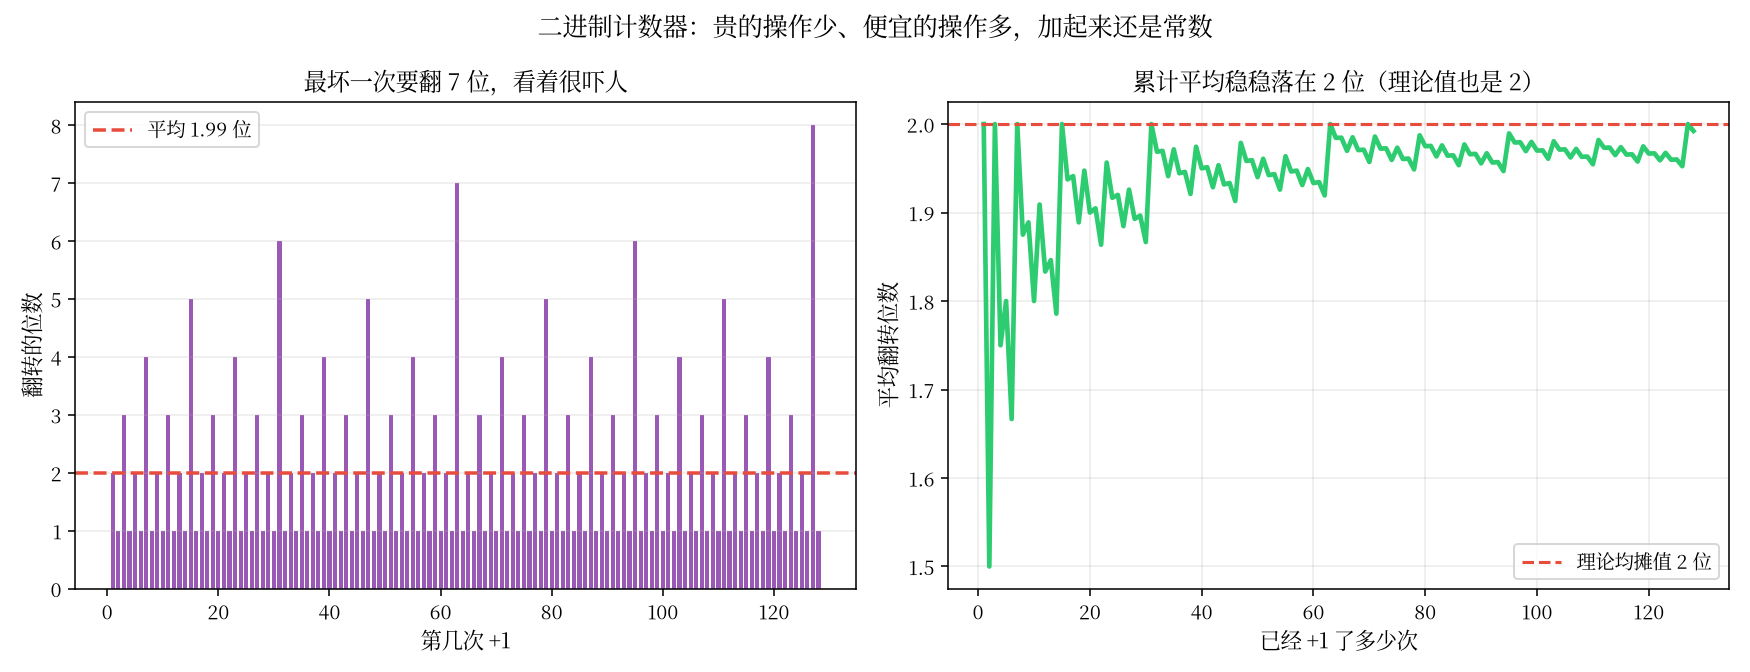
图三左边是每一次 +1 翻了几位,右边是累计平均。看右边那条绿线,它稳稳地落在 2 上,和理论值一模一样。左边那些高高低低的柱子(最坏 13 位)全都被平均掉了。
理论值 2,实测 2.00。这种对上号的感觉,比读十页证明都让人踏实。
六、均摊分析有个重要的限制,别用错地方
写到这里必须停一下,说个容易被忽略的事。
均摊 O(1) 不保证每一次都快。
它保证的是”总的账摊下来很便宜”,它对单次操作没有任何承诺。上面那个 C++ 测试里,有一次 append 花了 722 微秒,是从前一次的一万倍以上。均摊分析对此完全不否认,它只是说:这种破事很少发生。
所以在有些场景里,均摊结论不管用:
- 实时系统。 如果一个操作必须在 100 微秒内返回,那平均下来再便宜也没用。你碰上那一次 722 微秒的,就是事故。
- 延迟敏感的交互。 游戏、音视频编辑、交易撮合,用户能感觉到卡顿。偶发的长停顿会被直接投诉。
- 对最坏情况有硬性要求的算法。 比如某些安全协议要求严格的时间上界,你不敢用一个偶尔会抽风的操作。
这类场合需要的不是均摊保证,是最坏情况保证。有些数据结构专门做了这个取舍,比如用”每次搬一点、分散着搬”的办法(增量式 rehash、实时队列),代价通常是要维护更复杂的结构。
同一个结论,在不同的场景里价值完全不同。 判断一个结论能不能用,先看它对”最坏一次”作不作承诺。
七、工程里还有一堆均摊
均摊分析不是学术摆设,它是很多你天天在用的东西的基础。举几个:
- 哈希表扩容。 元素多了要扩大桶数组、重新分配所有元素。单次很贵,均摊之后插入还是 $O(1)$。Python 的
dict、C++ 的unordered_map、Java 的HashMap,背后都是这套。 - 并查集。 路径压缩加按秩合并,单次操作的最坏代价不好看,但均摊下来是 $O(\alpha(n))$。$\alpha$ 是反阿克曼函数,对任何现实中的 n 都不会超过 4。这是均摊分析里最著名的结果之一。
- 单调栈 / 单调队列。 每个元素最多进栈一次、出栈一次,所以整个过程是 $O(n)$,哪怕某一次操作会连着弹出一大堆。
- 伸展树。 单次操作可能是 $O(n)$,均摊是 $O(\log n)$。
- KMP 的失配跳转。 看着那个 while 循环会回退很多步,但整个匹配过程是线性的。
它们有个共同点:昂贵的动作不会凭空消失,但它的总次数被某个不变量卡住了。 找到那个不变量,就是均摊分析的全部工作。
八、我不知道的部分
有几个地方我不想装懂。
- 三种方法是等价的吗? 对同一份分析,它们给出的界是一样的,聚合法和记账法在数学上可以互相翻译。但具体到某个问题上用哪个更顺手,是经验问题,我承认我是靠试。
- 势能函数怎么找? 教科书教的是”定义成这个就对了”,但没人告诉你第一眼怎么猜出来。我的经验是:先看昂贵操作发生时,哪个量会突然变小,把它反过来当势能。这是技巧,不是方法。
- 这篇里的所有实测数据都来自我这台机器的一次运行。 不同机器、不同编译器、不同时刻,绝对值会差很多倍。但中位数和平均值之间那种数量级的差距,以及累计平均会收敛这件事,是稳定的,那才是均摊分析在说的东西。
九、一句话记住
均摊分析问的问题只有一句:
做 n 次操作,总账除以 n,是多少?
它跟”平均情况”最大的区别是:它不需要你假设输入长什么样。 这是它硬气的地方。
再用一句话配上一个动作:
路上偶尔有个坑,不代表这条路平均速度很差;
但如果你开的是救护车,你就得管那个坑到底有多深。
十、自己试
照旧,读是没用的。
- 亲手看见尖刺。 用 30 万次
append,把每一次的耗时记下来画散点图。你会亲眼看到那 76 根尖刺。 - 把倍增改成加一。 自己写一个”每次只多申请一格”的动态数组,跑同样规模,对比耗时。你会第一次真切感觉到:均摊 O(1) 不是白来的,是靠一个具体策略换来的。
- 算一个你自己的例子。 找一个你项目里”偶尔会慢”的操作,数一数它到底多久发生一次,用总代价除以总次数算一算。很多时候你会发现它根本不是问题,只是那一次很难看。
如果你算完发现它真的有问题,恭喜你,你已经学会均摊分析了。