飞秋(FeiQ)3.0.0.2 协议缺陷分析:设备名册伪造与消息缓冲残留
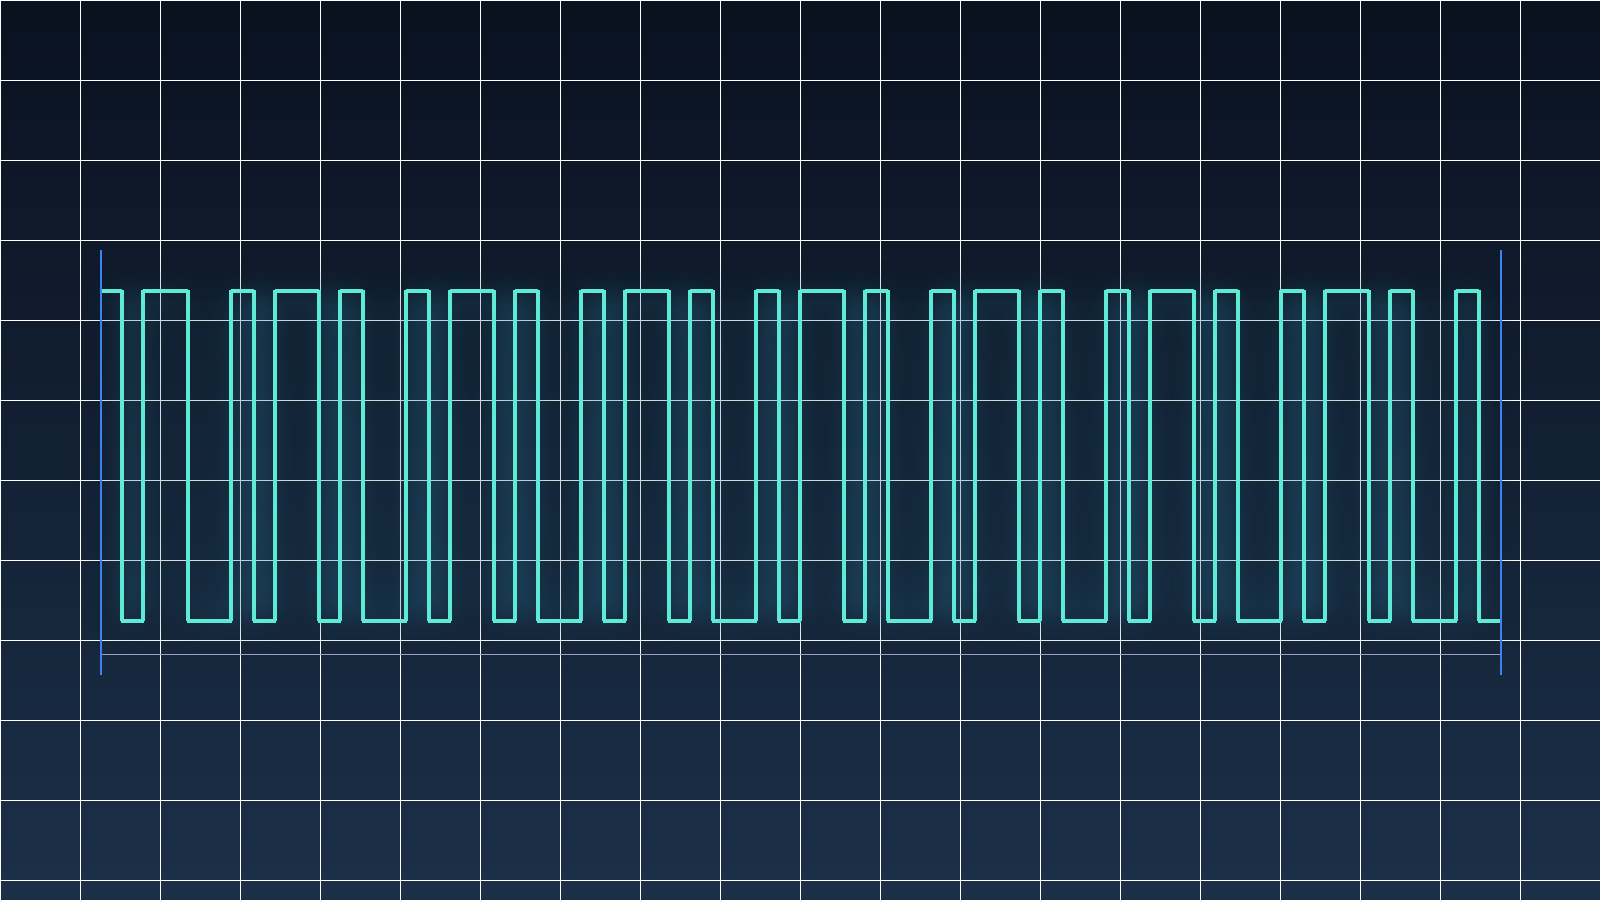
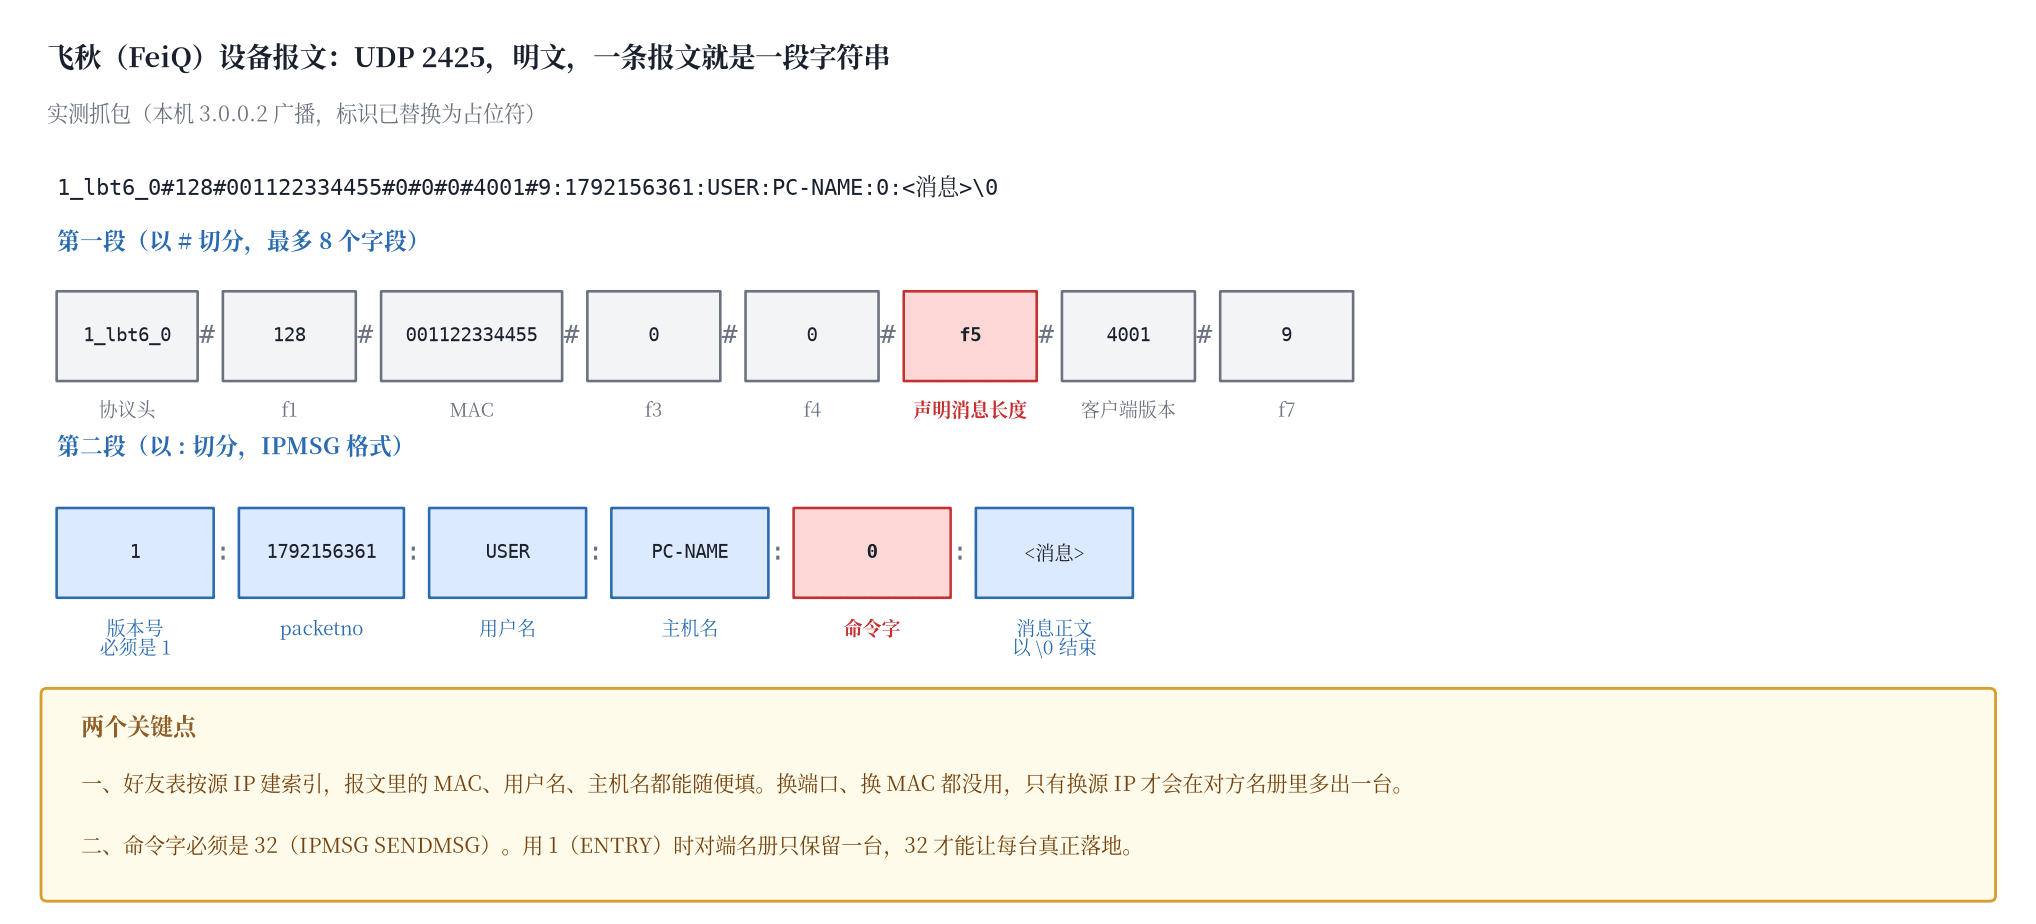
飞秋(FeiQ)是一款局域网即时通讯工具,在机房、教室和不少单位的内部办公网里还在使用。它装完即可使用,不需要服务器和账号,同一网段内的机器会自动出现在好友列表里,通信走 UDP 2425。 我最近对它的协议做了分析,并写了一个内网设备探测工具。分析过程中发现两个问题,一个在协议设计层面,一个在内存安全层面。本文记录协议还原的结果、两个问题的原理、实测数据和修复建议。 报文格式飞秋的协议没有公开文档,但与 IPMSG(IP Messenger)同源。抓取 3.0.0.2 广播的报文可以看到,一条报文就是一段可读字符串,字段之间用 # 和 : 分隔: 11_lbt6_0#128#001122334455#0#0#0#4001#9:1792156361:USER:PC-NAME:0:<消息>\0 报文分两段。# 之前是第一段,最多八个字段;: 之后是第二段,格式与 IPMSG 一致。字段含义见图一。 有两个字段需要单独说明。 f5 声明这条消息的字节数,第二个缺陷与它直接相关。 命令字必须填 32(IPMSG 中的 SENDMSG)。填 32 时对端会把你登记进名册并回...
用 Python 从零实现一个 SSH 蜜罐
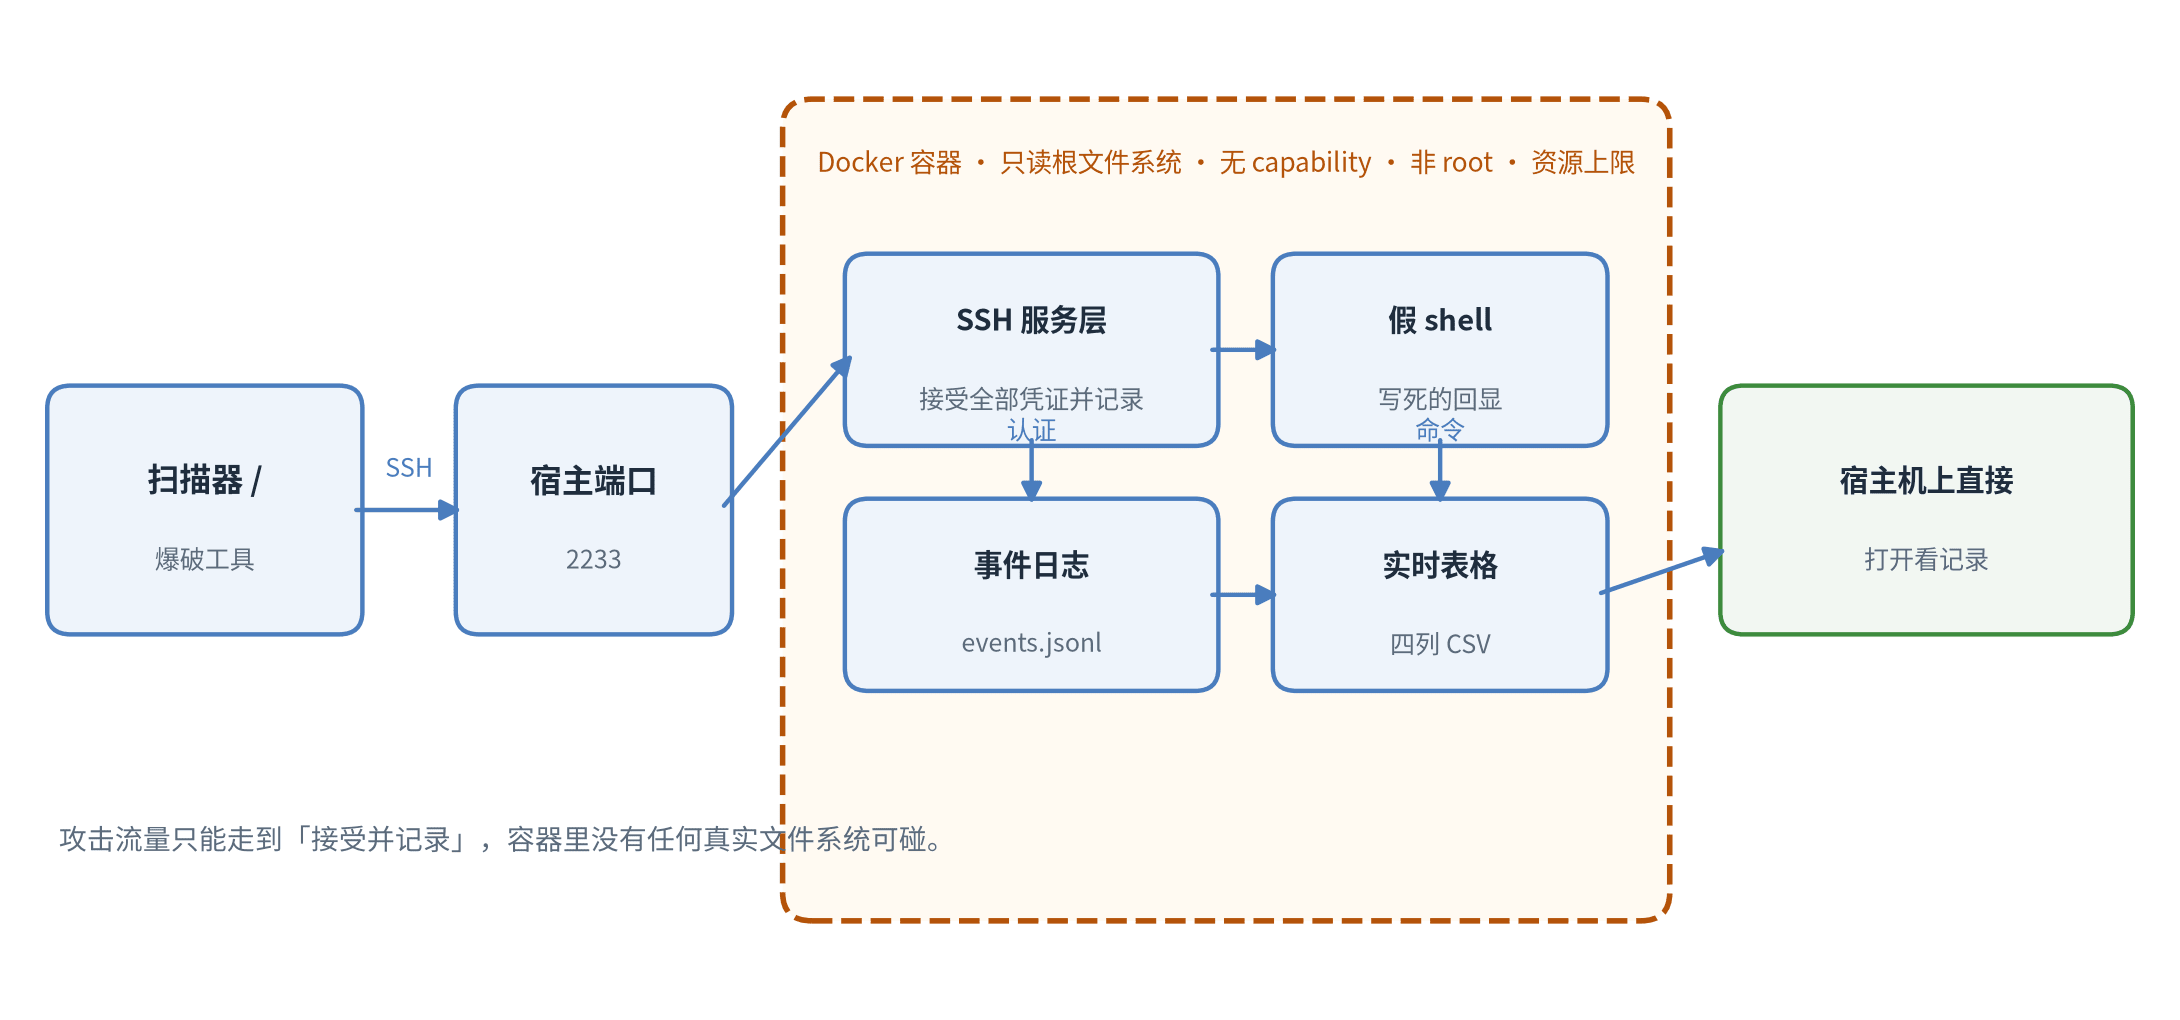
把一台机器的 SSH 端口放到公网上,过不了多久日志里就会开始有东西。半夜的登录失败、来自好几个国家的地址、每隔十几秒试一次。你不需要去惹谁,扫描器本来就在全网扫这个端口。 这些尝试绝大多数是无差别的,但里面有信息。它们猜哪些用户名、用什么口令、进去以后第一件事做什么。把这些记下来,比一条条翻 sshd 日志有意思得多。 这篇文章写一个能记这些东西的蜜罐。功能本身不复杂,值得花时间想清楚的是另外两件事:怎么保证它什么都不会真的执行,以及经过转发之后怎么把来源 IP 拿回来。 先定清楚要拿到什么三样是基本盘:用户名、口令、来源 IP。再加两样进阶的:登录成功后执行的命令、客户端的版本串。版本串能认出对方用的是什么工具,有时候比口令本身更能说明问题。 整个数据流是这样: 图一 蜜罐的组成与数据流。攻击流量进到容器里,能走的最远一步就是被记录。 一个反直觉的决定:口令一律放行正常的服务遇到错口令要拒绝,蜜罐反过来,全部接受。 原因在 SSH 的认证机制:一次连接只提交一组凭证。爆破工具的做法是连一次、试一组、断开、再连。所以两种策略拿到的数据完全不同。 一律拒绝的话,每次连接只能记下...
高并发 API 服务的瓶颈究竟在哪里:连接池、线程池、事件循环与背压
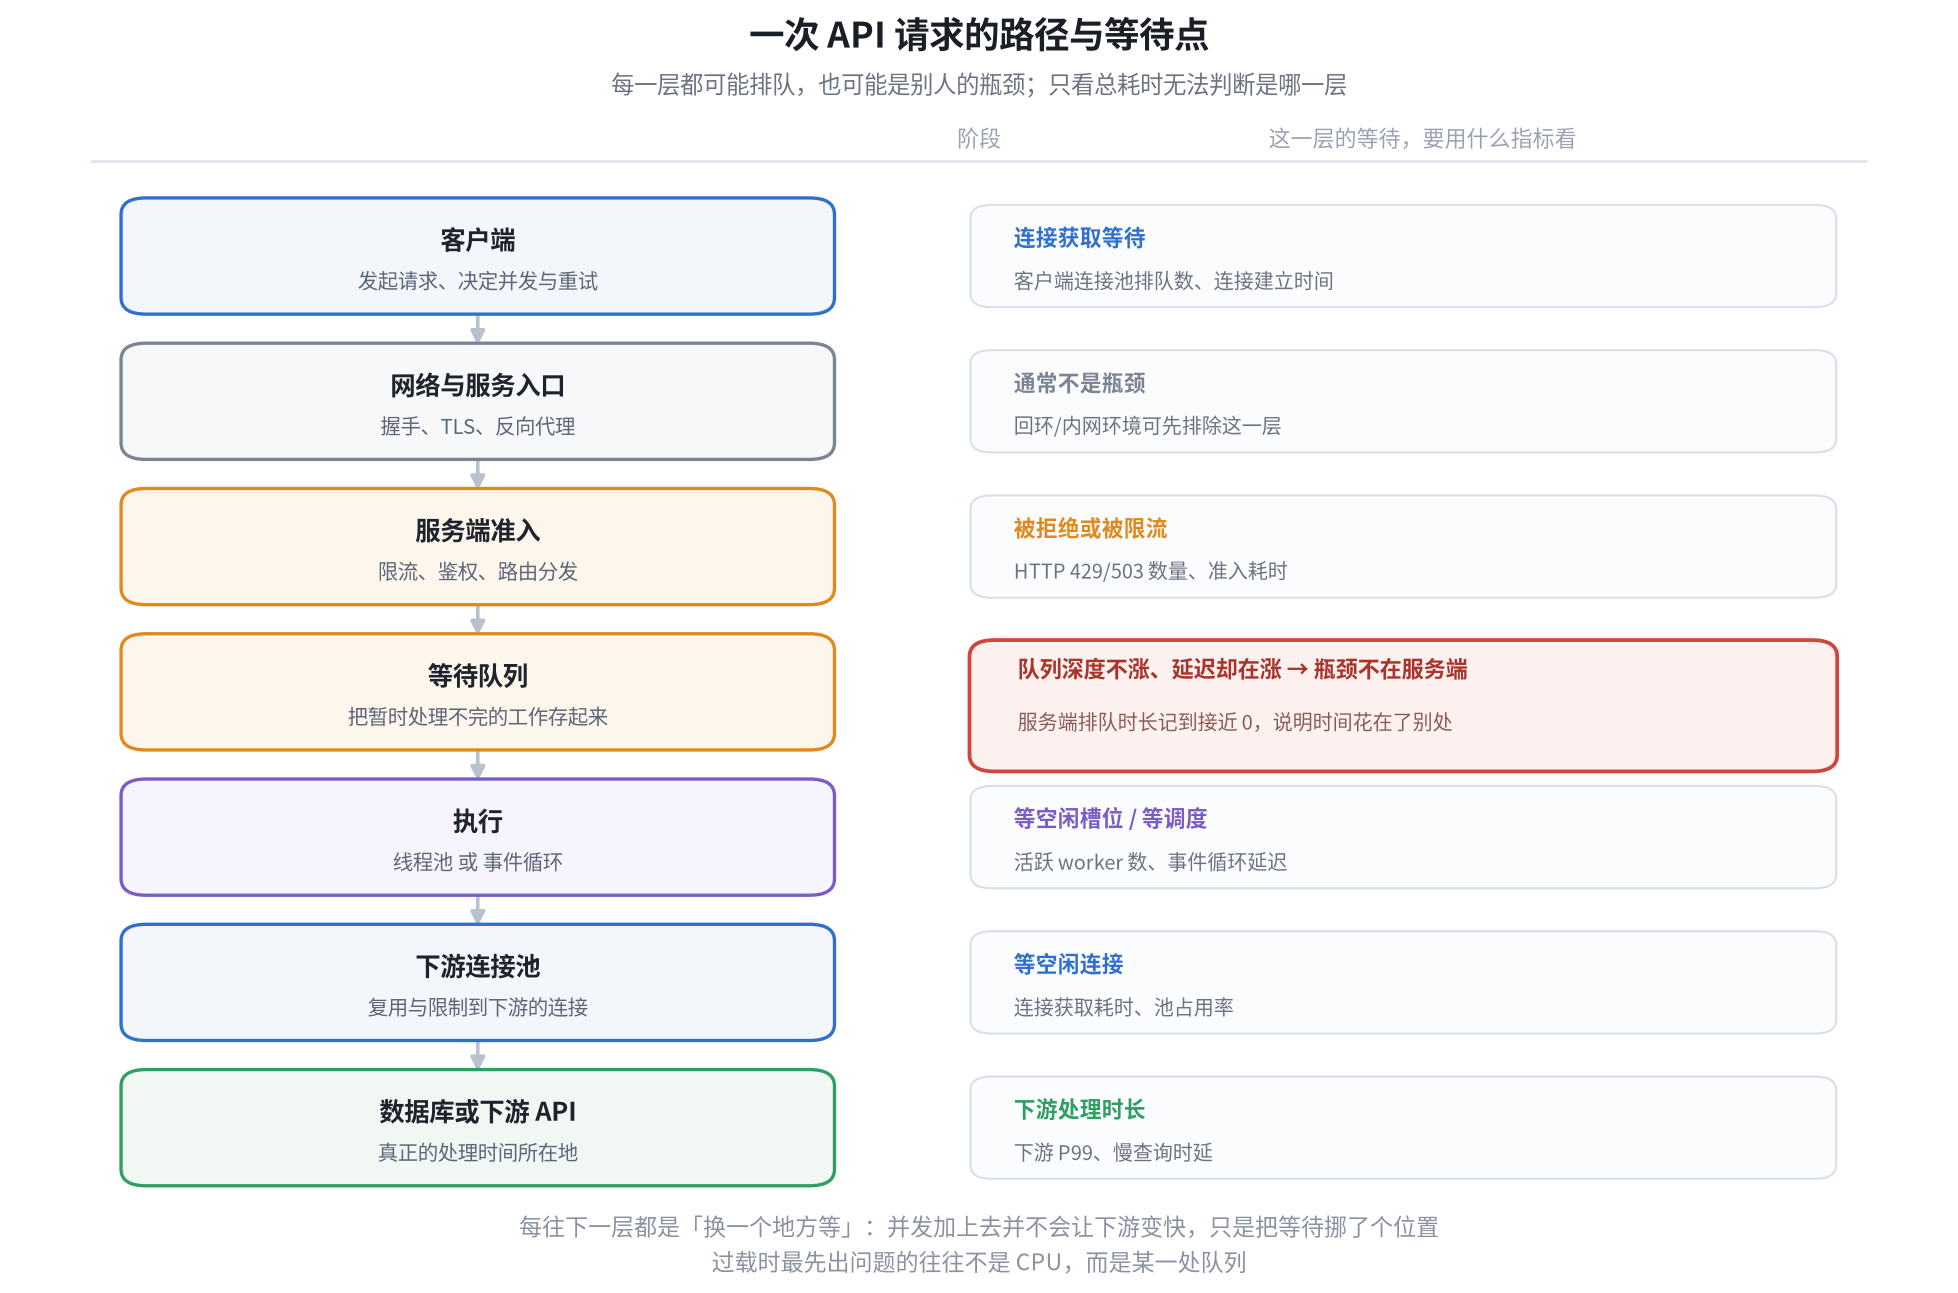
一个 API 服务在低负载下跑得好好的。请求量涨上来,吞吐量跟着涨;再涨,吞吐量不动了,P99 开始往上爬。继续加压,超时、连接池耗尽、503 接连出现。 这时候最自然的反应是去调参数:线程数加一点,连接池开大一点,事件循环换个更快的实现。这些调整有时候确实管用,有时候只是把问题挪了个位置,还有时候会让情况更糟。 本文要回答的是一个前置问题:在动手之前,怎么知道瓶颈在哪一层。至于「参数该设多少」,那是找到瓶颈之后的事。为了让结论可检验,我在一台 4 核虚拟机上搭了一个模拟下游处理时间的服务,把连接池、并发度、worker 数、队列容量逐个拉出来单独改,记录每一次的吞吐量、延迟分位数、队列深度和错误码。文中所有数字都是这台机器上跑出来的,环境和复现脚本放在文末。 先说一个贯穿全文的结论,它由后面的实验支撑: 系统的容量由「能并行执行多少工作」乘以「每份工作多快」决定,这个数在你改代码之前就定死了。超过它的那些请求不会让系统做更多事,只会去某个队列里排队。而排队这件事,在平均响应时间这个指标上是看不出来的。 一、问题的本质:并发增加,为什么延迟反而越来越高?先看一组实测数字。服务端配...
对 Dataman 的代码审计分析
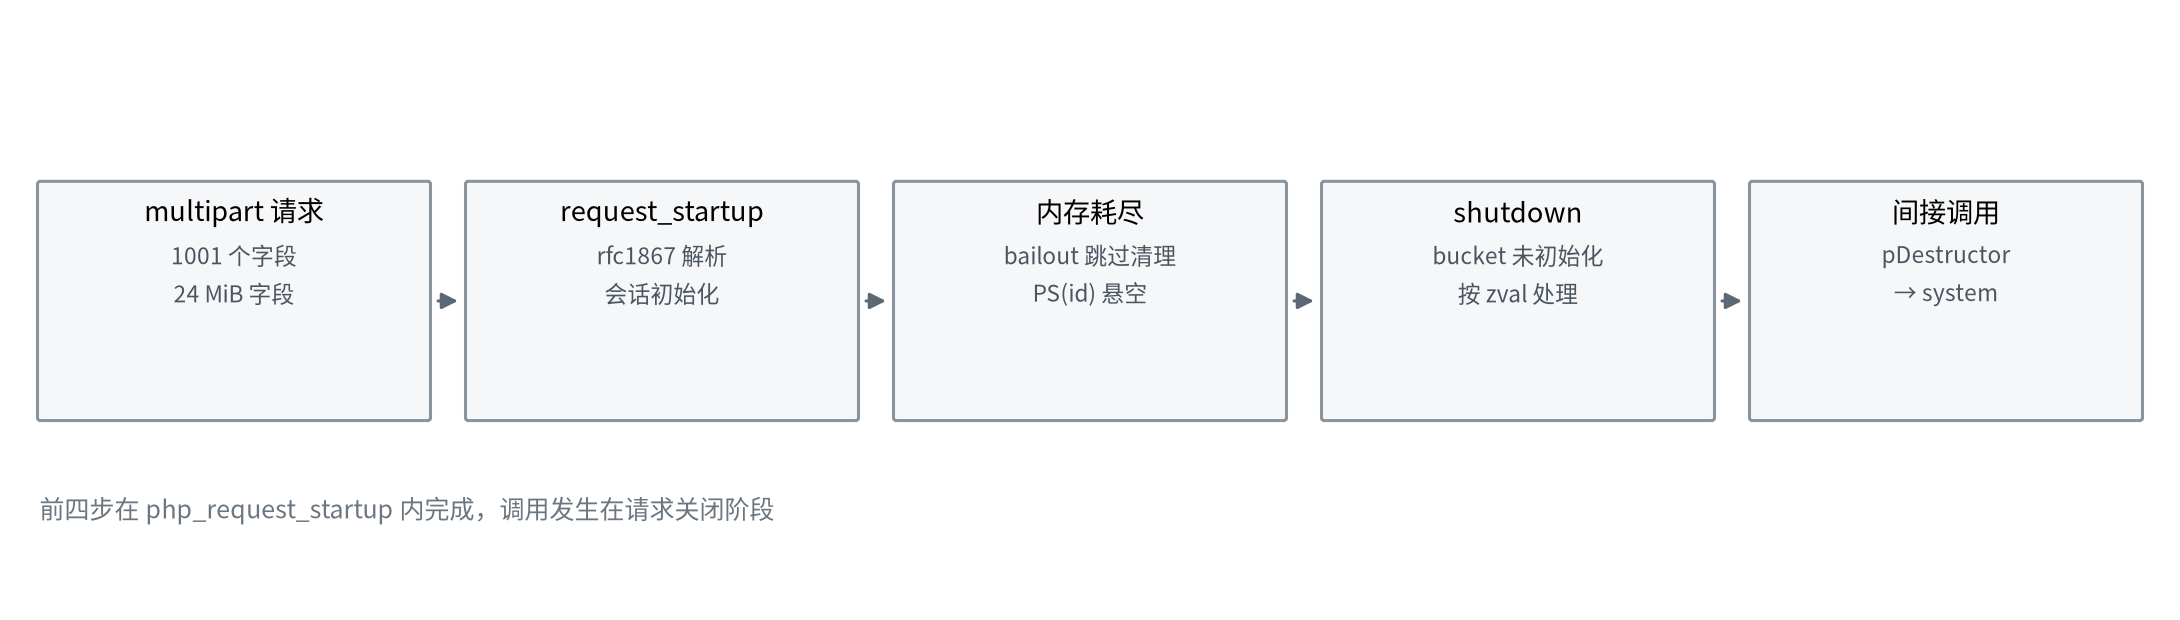
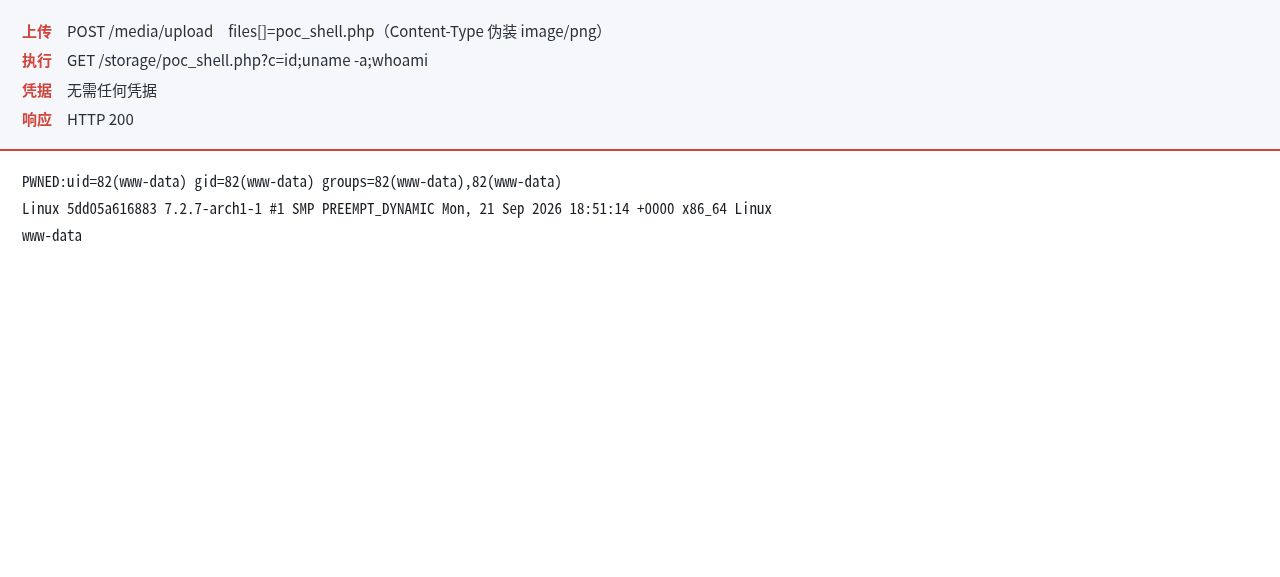
Dataman 是一个开源的数据管理系统,README 里写得很克制:轻量、现代设计风格、移动端。功能清单列了二十来项,从配置管理到广告位,看得出是认真做的项目。技术栈是 Laravel 8 加 Dcat-Admin,代码量不大,一百五十个 PHP 文件、九千行左右。 我把它拉到本地跑起来审了一遍。结论不太好看:从打开登录页,到在服务器上执行系统命令,全程不需要任何已有的账号。 这篇文章记录审计过程。漏洞本身在报告里有逐条列出,这里更想讲的是怎么找到的、怎么判断的,以及中途两次差点把洞放过去的地方。 一、先摸清攻击面拿到一个 Web 项目,第一步不是搜 eval,是先搞清楚它长什么样:用什么框架、路由怎么组织、哪些入口不需要登录。 Dataman 的框架信息在 composer.json 里: 123456"require": { "dcat/laravel-admin": "2.*", "laravel/framework": "^8.12", &qu...
同一个像素数,为什么小 CMOS 拍不清晰:单像素面积、衍射极限与通光孔径
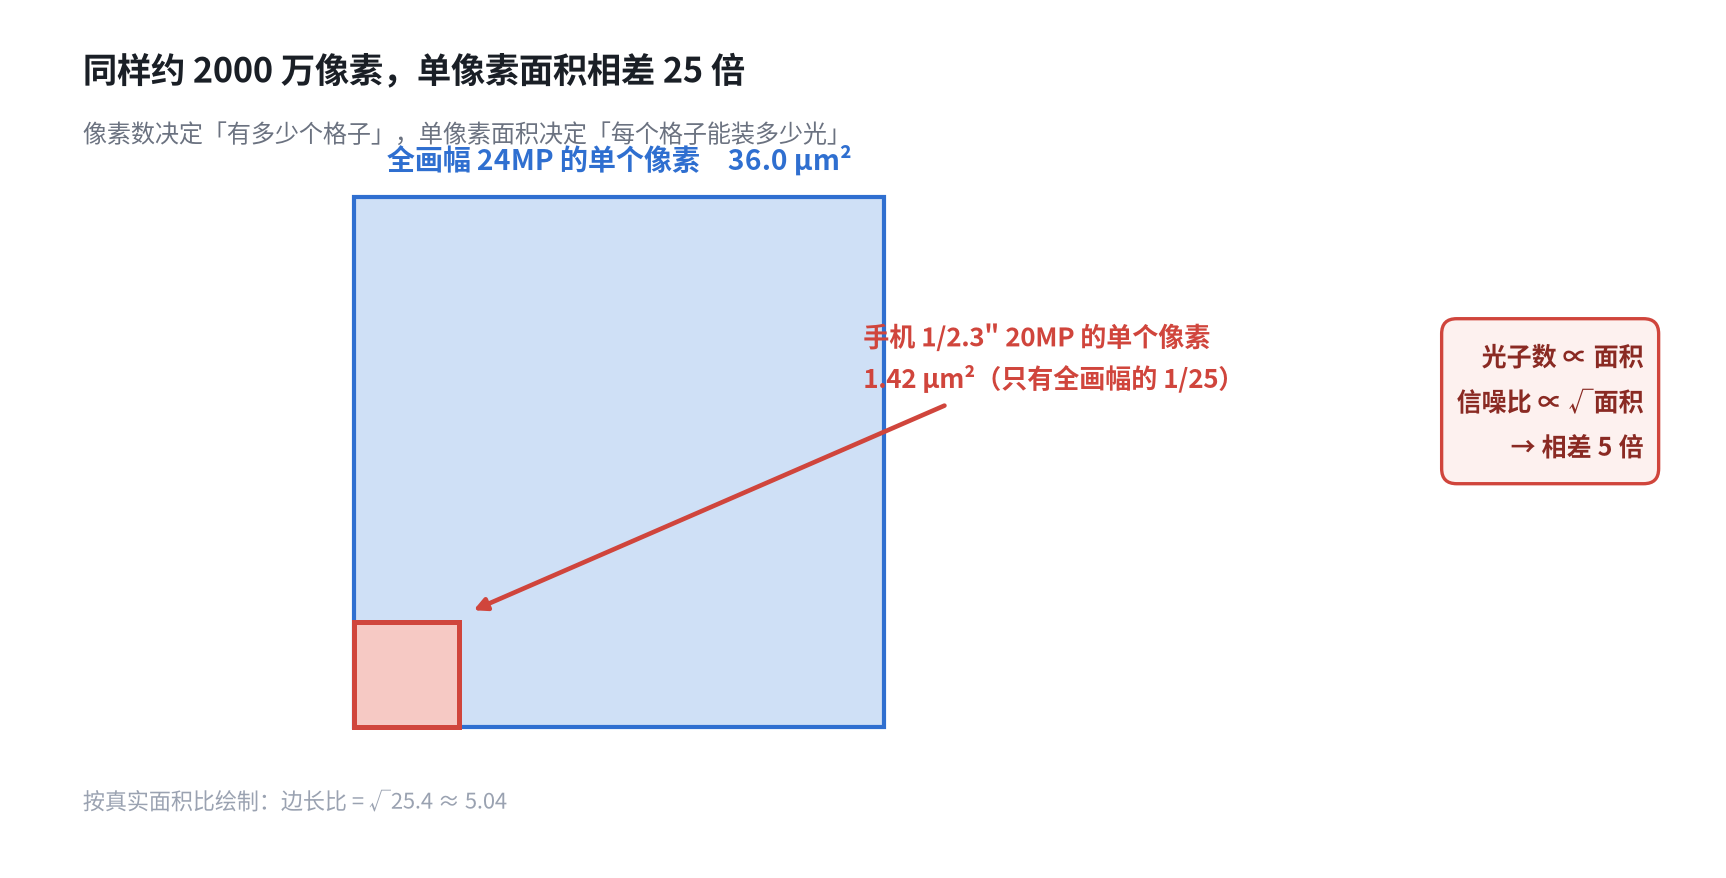
拿两部手机和一台相机,拍同一个人的脸。手机标称 2000 万像素,相机也是 2000 万像素。照片拷到电脑上放大,相机那张能数清睫毛,手机那张只能看到一团糊。 如果去问,多半会得到一个回答:手机的 CMOS 太小了。 这句话没错,但它几乎没有解释任何事情。「小」是一个尺寸,不是一个机制。要回答「为什么小就不清晰」,得把这个尺寸翻译成几个能算出来的量:每个像素分到多少面积、分到多少个光子、光学系统能分辨多细的条纹、镜头实际收集了多大一束光。 这篇文章把这几件事逐个算一遍。所有数字都可以用文末的脚本复现,不需要任何器材。 一、先把「清晰」拆开一张照片清晰,意味着它能让相邻的两个点看起来是分开的。这件事需要三个环节同时成立。 第一,光学系统得把这两个点分开。镜头是一块玻璃,它成像不是完美的,两个靠得很近的点经过它之后会各自糊成一小团。如果两团糊在一起,后面再怎么处理也分不开了。 第二,传感器得有足够的采样点来接住这两团。采样点就是像素。像素太稀,两个点落在同一个像素上,也分不开。 第三,每个采样点读出来的数值得准。如果噪声比信号还大,接到的是一串随机的数字,那也谈不上分辨。 三个环节里...
异步环境下的条件竞争:为什么单线程的协程也会有并发问题
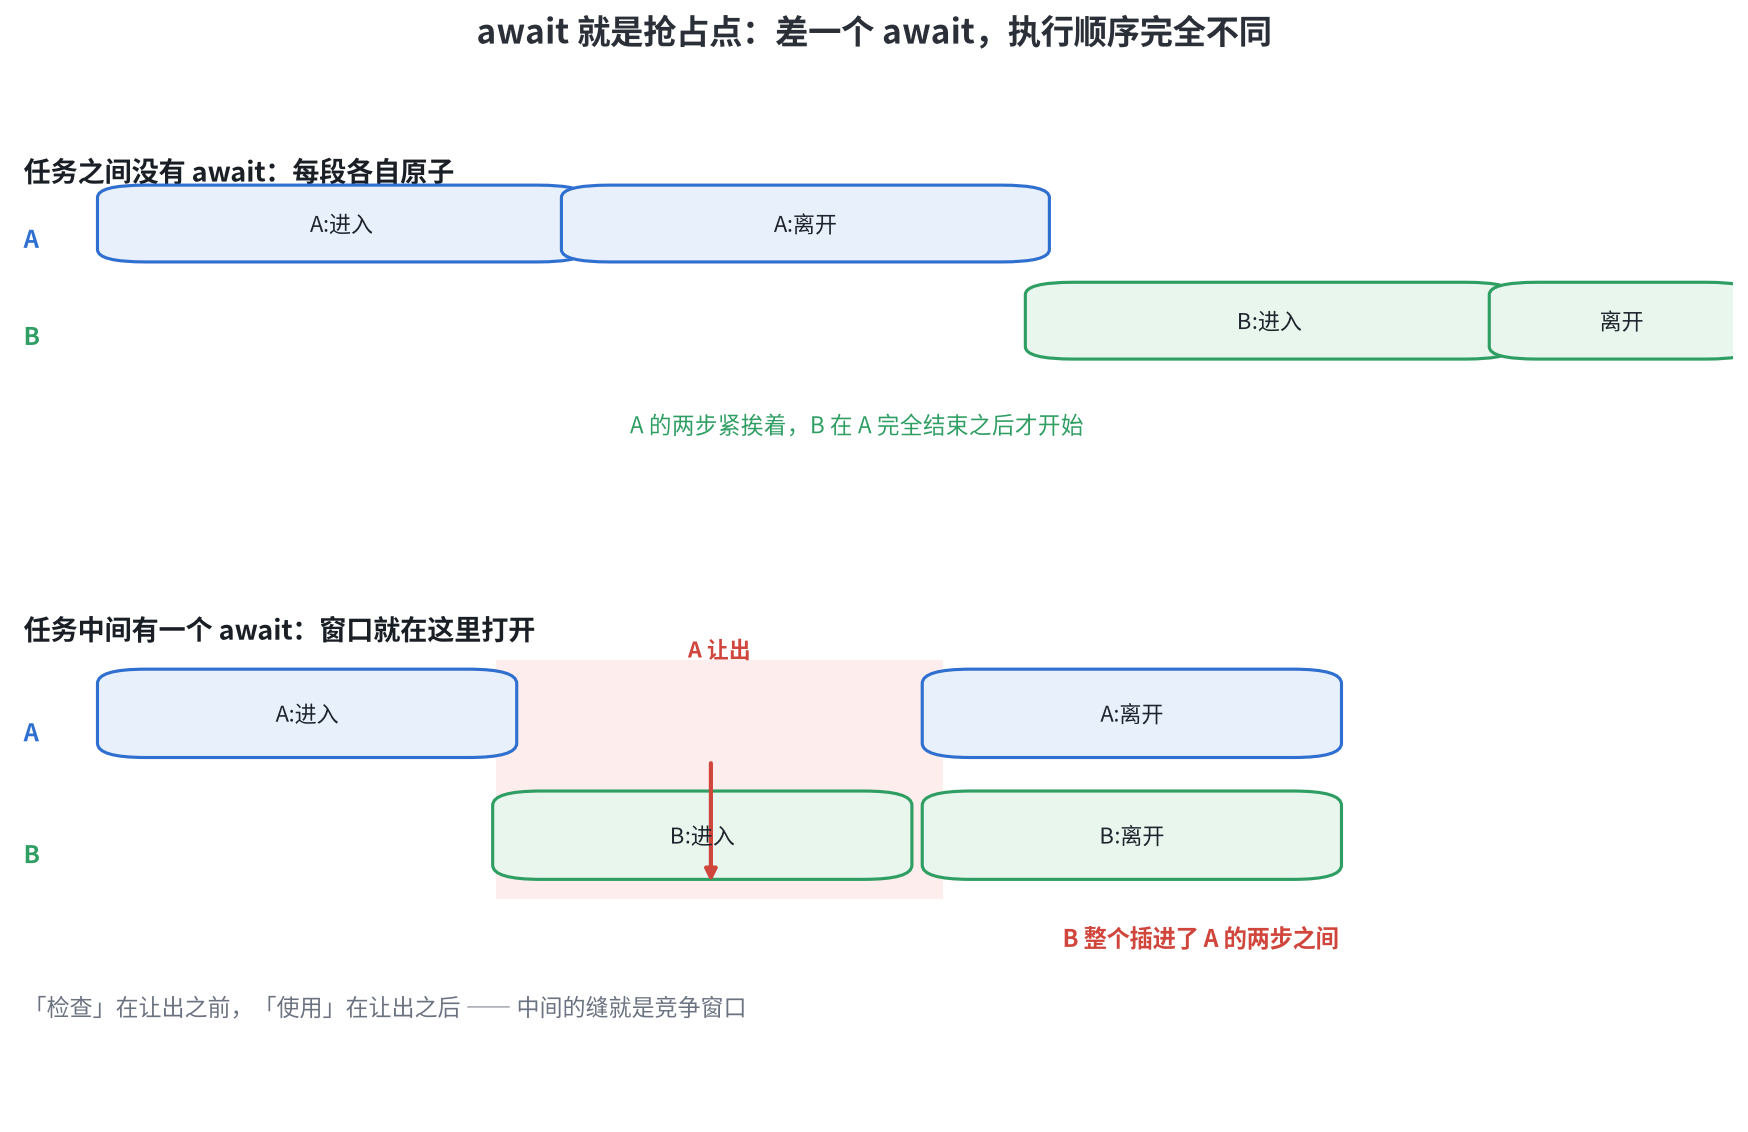
先看一段代码。 123async def worker(): if counter is None: counter = await load_counter() 这是异步项目里到处都是的写法:如果还没加载过,就加载一次。逻辑上无懈可击:先检查,再使用,顺序清楚。在没有并发的世界里,这段代码是正确的。 但把它放进事件循环,跑 16 个并发请求,实测结果是: 16 个请求全都执行了一遍 load_counter()。 不是偶尔,是每一轮。我把这个场景跑了 100 轮,0 轮出现「只加载一次」的期望行为。 这就是异步环境下的条件竞争。它和线程模型里的竞争有相同的内核(检查与使用之间被撕开),但产生方式完全不同:这里没有抢占式调度,没有多核,只有一个线程。真正的竞争者是同一线程里的另一个协程,趁你 await 的时候插了进来。 一、一个反直觉的事实:单线程也会有竞争asyncio 是单线程的。事件循环跑在一个线程里,所有协程都在这个线程上执行。既然只有一条执行流,为什么两个协程会互相干扰? 答案在 await。 把「有没有 await」做成唯一变量,看两个任务的执行...
一次 read() 调用究竟经历了什么?从系统调用追踪 Linux 文件读取路径
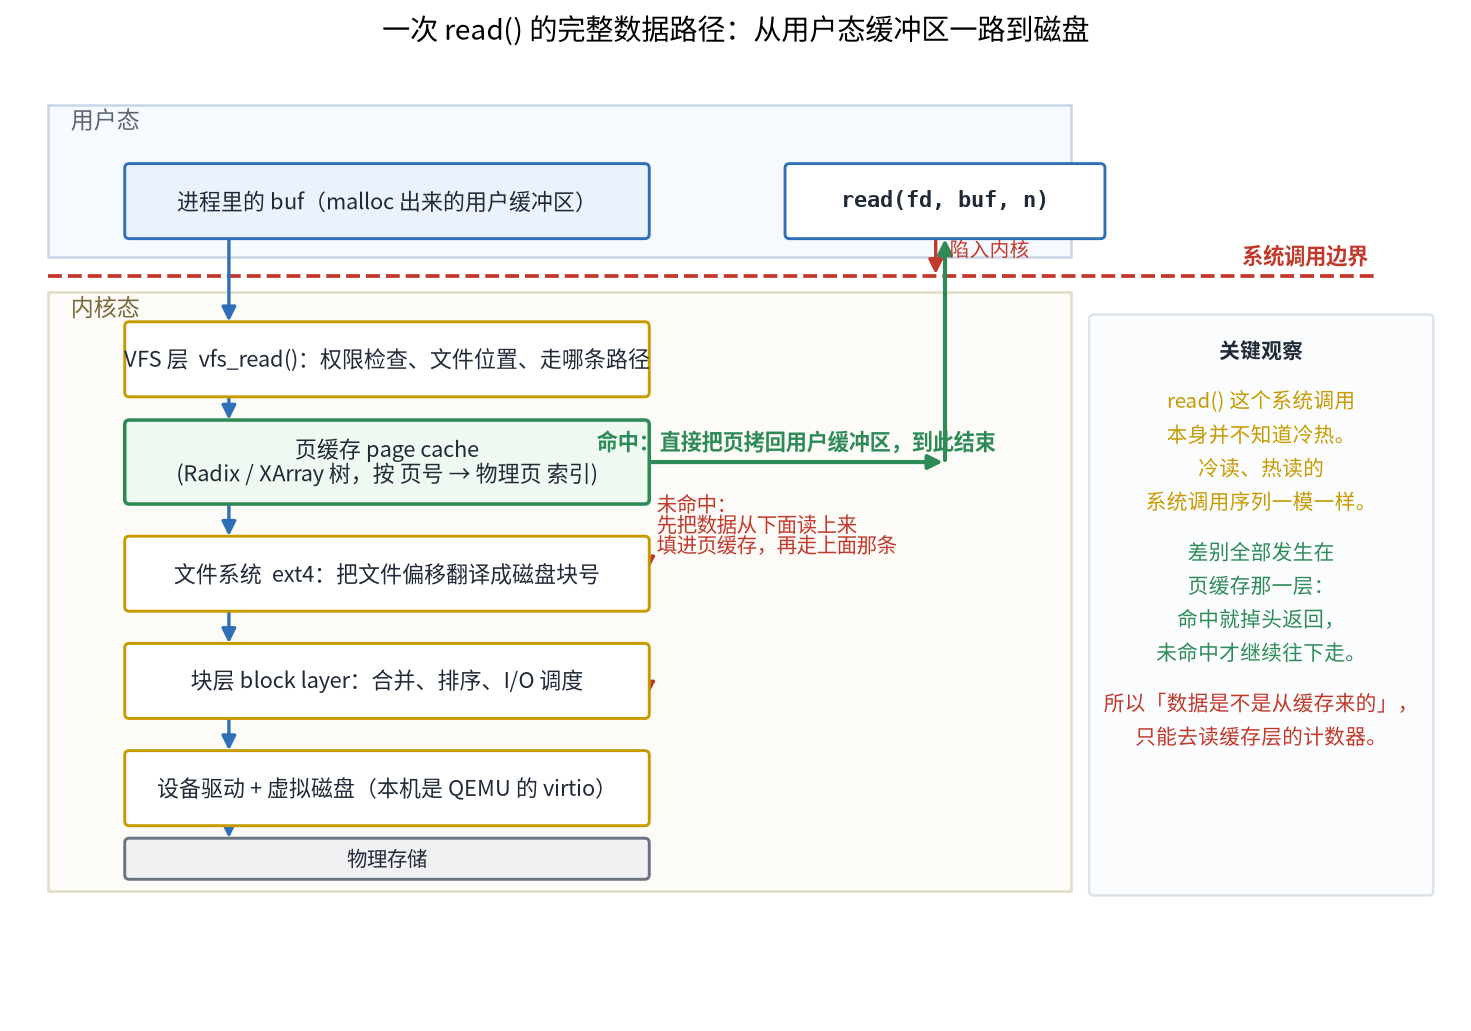
有个现象几乎人人都遇到过,但很少有人说清为什么会这样。 同一个文件,第一次读要几百毫秒,第二次读只要几十毫秒。time 命令给出的数字摆在那里,于是结论就写成了「第二次命中了页缓存」。 这个结论对不对?对。但它不是一个被证明的结论,只是一个被观察到的相关性。耗时短的原因有很多:磁盘刚好不忙、CPU 频率刚好上去了、别的进程刚好没抢内存。耗时是结果的投影,不是原因本身。 要真的证明「数据来自页缓存」,得拿出缓存层自己的计数。这篇文章就是把这件事做完整:先拆数据路径,再给出四类互相独立的证据,然后回答一个更实际的问题,这些证据能推出什么,推不出什么。 所有数据都来自一台真实的 KVM 虚拟机,本机实测,可复现。实验环境、程序源码和原始输出都在文末。 目录 第一章 一次 read() 的完整数据路径 第二章 用什么证明数据来自页缓存 第三章 冷读与热读的完整对照 第四章 read、mmap、O_DIRECT 的三条路径 第五章 一个意外发现:缺页次数不等于访问页数 第六章 证据能推出什么,推不出什么 第七章 实现:把分析沉淀成工具 第八章 一套可复用的诊断流程 第一章 一次 rea...
贪心算法详解:核心思想、策略设计、正确性证明与经典例题
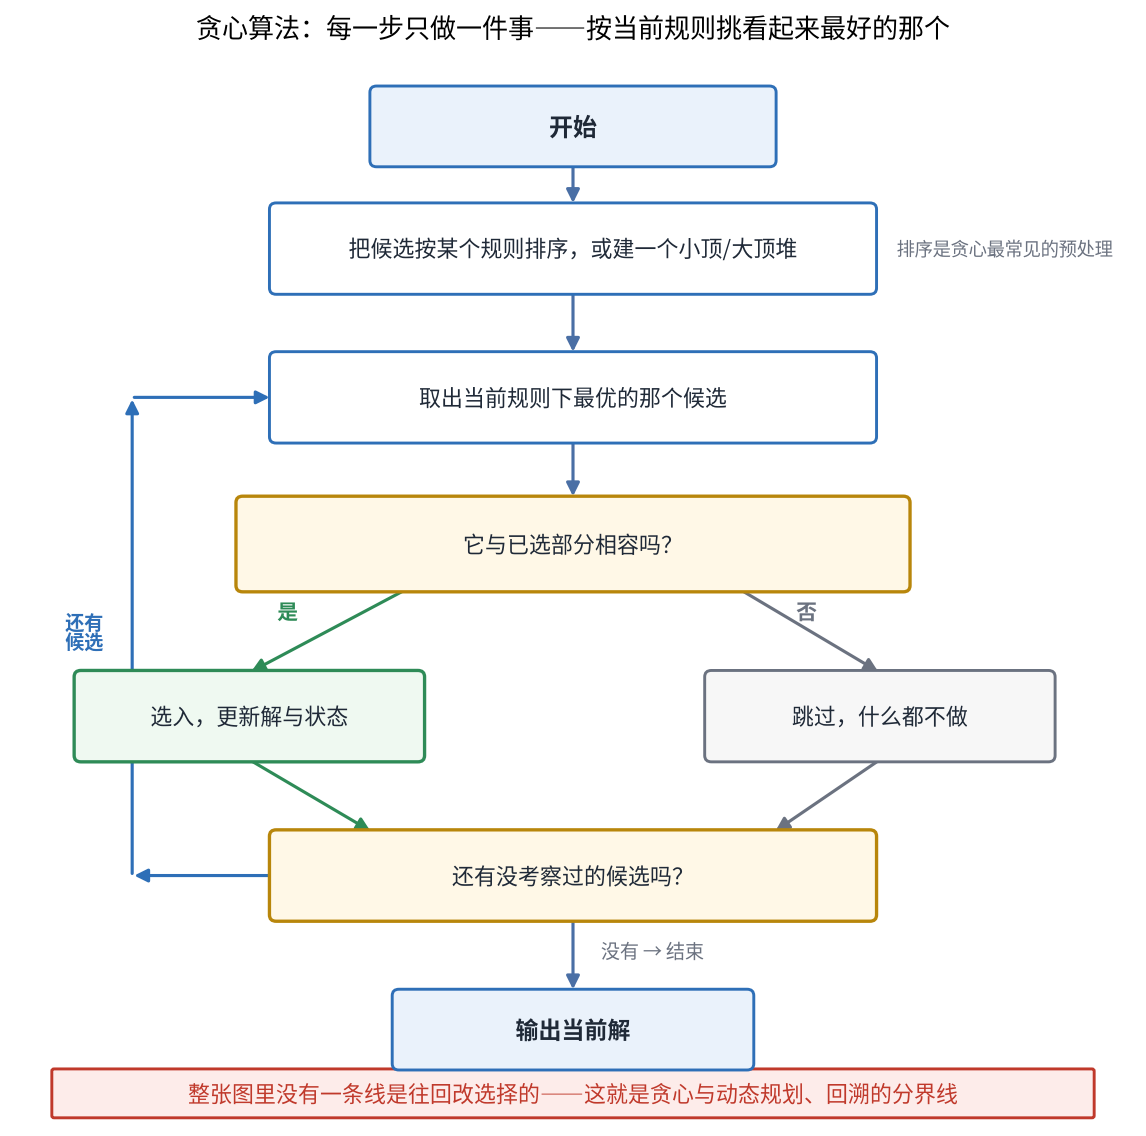
贪心大概是所有算法思想里最像”常识”的一个。它的规则简单到一句话就能说完:每一步都挑当下看起来最好的那个,选完就往前走,不回头。 麻烦的地方也在这里。常识常常靠不住。同一个问题,换一种”看起来最好”的定义,结果可能就从最优变成了次优。更棘手的是,一个错的贪心策略往往在小数据上完全看不出问题——它会安静地给出一个看起来合理的答案,直到某个隐蔽的用例把它戳穿。 所以这篇文章不打算只讲”贪心怎么用”。它更想回答的是三个问题:什么样的局部选择是安全的、怎么证明它是安全的、以及怎么把它彻底推翻。 内容分十二个部分:先是概念和理论基础,然后是一套从题目推到算法的流程,接着用一整章展开正确性证明的五种思路,再按策略类型归纳实现模式,最后是四道完整例题、三组反例、复杂度推导、常见错误清单和学习路线。所有代码都是 C++17,可以独立编译运行,样例输入输出都给全了。 目录 第一章 贪心算法是什么 第二章 贪心算法的核心理论基础 第三章 如何设计一个贪心策略 第四章 贪心算法的正确性证明 第五章 贪心算法的经典策略与实现模式 第六章 经典例题详解 第七章 贪心算法的反例分析 第八章 贪心算法与其他算...
OpenJudge 2811:熄灯问题
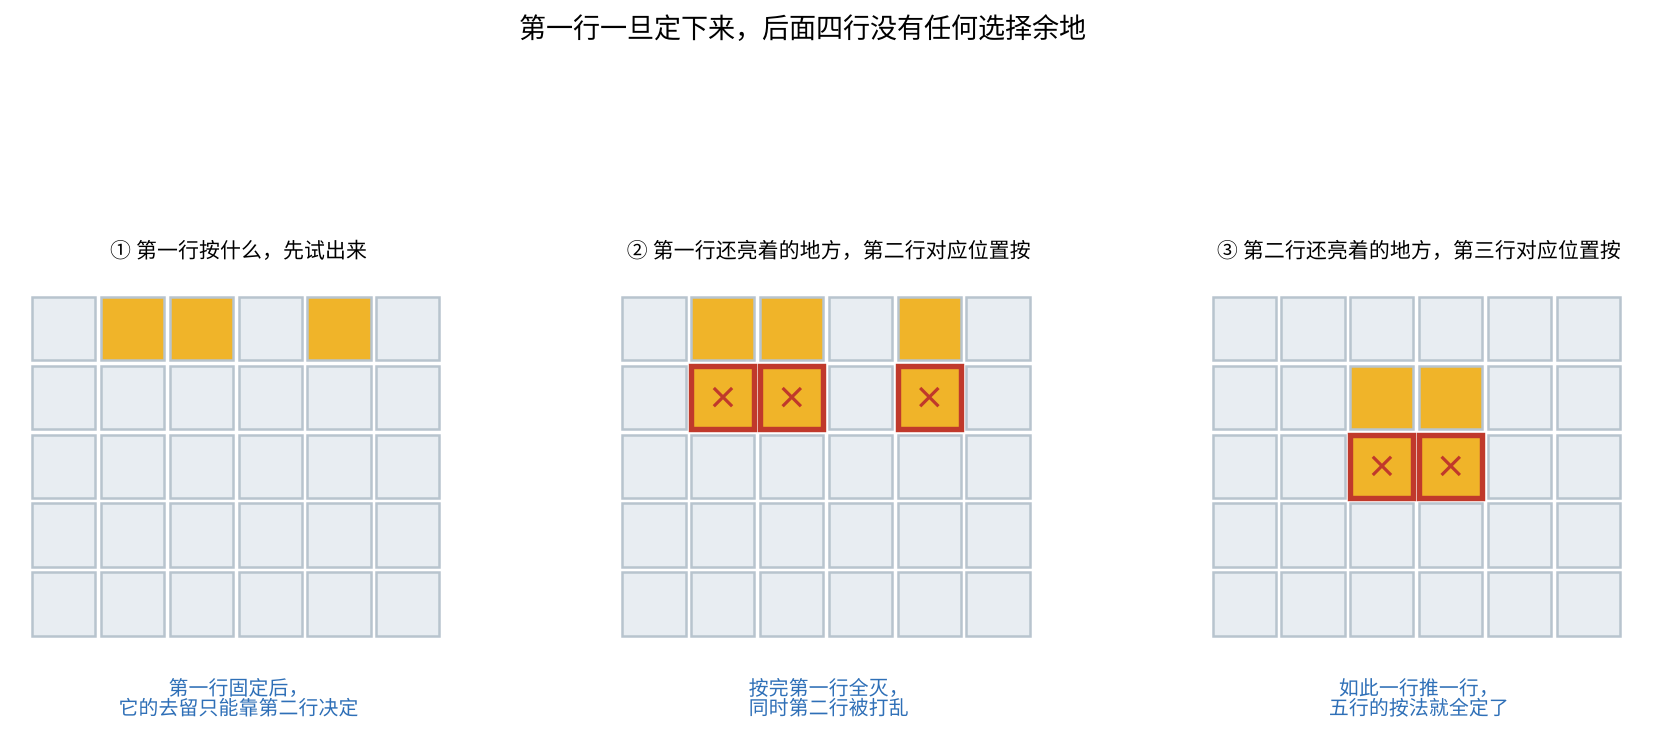
先看三个数。 第一个:1,073,741,824。这是 2 的 30 次方。5 行 6 列一共 30 个按钮,每个按钮只有”按”和”不按”两种状态,所以全部按法的数量就是这个数。十亿这个量级,写个程序一种一种试,试到天荒地老。 第二个:64。这是第一行 6 个按钮的全部按法数量,2 的 6 次方。真正需要遍历的,从头到尾只有这个数。 第三个:1。在 10.7 亿种按法里,正确的那个只有一个。不是”可能有几个”,是数学上确凿的唯一。 这篇文章要讲的就是:为什么 64 次就够了,为什么答案是唯一,以及怎么把时间和空间都压到没有一丝浪费。 一、先把规则读成一句话题目给的矩阵是 5 行 6 列,每个位置一盏灯。按下一个按钮,它自己和上下左右四盏灯的状态都翻转一次。角上的按钮只影响 3 盏,边上的影响 4 盏,中间的 5 盏。 规则里藏了三条可以直接用的性质: 按两次等于没按。 翻转两次就回到原状。所以每个按钮只有”按”和”不按”两种有意义的状态,按第三第四次的都是白费。 顺序无所谓。 先按 A 再按 B,和先按 B 再按 A,结果完全一样。因为每一次操作都是翻转,翻转是加法,加法满足交...
计算机是怎么记录声音的?详解 mp3 与 wav 格式文件和录音的原理
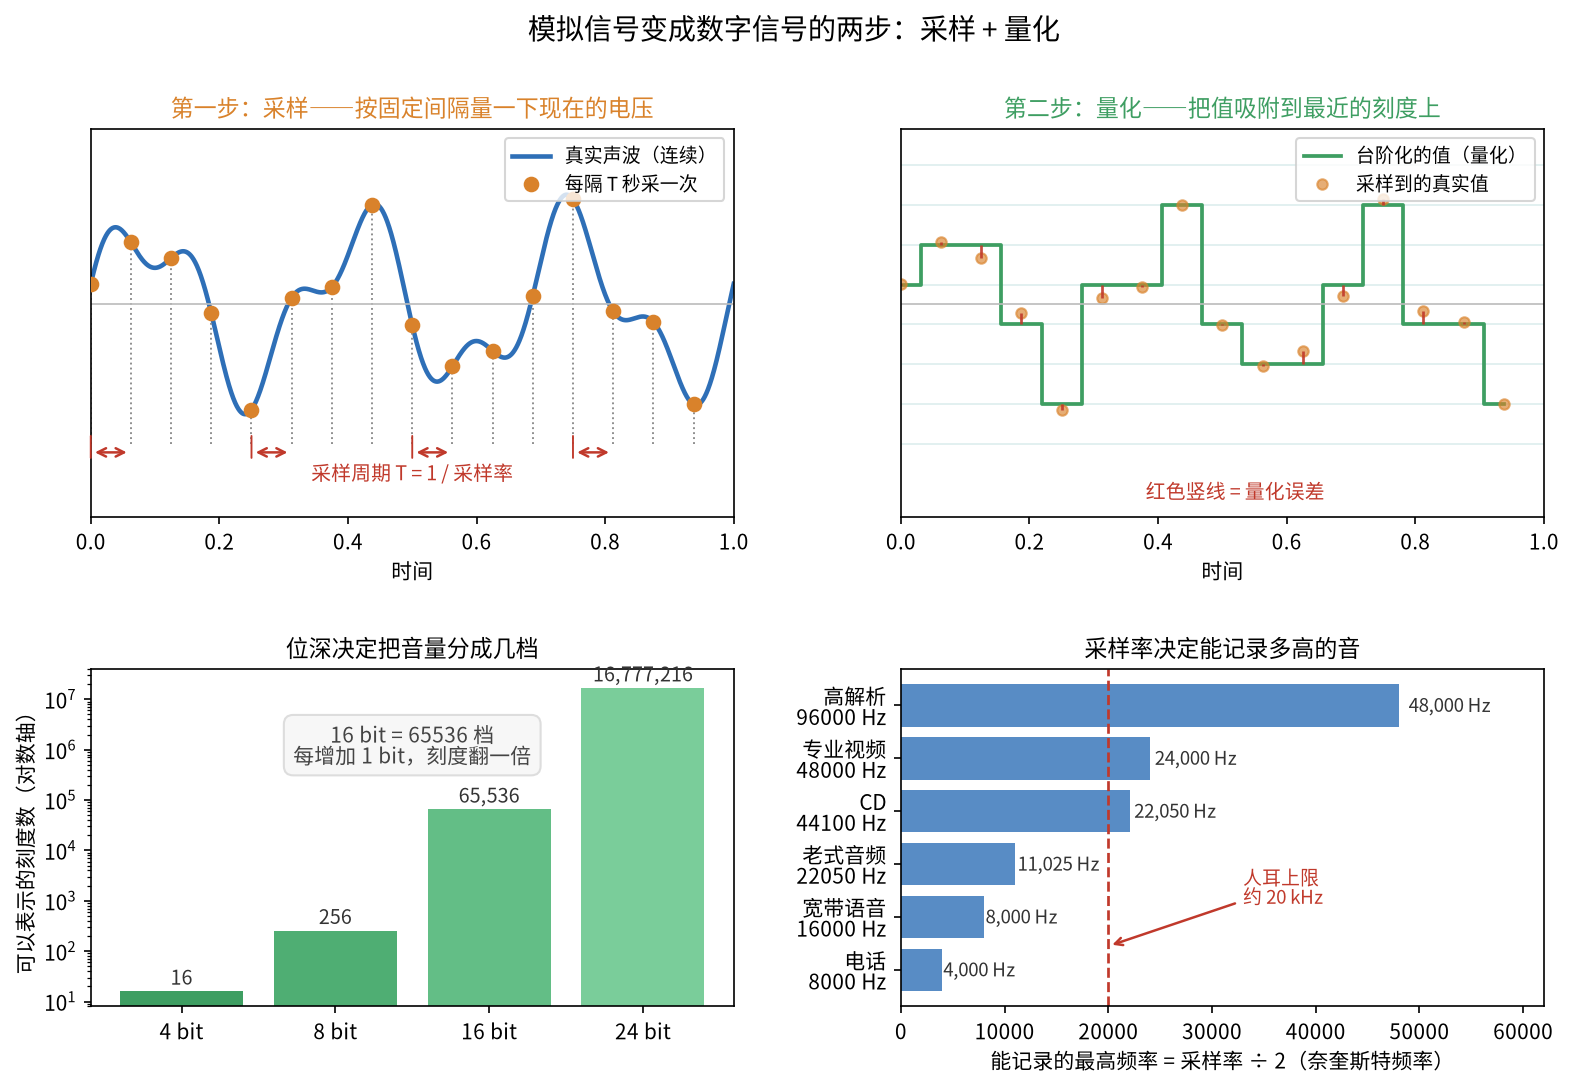
先摆三个事实,它们看起来有点矛盾。 第一个。我录了三秒声音,存成 WAV,文件 517 KB。同一段声音转成 MP3,只剩 48 KB,缩小到 9.2%。用耳朵听,我听不出区别。 第二个。这个 517 KB 的 WAV 文件里,真正描述”这段录音的参数”的部分只有 44 个字节。剩下的全是采样数据,一个字节都不省。 第三个。如果我把采样率从 44100 改成 8000,再改成单声道,文件立刻掉到 47 KB,跟 MP3 差不多大。但这时候的音质,你一听就知道是电话里的声音。 这三个事实指向同一件事:声音在电脑里怎么存,取决于三个环节。怎么把空气的振动变成电信号,怎么把电信号变成数字,怎么决定哪些数字可以丢掉。 这篇文章把这三个环节从头走一遍,走到字节级别。 一、声音的本质是空气在抖声音不是一种”东西”,它是空气的一种状态。 你说话的时候,声带在振动。振动推动它旁边的空气,那层空气又被压缩,去推动下一层。这样一层推一层,一路推到你朋友的耳朵里。中间没有任何东西从你嘴里飞到对方耳朵里,传过去的只是”压缩和稀疏”这个状态。 被压缩的区域,空气分子挤在一起,密度高,压强比周围大一点。...