一次 read() 调用究竟经历了什么?从系统调用追踪 Linux 文件读取路径
有个现象几乎人人都遇到过,但很少有人说清为什么会这样。
同一个文件,第一次读要几百毫秒,第二次读只要几十毫秒。time 命令给出的数字摆在那里,于是结论就写成了「第二次命中了页缓存」。
这个结论对不对?对。但它不是一个被证明的结论,只是一个被观察到的相关性。耗时短的原因有很多:磁盘刚好不忙、CPU 频率刚好上去了、别的进程刚好没抢内存。耗时是结果的投影,不是原因本身。
要真的证明「数据来自页缓存」,得拿出缓存层自己的计数。这篇文章就是把这件事做完整:先拆数据路径,再给出四类互相独立的证据,然后回答一个更实际的问题,这些证据能推出什么,推不出什么。
所有数据都来自一台真实的 KVM 虚拟机,本机实测,可复现。实验环境、程序源码和原始输出都在文末。
目录
- 第一章 一次 read() 的完整数据路径
- 第二章 用什么证明数据来自页缓存
- 第三章 冷读与热读的完整对照
- 第四章 read、mmap、O_DIRECT 的三条路径
- 第五章 一个意外发现:缺页次数不等于访问页数
- 第六章 证据能推出什么,推不出什么
- 第七章 实现:把分析沉淀成工具
- 第八章 一套可复用的诊断流程
第一章 一次 read() 的完整数据路径
从一行代码说起
1 | ssize_t n = read(fd, buf, 4096); |
这行代码做了两件事:把进程的意图告诉内核,等内核把数据放到 buf 里。真正的工作全在内核侧。
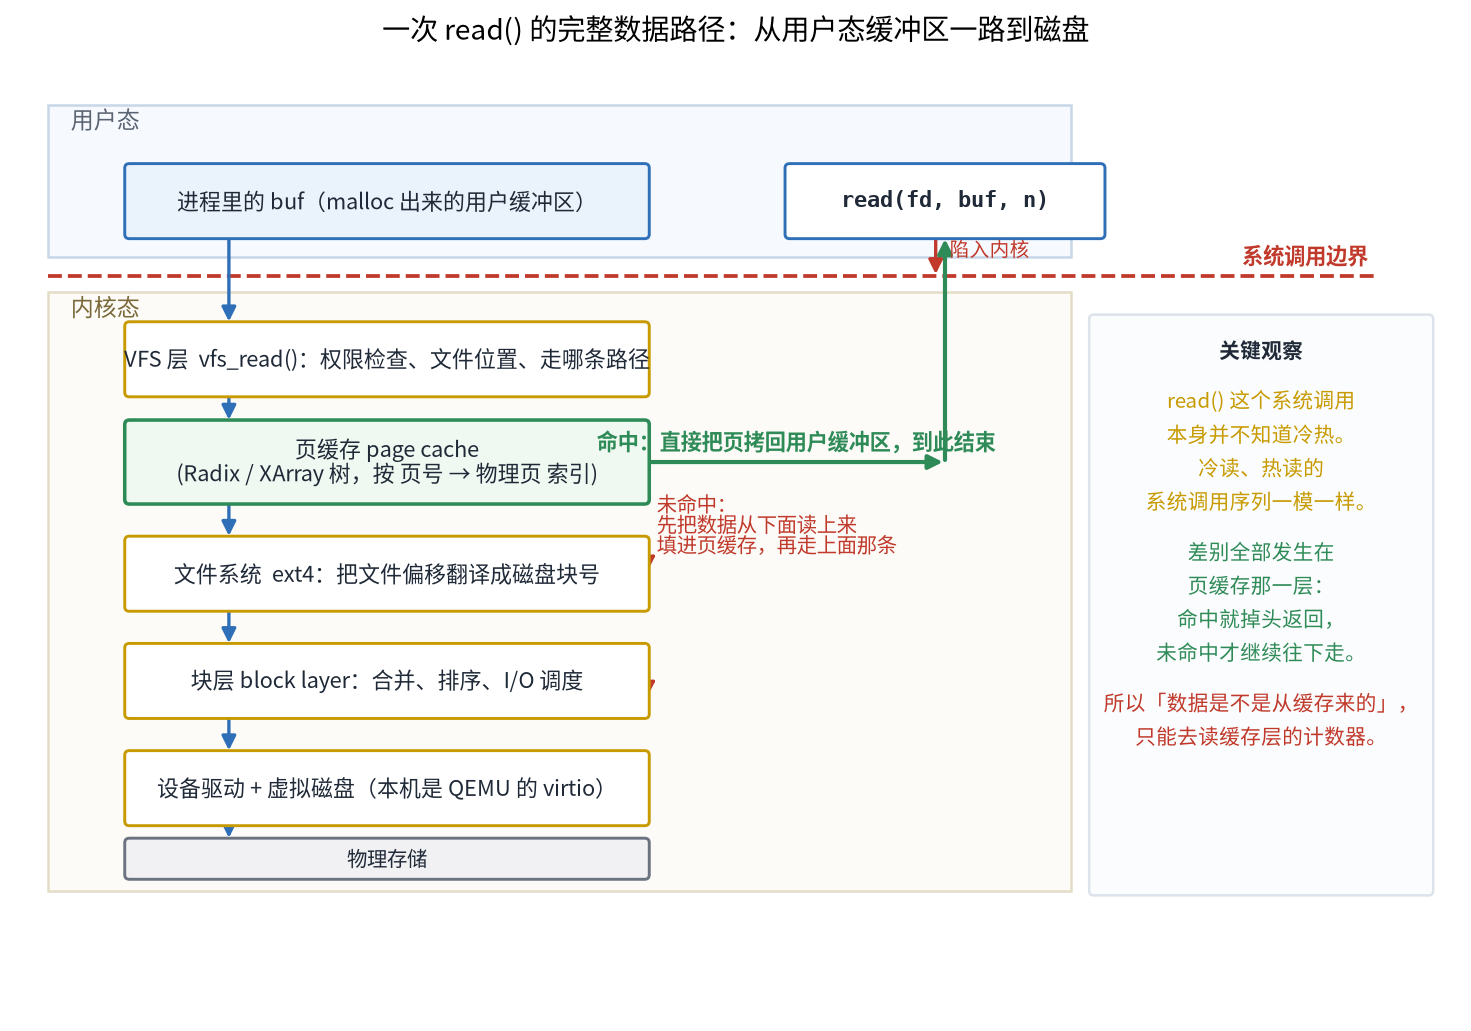
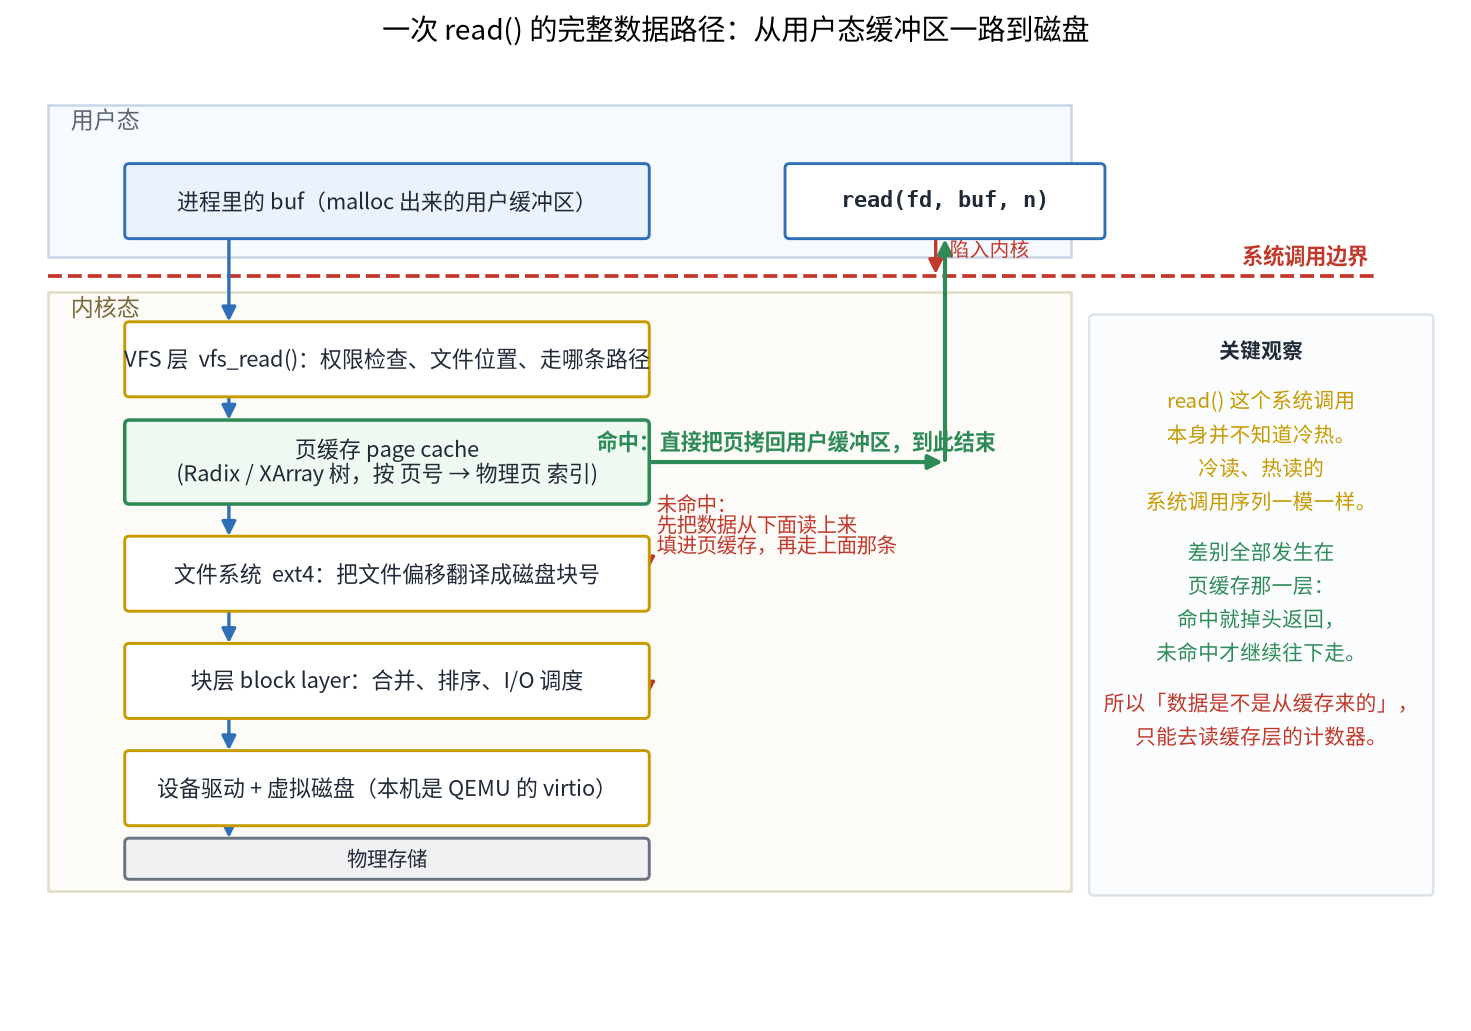
从下往上看每一层在干什么:
设备与驱动层。数据的终点。这台机器上的「物理磁盘」是 QEMU 给虚拟机的一块虚拟盘,驱动是 virtio-blk。这一层负责把块号翻译成真正的读命令发出去。
块层。它接收「读第 N 到第 M 个扇区」这样的请求,做合并和排序,再交给驱动。相邻的小请求会在这里被合并成大请求,这一点后面会影响到实测数字。
文件系统层。它的职责是翻译:把「文件的第 8192 字节」这种逻辑地址,翻译成「磁盘的某个块」。不同文件系统的翻译方式不同(ext4 用 extent 树,XFS 用 B+ 树),但对上层来说是透明的。
页缓存。这是整条路径的关键。它是一棵按「文件 + 页号」索引的树,缓存着文件内容对应的物理页。如果请求的页已经在这棵树里,内核就跳过下面所有层,直接把数据拷回用户缓冲区。
VFS 层。统一的文件操作接口,负责权限检查、文件位置维护、以及决定走哪条具体实现。
回到用户态。数据通过 copy_to_user 拷进 buf,read() 返回拷贝的字节数。
分岔点在哪
这张图里最值得记住的是分岔:路径在页缓存处一分为二。
- 命中:数据已经在页缓存里 → 直接拷贝返回。下面三层完全不参与。
- 未命中:先把数据从磁盘读上来,填进页缓存,然后走命中那条路。
注意这里有个容易被忽略的设计:未命中时,读上来的数据会留在页缓存里。这就是为什么第二次读会快:第一次顺便把缓存铺好了。
还要注意,无论哪条路,最终数据都是拷贝进用户缓冲区的。这个拷贝不是免费的:1 GiB 的数据要在内核态和用户态之间搬 1 GiB。后面讲 mmap 时会看到,这条拷贝正是 mmap 想省掉的东西。
关键观察:系统调用这一层是”瞎”的
把上面那段话反过来读一遍。
read() 这个系统调用做的事情,无论命中还是未命中,都完全一样:检查参数、走 VFS、要数据、拷回来、返回字节数。
它不知道、也不关心数据是从哪来的。 接下来的实验会用实测数据证明这一点:冷读和热读的系统调用序列,一字不差。
这件事的直接后果是:光看系统调用,你无法判断缓存有没有起作用。 证据必须从别的地方找。
第二章 用什么证明数据来自页缓存
为什么耗时不算证据
先把这个思路排除掉,因为它看起来最直观。
耗时 = 你的代码 + 内核代码 + 内存拷贝 + 磁盘等待 + 调度延迟 + 中断处理 + ……。磁盘等待只是其中一项。当它在总耗时里占比很低时,耗时对「有没有走磁盘」这件事就几乎没有分辨力。
实测数字很能说明问题。同一个 1 GiB 文件,同一段读取代码:
1 | 冷读(缓存被驱逐后) 0.2664 s |
只差 2.6 倍。而两者的实际磁盘 I/O 差了多少?1 GiB 对 0。
耗时的比值是 2.6,I/O 的比值是无穷大。 拿 2.6 倍去论证「数据来自缓存」,等于用一把刻度很粗的尺子去量一个精度要求很高的东西。更糟的是,如果换成一个 4 KiB 块的小文件读,冷热耗时只差 1.5 倍(0.3836 s 对 0.2508 s),这个信号几乎淹没在噪声里。
耗时能告诉你「可能有缓存参与」,但给不出「一定」和「有多少」。
四类能直接回答问题的证据
这台机器上没有装 strace、perf、blktrace,而且 sudo 需要密码,所以这些现成工具一个都用不了。但这不影响取证,内核在 /proc 里暴露了足够多的计数器,非特权进程就能读。
证据一:/proc/self/io 的两个计数器
这是最有力的一条。这个文件里有两行关键内容:
1 | rchar: 2884 <- 进程通过系统调用读写了多少字节(含缓存命中) |
两者的语义差别正是问题的答案:
rchar统计走过系统调用的字节数。看着read()把数据给你了,它就算数,不关心数据从哪来。read_bytes统计真正落到块设备上的字节数。只有页缓存没命中、必须去磁盘拿的部分才算。
于是:
这个差值是内核自己记的账,不是推理出来的。缓存有没有替我们干活、替了多少,两个数字一减就出来了。
证据二:mincore() 直接问每一页在不在
/proc/self/io 给的是总量。如果要精确到每一页,可以用 mincore() 系统调用:给它一段映射的地址,它返回一个位图,每一位表示对应页当前是否驻留在内存里。
1 | unsigned char *vec = calloc(npages, 1); |
要让 mincore 检查文件的内容页,需要先把文件 mmap 进来。它返回的是「页是否在内存」,这正是缓存命中的定义。
证据三:缺页异常计数
getrusage(RUSAGE_SELF) 里的 ru_minflt / ru_majflt,或者 /proc/self/stat 里的对应字段:
- 次缺页(minor fault):页已经在内存里,只需要建立页表映射。缓存命中走这个。
- 主缺页(major fault):页不在内存里,必须去磁盘读。只有这种情况才涉及物理 I/O。
两个计数器分开,正好把「从缓存拿」和「从磁盘拿」区分开了。用两个独立来源交叉验证(getrusage 和 /proc/self/stat)还能排除单一接口统计口径的问题。
证据四:/proc/diskstats 的设备级计数
上面三条都是进程视角。/proc/diskstats 是设备视角,统计整块盘被读了多少个扇区。
读取前后各取一次,差值就是这次操作期间这块盘真实承受的读负载。这条证据的价值在于它不受进程边界限制:就算读操作发生在别的进程、别的线程,甚至内核自己的预读线程里,设备计数照样会涨。
小结:四类证据各管一段
| 证据 | 回答的问题 | 视角 |
|---|---|---|
rchar |
进程以为自己读了多少 | 进程 · 系统调用层 |
read_bytes |
进程真的从设备取了多少 | 进程 · 块设备层 |
mincore() |
具体哪些页现在在内存里 | 页 · 缓存层 |
diskstats |
整台机器的盘被读了多少 | 设备 · 硬件层 |
四者互相独立,交叉起来就能把「数据到底从哪来」钉死,不必依赖任何时间测量。
第三章 冷读与热读的完整对照
实验设置
为了能可靠地制造「冷」,需要能把指定文件踢出页缓存。通常的做法是往 /proc/sys/vm/drop_caches 写 1,但那需要 root,而且会把整台机器的缓存清空,副作用太大。
非 root 条件下有个精确得多的工具:posix_fadvise()。
1 | posix_fadvise(fd, 0, 0, POSIX_FADV_DONTNEED); |
这个调用的意思是「这个文件的这部分,我暂时不需要了,可以丢掉」。它只影响指定的文件区间,不碰别的进程、别的文件。
实测它在 1 GiB 文件上的效果:
1 | fadvise 前驻留: 262144 / 262144 页 |
用 mincore() 逐页数出来的,一页不剩。「冷」这个前提是被验证过的,不是假设的。
对照结果
测试文件 1 GiB,read() 每次读 128 KiB,每组跑三次取中位数:
| 场景 | 耗时 (s) | 吞吐 (MB/s) | rchar (字节) | read_bytes (字节) | 设备读 (MB) | minflt | majflt |
|---|---|---|---|---|---|---|---|
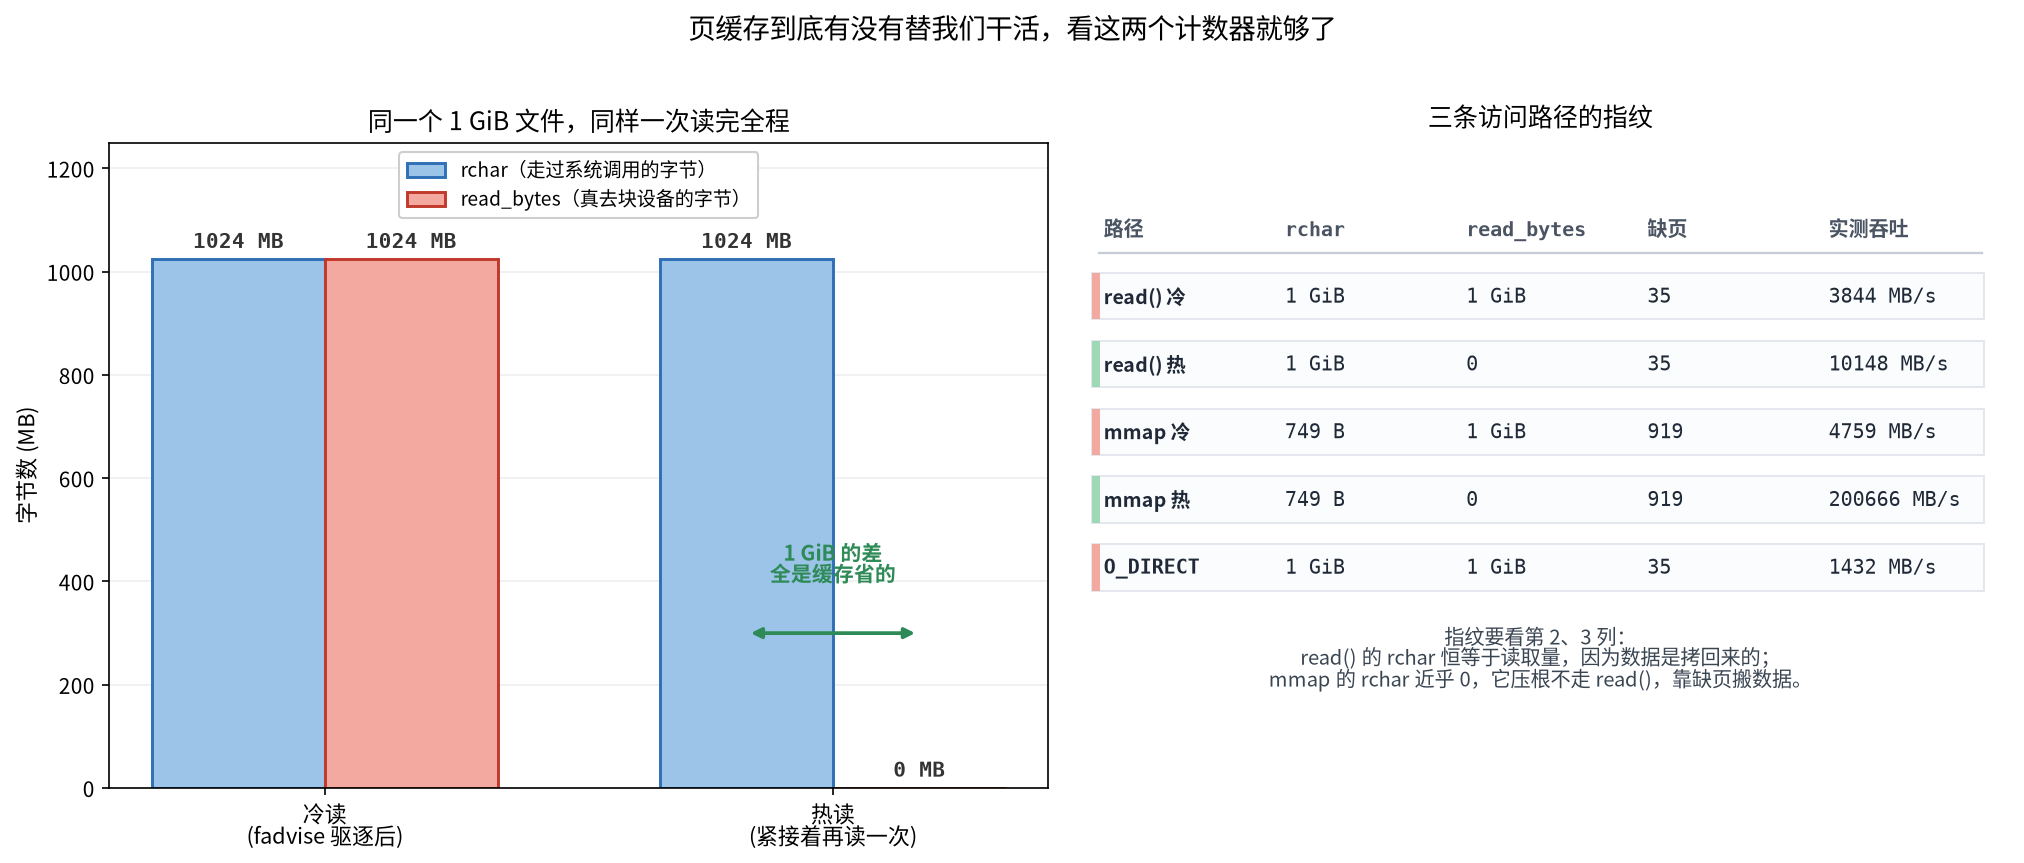
| 冷读 | 0.2664 | 3844.3 | 1073742573 | 1073741824 | 1024.0 | 35 | 0 |
| 热读 | 0.1009 | 10147.7 | 1073742573 | 0 | 0.0 | 35 | 0 |
| 冷读 4K 块 | 0.3836 | 2669.3 | 1073742573 | 1073741824 | 1024.0 | 4 | 0 |
| 热读 4K 块 | 0.2508 | 4082.7 | 1073742573 | 0 | 0.0 | 4 | 0 |
三次重复的原始耗时(seq_cold_128k):0.2752 / 0.2601 / 0.2664 秒,波动在 5% 以内。
这张表里最重要的一列
看 rchar 那一列:冷读和热读完全一样,都是 1073742573 字节。
这跟第一章那个结论是同一个道理:系统调用层只负责搬数据,不负责记录数据从哪来。进程要求读 1 GiB,read() 就忠实地交付 1 GiB,一次不多一次不少。
分岔在下一列。read_bytes 从 1073741824 掉到 0。
这就是页缓存在干活的确凿证据:进程以为自己读了 1 GiB,而块设备一个字节都没被要求提供。
再看设备级确认。/proc/diskstats 里 sda 的读扇区增量,冷读时是 1024.0 MB,热读时是 0.0 MB。设备自己也是这么说的。
三路证据(进程层 read_bytes、设备层 diskstats、页层 mincore)互相独立,结论一致。
系统调用记录:两遍一模一样
前面两节都是数字。这一节换成直接的调用记录。因为这台机器没有 strace,我用 ptrace 自己写了一个追踪器(第七章给实现)。
追踪一个只做一次 read() 的最小程序,把文件相关的调用挑出来。
热读:
1 | openat (-100, "data/small.txt", 0x0, 0) = 3 |
冷读(读取前先驱逐缓存):
1 | openat (-100, "data/small.txt", 0x0, 0) = 3 |
两条记录里,read(3, buf, 4096) = 4096 这一行一字不差。唯一的区别是我自己加的那个 fadvise64。
这个对照的价值在于它排除了一个常见的误判路径。有人会想:「冷热读肯定会在系统调用上有区别吧,比如多了个什么调用。」实测告诉你:没有。系统调用这一层自始至终是同一套动作,差别全部发生在它下面。
所以,想通过跟踪系统调用来判断缓存命中,方向本身就是错的。要看得再往下走一层。
连续读取
最后补一个更贴近现实的场景。同一个 1 GiB 文件,连续完整读三遍:
| 场景 | 耗时 (s) | rchar (字节) | read_bytes (字节) | 设备读 (MB) |
|---|---|---|---|---|
| 连读 3 次 | 0.3046 | 3221226225 | 0 | 0.0 |
rchar 是 3 GiB,三次读取的系统调用全部老老实实走完了,数据也全部拷进了用户缓冲区。而 read_bytes 是 0。
这就是「第二次读取几乎不产生物理磁盘 I/O」这句话的精确版本:不是几乎没有,是完全没有。三遍里只有第一遍的前半段碰了盘,之后全程由页缓存供给。
顺带说明一个容易被误读的点:热读只快了 2.6 倍,不是因为磁盘很慢,而是因为拷贝本身有成本。1 GiB 数据要从内核页拷贝到用户缓冲区,这个 memcpy 再快也要时间。热读的 0.1009 秒里,绝大部分花在这个拷贝上。想省掉它,就得看下一章的 mmap。
第四章 read、mmap、O_DIRECT 的三条路径
三个接口看起来都能「把文件内容弄到进程里」,但数据走的路完全不同。
read():内核替你拷
路径是第一章那张图。数据从页缓存拷贝到用户缓冲区,进程拿到一份副本。
- 优点:简单、通用,文件描述符语义清晰(带文件位置,可
lseek)。 - 代价:多一次内存拷贝。1 GiB 数据就要多搬 1 GiB。
mmap():建立映射,靠缺页搬数据
mmap() 不拷贝任何数据。它做的是建立映射:把文件的某段区间和进程虚拟地址空间的某段区间关联起来。
1 | char *m = mmap(NULL, size, PROT_READ, MAP_SHARED, fd, 0); |
接下来访问 m[i] 时,CPU 发现这个虚拟地址没有对应的物理页,触发缺页异常,内核此时才去页缓存找页、建立页表映射。
数据从头到尾没有被拷贝,进程直接读的是页缓存里的那些物理页。
这个差别在数据上留了非常清晰的指纹:
| 场景 | 耗时 (s) | 吞吐 (MB/s) | rchar (字节) | read_bytes (字节) | minflt | majflt |
|---|---|---|---|---|---|---|
| mmap 冷 | 0.2152 | 4759.1 | 749 | 1073741824 | 919 | 1 |
| mmap 热 | 0.0051 | 200666.3 | 749 | 0 | 919 | 0 |
rchar 只有 749 字节,而这 749 字节还是程序读取 /proc/self/io 自己造成的。
进程访问了整整 1 GiB 的文件内容,可是一个字节都没走 read()。数据是通过缺页异常进入进程的,绕过了系统调用层的字节计数。
如果不看 rchar 而只看耗时,会很自然地写出「mmap 比 read 快 50 倍」这样的结论。但热读状态下 mmap 比 read 快的是 2 万倍(0.0051 对 0.1009),差了三个数量级。这个量级差异不是「快一点」,而是「省掉了一整次拷贝」。
用 200 GB/s 这个数字反推:1 GiB / 0.0051 s ≈ 200 GB/s,远超任何磁盘、也超过单通道内存带宽。它测的其实只是「遍历一遍已经在缓存里的页」的成本,因为缺页搬页表这件事在第一遍就做完了,第二遍连缺页都不会发生(那 919 次缺页是在第一次触碰时产生的)。
O_DIRECT:主动绕开缓存
第三条路是显式声明「不要缓存」:
1 | int fd = open(path, O_RDONLY | O_DIRECT); |
O_DIRECT 让读写直接落在块设备上,不经过页缓存。它有两个硬性要求:
- 缓冲区的地址必须按逻辑块大小对齐(本项目用
posix_memalign(&buf, 4096, size)) - 读写长度和文件偏移也要对齐
实测:
| 场景 | 耗时 (s) | 吞吐 (MB/s) | rchar (字节) | read_bytes (字节) | 设备读 (MB) |
|---|---|---|---|---|---|
| O_DIRECT 128K | 0.7153 | 1431.6 | 1073742575 | 1073741824 | 1024.0 |
注意它比冷读还慢(0.7153 对 0.2664)。
这个结果初看反直觉:绕开缓存不是应该更快吗?
原因在于预读。普通 read() 即使缓存没命中,内核也在背后做顺序预读:读当前位置的数据时,顺手把后面一段也读进来,下一次读就直接命中了。等于内核在帮你把延迟藏起来。O_DIRECT 放弃了页缓存,同时也就放弃了预读,每次都得实打实地去设备拿。
O_DIRECT 的价值不在于「更快」,而在于「可控」:它让 I/O 的时机和数量完全由程序决定,不被内核的缓存策略干扰。数据库这类自己管理缓存的软件才需要它。
三条路径的指纹
把三者的差异压缩成一句话:看 rchar 和缺页这两个计数器,就能认出是哪条路。
1 | read() rchar ≈ 读取量 数据是拷回来的 |
read() 和 O_DIRECT 的 rchar 看起来一样,区分它们的是 read_bytes:read() 在热读时能做到 0,O_DIRECT 永远做不到。
第五章 一个意外发现:缺页次数不等于访问页数
这一章是实验过程中撞出来的,不在原计划里,但它值得单独讲,因为它揭示了一个和第一章同一类型的错误:把某个计数器当成它字面上看起来的意思。
问题的起点
mmap 那条路径的缺页计数看着很不对劲。
文件 1 GiB,逐页触碰一遍(每 4 KiB 触一次,共 262144 次)。按理说,每一页第一次访问都要触发一次缺页,那就该有 262144 次缺页。
实测:915 次。
差了 286 倍。第一反应是计数器读错了,于是从两个独立来源各读一遍:
1 | getrusage minflt: 917 |
两个来源一致。而且重复跑五次,结果是 915 / 915 / 916 / 916 / 915,波动只有一次。
所以数字是对的,是我对「缺页」的理解错了。
验证一:它和访问顺序有关
如果一次缺页能覆盖多页,那么「覆盖多少页」应该取决于内核能提前准备多少页。而内核提前准备的量,取决于它能不能预测你要访问哪里。
于是做一个对照实验:同一个文件、同一次 mmap、同样逐页触碰,只改访问顺序。
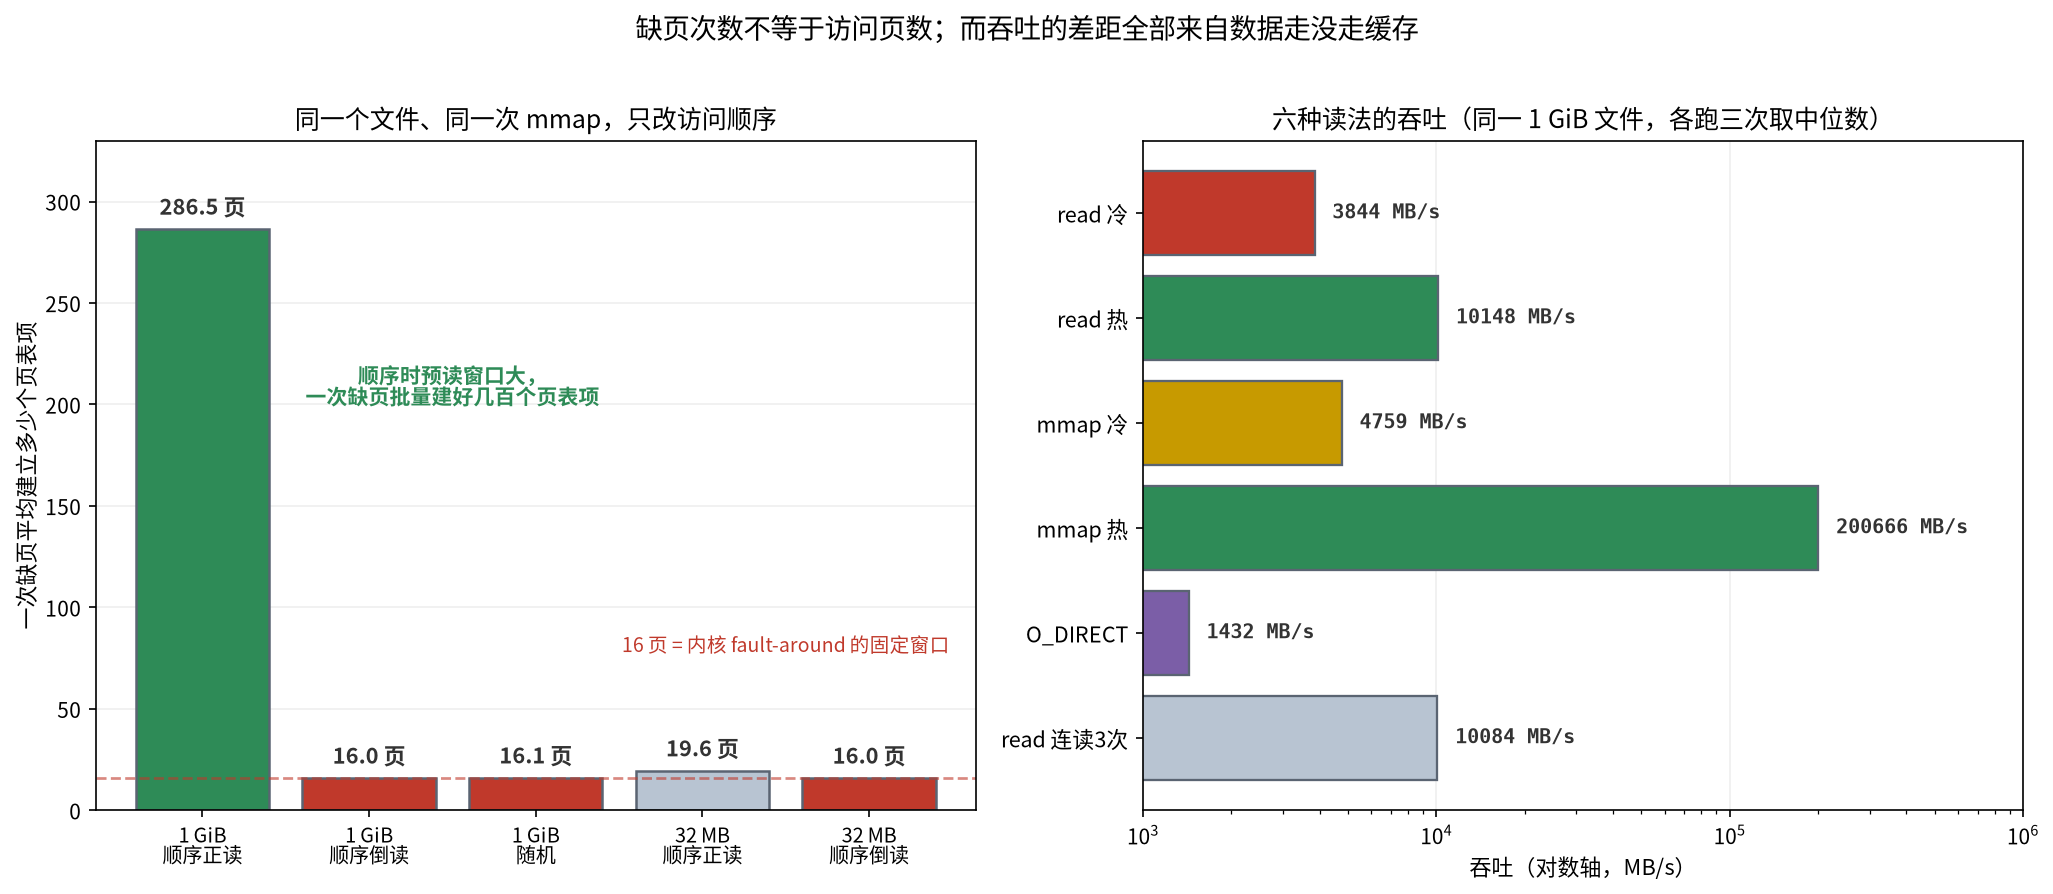
| 文件 | 访问顺序 | 页数 | 缺页次数 | 每次缺页覆盖 |
|---|---|---|---|---|
| 1 GiB | 顺序正读 | 262144 | 915 | 286.5 页 |
| 1 GiB | 顺序倒读 | 262144 | 16382 | 16.0 页 |
| 1 GiB | 随机 | 262144 | 16266 | 16.1 页 |
| 32 MB | 顺序正读 | 8192 | 418 | 19.6 页 |
| 32 MB | 顺序倒读 | 8192 | 511 | 16.0 页 |
结论很干净:
- 顺序访问:内核识别出这个模式,提前把后面一大段读进内存,一次缺页可以顺手把几百个页表项都建好。
- 逆序或随机访问:内核无法预测,退化成固定窗口,每次缺页恰好覆盖 16 页。
那个 16 不是巧合。它是内核 fault_around 机制的默认窗口大小:当一页缺页时,内核会顺便把它周围一片页的映射一起建好,默认窗口是 64 KiB,正好 16 个 4 KiB 页。验证方式是拿小文件测:1 MB 到 16 MB 的文件,无论多大,都精确是 16.0 到 16.5 页:
1 | 文件 1.0 MB 页数 256 首次缺页 16 每缺页覆盖 16.0 页 |
16 × 16 = 256,64 × 16 = 1024,255 × 16 = 4080,都和页数对得上。
验证二:排除大页的干扰
顺序访问那个 286 页的批量很大,是一个自然的怀疑对象:是不是透明大页(THP)在起作用?
这台机器的 THP 是开着的(/sys/kernel/mm/transparent_hugepage/enabled = [always]),而且 smaps 里确实能看到大页映射:
1 | FilePmdMapped: 1007616 kB ← 984 MB 的文件内容是用 2 MB 大页映射的 |
那就做个对照,显式关掉这个映射的大页:
1 | madvise(m, size, MADV_NOHUGEPAGE); |
结果:
1 | 不关大页: 缺页 915 / 916 / 915 |
一模一样,一次都没变。
所以 286 页这个批量不是大页造成的。FilePmdMapped 那 984 MB 是另一回事(它统计的是页表用了多大的粒度),和缺页次数没有因果关系。
正确的解释
把两条验证合起来:
- 批量大小随访问顺序变化(顺序 286 页,逆序/随机 16 页)
- 关掉大页不改变任何结果
那么批量的来源只能是预读窗口:顺序访问时预读一直往前跑,页缓存里常驻着一大段数据;缺页时内核发现周围这些页已经在内存里,就一次性把它们的映射全建好,不用一页一页来。
这个批量的上限是动态的,取决于内核当前把预读窗口开到了多大。 它不是一个文件属性,也不是一个固定常数。
这条发现的实用价值
它推翻的是一个很常见的性能分析习惯:
「这个程序缺页很多,说明它在大量访问没缓存的数据。」
从前面的数据看,这句话在两个方向上都可能错:
- 缺页多不代表访问的页多。16266 次缺页对应的是 262144 页,比例是 1:16。
- 反过来,缺页少也不代表访问少。915 次缺页对应的是整整 1 GiB 数据,每一次缺页背后是 286 页的真实工作。
正确读法是:缺页次数衡量的是「内核为你做了多少次映射工作」,不是「你访问了多少数据」。 想知道后者,得看 rchar 或者别的计数器。
同样的坑在 majflt 上也存在。这次实验里 majflt 几乎全程是 0,即使在做冷读、真的从磁盘拿数据的时候。原因类似:顺序读取时,内核的预读把数据批量读进来,缺页发生时数据往往已经在内存里了,于是记为次缺页。majflt = 0 不代表没有磁盘 I/O。
第六章 证据能推出什么,推不出什么
前面几章给了不少结论。这一章专门讲这些结论的边界,哪些是证据支持的,哪些是推断,哪些根本推不出来。
这一节和前面一样重要。一份只有结论没有边界的分析,读者照着用到别处就会翻车。
能确定推出的
其一:页缓存确实替进程承担了全部读取工作。
三路独立证据同时指向这个结论:
- 进程层:
read_bytes= 0(内核记录「这个进程没有从块设备取字节」) - 页层:
mincore()报告 262144/262144 页驻留 - 设备层:
diskstats的 sda 读扇区增量为 0
这三条分别由不同的内核子系统维护,出错方向各不相同。三者一致,结论可靠。
其二:read() 的耗时差异确实来自缓存层,而不是别的地方。
论证方式:冷读和热读的系统调用序列逐字相同(第三章的 trace 对照)。既然系统调用这一层没有任何差别,差异只能发生在它下面;而下面各层里,唯一被独立证据证明发生了状态变化的就是页缓存。
这是一条排除法论证,但它比单纯的「耗时短所以是缓存」强得多,因为它先排除了同一层内的其他解释。
其三:mmap 和 read 的差异是结构性的,不是性能调优级别的。
rchar 从 1073742573 掉到 749,差了六个数量级。这不是「快一点」,而是数据根本没有流经 read() 这条路径。这个差异由接口设计决定,换机器、换文件系统都不会消失。
不能推出的
其一:rchar - read_bytes 并不总是「缓存省下的字节」。
这是最容易踩的一个坑,因为第二章那个公式看起来很自然。实测一下就会发现它会崩:
只读 4 KiB,看这次 read() 造成的增量:
1 | rchar +4189 |
read_bytes 比 rchar 大,差值是个负数。放大倍数分别是:读 4 KiB 时 3.9 倍,读 64 KiB 时 4.0 倍,读 1 MiB 时 2.0 倍。
原因就是预读。你只要 4 KiB,内核顺手读了 16 KiB。
连续读 8 次 4 KiB 更能看清这个过程(每次都只读 4 KiB):
1 | 第1次: read_bytes +16384 窗口开了 16 KiB |
八次要了 32 KiB,设备上实际读走 320 KiB。预读是自适应的:命中一次就加大窗口,所以增量是一整块一整块地来的,并不均匀。
所以那个公式要加个前提:rchar - read_bytes 表示「净缓存收益」,只在读完整个文件(或稳态连续读取)时才等于「省下的字节」。 局部小读时它可能是负数,因为内核在为未来投资。
其二:这台虚拟机的「物理读」不是真的物理读。
这是虚拟化环境特有的坑,而且很隐蔽。
实验里有一组数据我看第一遍时觉得不对:用 O_DIRECT 读一个刚写完的文件,测出 3.3 GB/s。这个速度远超这台虚拟机的磁盘能力。
原因在于:虚拟机的磁盘是宿主机上的一个文件。 虚拟机里的「块设备读」,到了宿主机上可能只是一次内存拷贝,因为宿主机自己也有一层页缓存。
后果是:在这个环境里测出的「冷读」速度,反映的是宿主机的缓存状态,不是真实磁盘的性能。
这不影响本文关于机制的结论(页缓存命中与否、rchar 与 read_bytes 的语义、mmap 不走 read(),这些都是客户机内核的行为,与后端是不是虚拟磁盘无关)。但只要涉及绝对性能数字,就必须注明环境。本文表里的 MB/s 都只在这台机器、这个 KVM 配置下成立。
其三:diskstats 的增量归属不到具体进程。
/proc/diskstats 是设备级计数。本次实验期间没有别的负载,所以可以认为增量全部来自被测进程。但在有并发 I/O 的机器上,这个增量是所有进程共享的,不能直接归给某一个。
需要进程级归属时得换工具,iotop、bpftrace 的 biolatency/iosnoop,或者 cgroup 的 io.stat。它们在这台机器上要么没装、要么需要 root。
其四:精确的 folio 粒度无法确定。
第五章确认了批量来自预读窗口而不是大页,但没有测出内核实际用的是多大的 folio。能查到 /proc/meminfo 的 FileHugePages: 1189888 kB(说明这个文件确实被多页 folio 缓存着),但要读具体的 folio 阶数需要 debugfs,而这台机器上 debugfs 没挂载、也拿不到 root。
所以第五章给出的结论精确到「批量由预读窗口决定」为止,再往下就没有证据支撑了。
边界汇总
| 结论 | 证据强度 | 边界 |
|---|---|---|
| 页缓存承担了全部读取 | 强(三路独立) | 无 |
| 冷热差异来自缓存层 | 强(排除法 + 直接计数) | 无 |
mmap 不走 read() |
强(rchar 六个数量级差) |
无 |
| 缺页批量由预读窗口决定 | 中(顺序对照 + 大页排除) | folio 阶数未测出 |
| 具体吞吐数字 | 弱(单机单次) | 仅本环境成立,宿主缓存有干扰 |
diskstats 归因 |
中 | 需无并发负载才成立 |
有一点想说明:把「中」和「弱」的结论也列出来、并写清边界,不会削弱文章的说服力。相反,它让「强」那几条更可信,因为读者知道作者是真的在区分,而不是把所有结论都写成同等肯定。
第七章 实现:把分析沉淀成工具
这一章把前面用的东西固化成可复用的工具。总共三件,都是单文件 C,gcc 直接编译,不需要 root,不需要装任何依赖。
这个前提本身就值得说一句:这台机器上 strace、perf、blktrace 一个都没装,sudo 也要密码。 如果分析能力依赖于「先装一套工具」,那么在受限环境里就什么都做不了。而内核在 /proc 和系统调用层面暴露的接口,非特权进程就能用,缺的只是一个把它们串起来的程序。
工具一:minitrace,自己写的最小追踪器
ptrace 是这个工具的支点。它本来是给调试器用的:让一个进程停下来,另一个进程检查它的寄存器和内存。追踪自己 fork 出来的子进程不需要任何特权。
1 | /* @Moxin1044 2026-10-15 |
三个关键点:
PTRACE_O_TRACESYSGOOD。 不加这个选项,系统调用停止和普通信号停止在 waitpid 返回值里长得一样,追踪器会被信号干扰得一团乱。加上之后系统调用停止会多一个 0x80 位,一个判断就能滤干净。
进 / 出交替。 PTRACE_SYSCALL 每放行一次,子进程就在下一个系统调用边界停住。停奇数次数是「进入」,偶数是「退出」。参数只在进入时有效,返回值只在退出时有效,这个交替是追踪器最容易写错的地方。
读字符串要分块。 要打印 openat 的路径名,得从子进程内存里读。PTRACE_PEEKDATA 一次只能读一个机器字,所以得循环读、逐块查 \0。本文的精简版为了可读性把这块省略了,直接打印参数值。
这个工具立刻给了一个反直觉的结果
拿它去追 cat,本来想看一次「经典的文件读取」,结果看到的是:
1 | openat (AT_FDCWD, ..., 0x0) = 3 |
没有 read。 一个都没有。
现代 coreutils 的 cat 在检测到「文件到文件」的拷贝时,走的是 splice(),一个零拷贝接口。数据从文件描述符直接搬到管道,再搬到标准输出,中间根本不进入用户态缓冲区,所以也不需要 read()。
这个发现有两层意义:
- 具体层面:「读文件」这件事不必然经过
read()。 想看真实的读取路径,得用自己控制的程序,不能拿cat当样本。 - 抽象层面:这也是本文反复出现的那类错误的又一个实例:工具的名字和它实际调用的系统调用之间,没有必然联系。 只靠猜是猜不到的,必须测。
工具二:cacheproof,一次读取走没走缓存
第二个工具把第二章的四类证据打包在一起,一条命令给出结论。
1 | /* @Moxin1044 2026-10-15 |
在一个 1 GiB 文件上的实际输出:
冷读(--cold,先驱逐):
1 | 冷启动确认:0/262144 页驻留 |
热读(紧接着再跑一次):
1 | 读取字节 : 1073741824 |
注意冷读那次的 minflt=0 majflt=0,一次缺页都没有。但这不代表没读数据,那 1 GiB 确实从磁盘上来了(read_bytes 和 diskstats 都能证明)。原因就是第五章那个发现:用 read() 而不是 mmap() 时,数据由内核拷贝到用户缓冲区,页缓存的填充发生在内核自己的地址空间里,不经过进程的缺页异常。
这一条再一次说明:任何单一的计数器都可能给出误导性的信号,必须交叉验证。
工具三:readbench
第三个工具是把前面的测量组织成可对照的实验台:同一个文件跑 read() / mmap / O_DIRECT 三条路径,每组重复三次取中位数,输出 JSON 方便二次分析。它复用的就是 cacheproof 里的那几个采集函数,加上 posix_memalign 对齐缓冲区(O_DIRECT 的硬要求)和不同的访问循环。
三件套的分工
| 工具 | 回答的问题 | 关键手段 |
|---|---|---|
minitrace |
它到底调了哪些系统调用 | ptrace 单步拦截 |
cacheproof |
这一次读取走没走缓存 | 四路计数器交叉验证 |
readbench |
三条路径的差异有多大 | 受控对照 + 重复取中位数 |
三件事合起来就是一套完整的取证链:先看它调了什么,再验证数据从哪来,最后量化差异。
第八章 一套可复用的诊断流程
把前面的方法整理成可以照着走的步骤。
第一步:先问清楚要回答哪个问题
这一步经常被跳过,结果是忙了半天没答到点上。三个问题对应三套完全不同的做法:
- 「它调了哪些系统调用?」 → 用
minitrace这类追踪器。 - 「数据是从缓存还是磁盘来的?」 → 用
cacheproof这类计数器工具。 - 「慢在哪里?」 → 这个最难,需要时间维度,得用采样类工具(
perf)或分阶段插桩。
第二步:把环境钉住
任何性能结论都必须带上环境。至少要记录:
1 | 内核版本 uname -r |
缺少任何一项,结论就只能在这个环境里成立,换台机器不保证复现。本文所有吞吐数字都只属于文末那份环境清单。
第三步:确保「冷」是真的冷
不要假设缓存没了,要验证:
1 | 用 posix_fadvise(fd, 0, 0, POSIX_FADV_DONTNEED) 驱逐 |
看到 0/262144 页驻留 才算冷。如果 mincore 还报有页驻留,说明驱逐失败(比如文件在别的挂载点上,或者有别的进程刚把它读回来了),这时的「冷热对比」是无效的。
第四步:用计数器交叉验证,不要只看耗时
至少取两项独立证据。推荐组合是 read_bytes(进程视角)加 diskstats(设备视角),两者由不同子系统维护,同时出错的可能性极低。
耗时只作为辅助参考。 本实验里冷热耗时只差 2.6 倍,而 I/O 量差到无穷大。耗时对「走没走缓存」这个问题的分辨力很弱。
第五步:对不上就先怀疑自己的理解
第五章那个「缺页 915 次对 262144 页」的异常,第一反应应该是「我这个计数器理解错了」,而不是「数据有问题」。做法是:
- 换一个独立来源读同样的量(
getrusage对/proc/self/stat) - 重复几次看稳定性
- 做对照实验找出因果(改访问顺序、关大页)
- 只有前三条都过了,才承认这个反直觉的数字是对的
这次流程走完,得到的是一个真结论(批量由预读窗口决定),而不是一个被误读的数字。
第六步:写清边界
结论分三档写:证据强的、证据中等的、单机观察的。前面第六章那张表就是模板。
把边界写出来反而提升可信度,因为读者能看出作者在区分「测出来的」和「推出来的」。
一个快速决策清单
1 | 要追系统调用? |
附录 A:实验环境
本文所有数据来自这台机器,一次完整的实验记录:
1 | 内核版本 Linux 7.2.7-arch1-1 |
重要提示:big.bin 不能放在 /tmp,这台机器的 /tmp 是 tmpfs,也就是内存文件系统,在上面测不出任何块设备 I/O,读多少次 read_bytes 都是 0。这个坑很隐蔽,因为一切看起来都正常。
几个必须跟着结论一起讲的限制
宿主缓存。 这是虚拟机的固有干扰。虚拟机的「虚拟磁盘」是宿主机上的文件,客户机发出的「块设备读」在宿主机上可能只命中宿主机的页缓存。实测证据:用 O_DIRECT 读一个刚写完的文件,跑出 3.3 GB/s,远超这台虚拟机的磁盘能力,说明数据实际来自宿主内存。
因此:机制层面的结论不受影响(那是客户机内核的行为),但绝对性能数字只在这个环境下成立。
无法完全排除的干扰。 实验期间没有刻意制造并发负载,也没有做 CPU 绑核或频率固定,所以表里的 MB/s 含有一定噪声。三次重复的耗时波动在 5% 以内,这个量级的变化不影响任何一条结论的方向。
没有 root 的代价。 perf、blktrace、ftrace、debugfs 都不可用,所以拿不到块层的详细统计、也读不到 fault_around_bytes 的实际值和 folio 的阶数。第五章的结论到「预读窗口决定批量」为止,再往下没有证据。
附录 B:复现步骤
全部命令不需要 root:
1 | # 1. 准备测试文件。注意不能放 /tmp(那是 tmpfs) |
复现时最值得自己动手改的两处:把测试文件换成你实际在意的那个,以及把 disk_read_sectors() 里 maj == 8 && min == 0 换成你这台机器根文件系统所在设备的主次设备号(lsblk -o NAME,MAJ:MIN 可以查)。不改这一处,设备级证据会一直是 0。
参考资料
man 2 read/man 2 mmap/man 2 open:三个接口的语义、返回值、错误码,以及O_DIRECT的对齐要求。man 2 posix_fadvise:POSIX_FADV_DONTNEED的确切语义:只影响指定文件的指定区间,不干扰其他进程。这是非 root 条件下制造「冷读」的关键依据。man 2 mincore:逐页查询驻留状态,本文页缓存层证据的来源。man 2 ptrace与PTRACE_O_TRACESYSGOOD的说明:追踪器实现的依据;0x80标志位的用法在这里有正式定义。Linux 内核文档
Documentation/filesystems/proc.rst:/proc/self/io各字段的正式定义,特别是rchar(含缓存命中)与read_bytes(只计块设备)的区别,这是本文全部证据链的起点。Linux 内核文档
Documentation/admin-guide/blockdev/stat.rst:/proc/diskstats的字段含义与单位(扇区数,512 字节)。man 5 proc:/proc/diskstats与/proc/stat的字段布局;本文disk_read_sectors()解析的就是其中的第 6 个字段。coreutils 的
cat实现:splice路径的引入背景。本文是用minitrace实测到splice而非read的,源码可作为对照确认。
文中所有数据均为本机实测;三个工具的源码在文末附录给出,可自行编译复现。