高并发 API 服务的瓶颈究竟在哪里:连接池、线程池、事件循环与背压
一个 API 服务在低负载下跑得好好的。请求量涨上来,吞吐量跟着涨;再涨,吞吐量不动了,P99 开始往上爬。继续加压,超时、连接池耗尽、503 接连出现。
这时候最自然的反应是去调参数:线程数加一点,连接池开大一点,事件循环换个更快的实现。这些调整有时候确实管用,有时候只是把问题挪了个位置,还有时候会让情况更糟。
本文要回答的是一个前置问题:在动手之前,怎么知道瓶颈在哪一层。至于「参数该设多少」,那是找到瓶颈之后的事。为了让结论可检验,我在一台 4 核虚拟机上搭了一个模拟下游处理时间的服务,把连接池、并发度、worker 数、队列容量逐个拉出来单独改,记录每一次的吞吐量、延迟分位数、队列深度和错误码。文中所有数字都是这台机器上跑出来的,环境和复现脚本放在文末。
先说一个贯穿全文的结论,它由后面的实验支撑:
系统的容量由「能并行执行多少工作」乘以「每份工作多快」决定,这个数在你改代码之前就定死了。超过它的那些请求不会让系统做更多事,只会去某个队列里排队。而排队这件事,在平均响应时间这个指标上是看不出来的。
一、问题的本质:并发增加,为什么延迟反而越来越高?
先看一组实测数字。服务端配置 32 个 worker、每个任务模拟 50 毫秒的下游处理时间,客户端并发度从 10 加到 400:
| 客户端并发度 | 成功吞吐量 | P50 延迟 | P99 延迟 | 服务端记录的排队时长 |
|---|---|---|---|---|
| 10 | 188.5 req/s | 52.5 ms | 56.2 ms | 0.08 ms |
| 25 | 470.2 req/s | 52.3 ms | 59.8 ms | 0.06 ms |
| 50 | 622.3 req/s | 91.1 ms | 104.0 ms | 38.1 ms |
| 100 | 620.3 req/s | 153.9 ms | 197.5 ms | 98.7 ms |
| 200 | 615.2 req/s | 311.6 ms | 356.2 ms | 253.7 ms |
| 400 | 613.0 req/s | 623.6 ms | 665.4 ms | 567.9 ms |
并发度从 10 涨到 50,吞吐量涨了 3.3 倍,延迟几乎没动。从 50 涨到 400,并发度翻了 8 倍,吞吐量反而略微下降(622 掉到 613),而 P50 延迟涨了 6.8 倍。
多出来的那 350 个并发没有让系统做更多事,它们排在了同一个队列里。表里最后一列就是证据:服务端自己记录的排队时长从 38 毫秒涨到 568 毫秒,跟总延迟的增长几乎是同一个数。
这就是过载。它跟参数调得好不好没有关系,根源是请求到达的速度超过了一项固定能力。
几个容易混在一起的概念
在往下走之前,先把几个词分清楚。它们经常被当作同义词用,而混用的代价是找错方向。
| 概念 | 含义 | 不能据此推断什么 |
|---|---|---|
| 并发 | 同一时间存在多个尚未完成的任务 | 不代表这些任务同时执行 |
| 并行 | 多个任务在同一时刻真正执行 | 不代表吞吐量会线性增长 |
| 吞吐量 | 单位时间内完成的工作量 | 不代表每个请求都很快 |
| 响应时间 | 请求从发出到完成的耗时 | 不等于实际执行时间 |
| 在途请求 | 已进入系统、尚未结束的请求数 | 不等于正在消耗 CPU 的请求数 |
并发是组织工作的方式,并行是执行状态,吞吐量和延迟是系统表现。三者之间没有必然的换算关系:一个系统可以有 1000 个并发连接却只在一个核上跑,也可以有 4 个并发任务却把 4 个核都占满。
最常见的误判是把「并发高」直接读成「CPU 忙」。后面第六组实验会看到一个极端的例子:32 个 worker 全部处于忙碌状态,CPU 也没闲着,但实际有效吞吐量只有理论值的 3%。
二、从一次 API 请求看系统中的等待
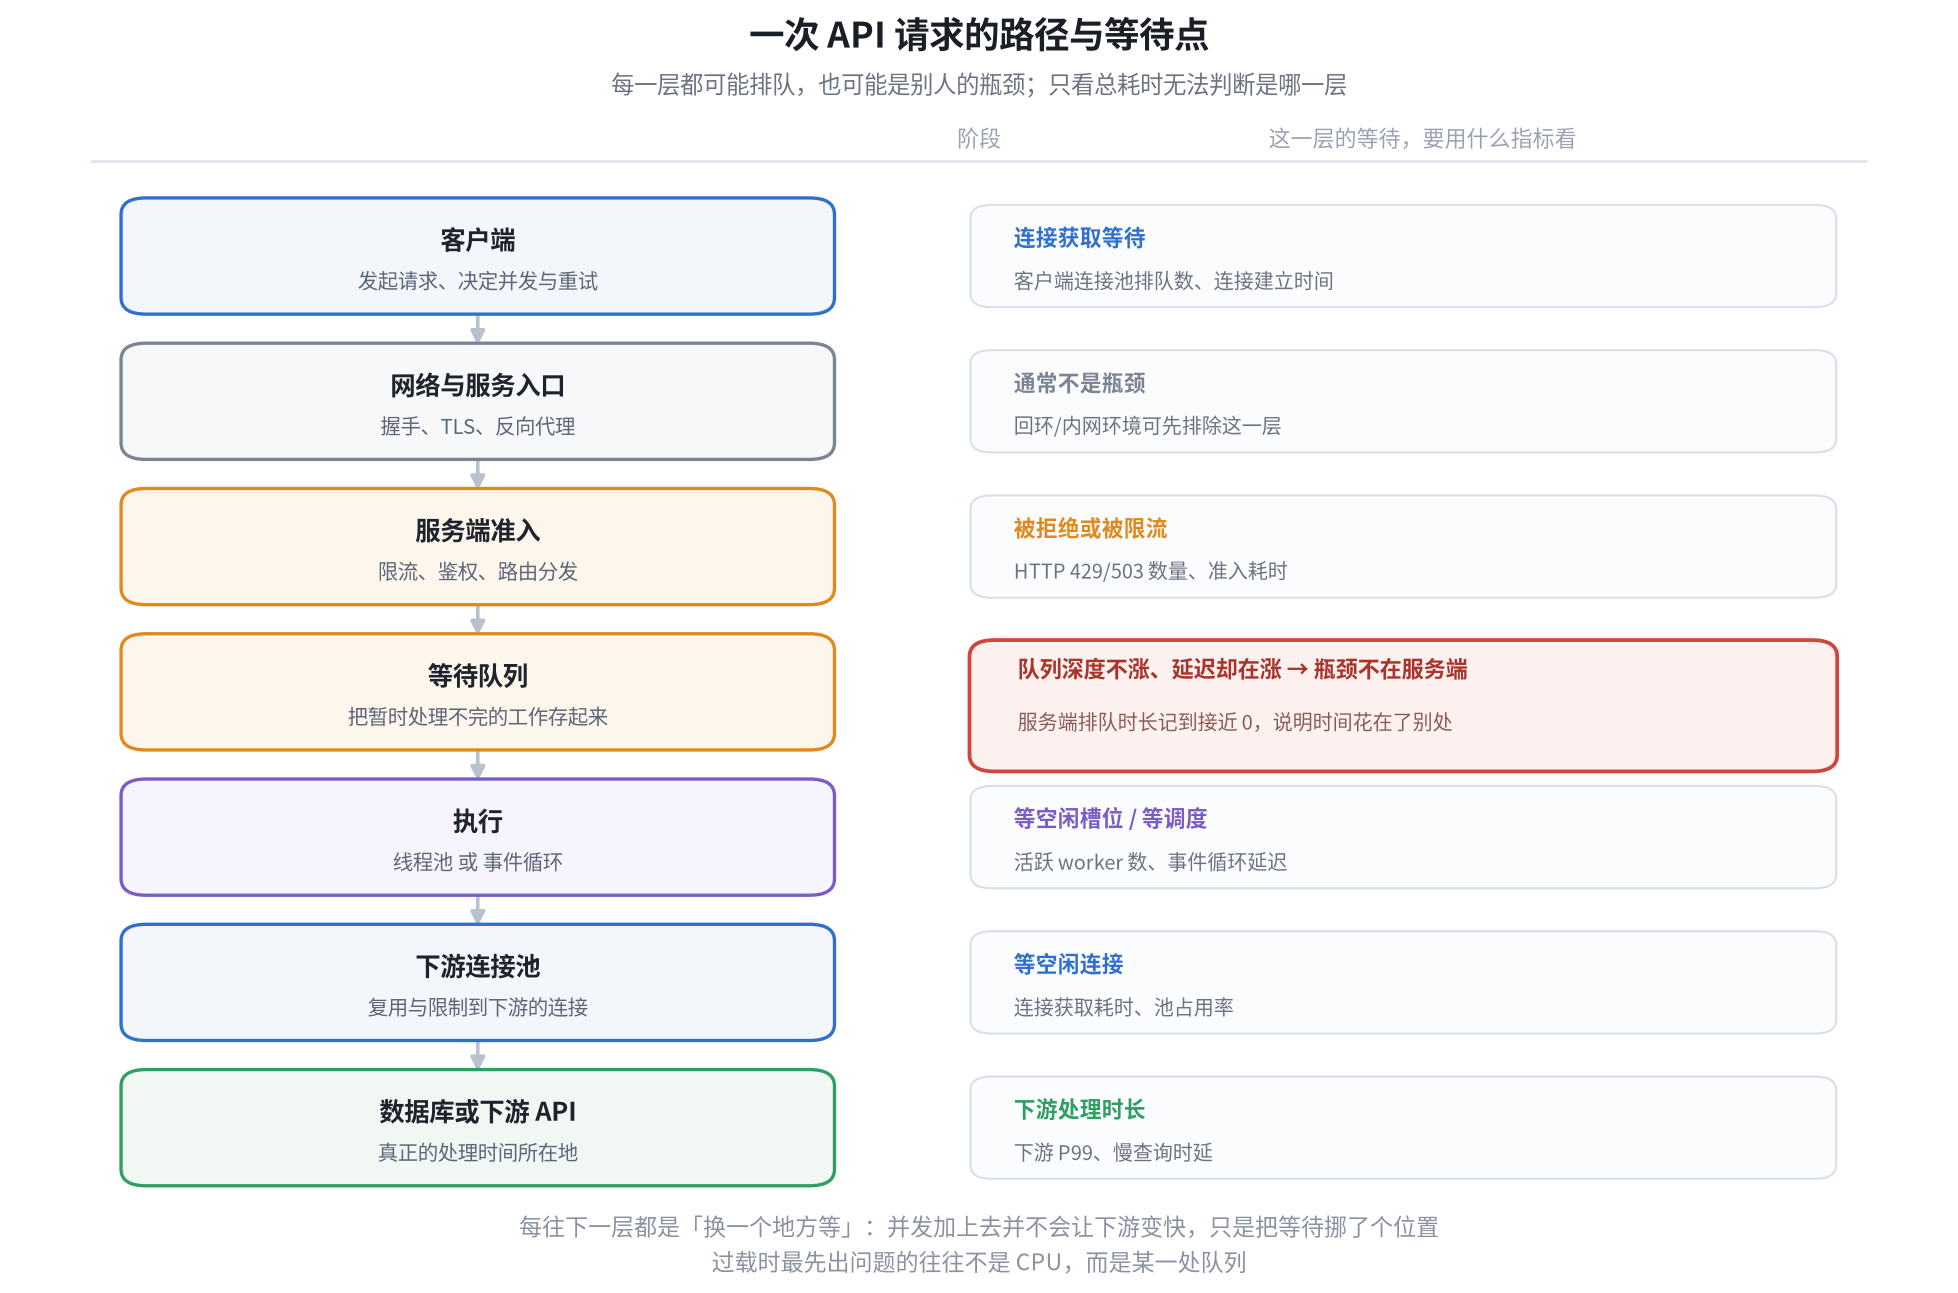
分析性能问题,第一步是把请求路径画出来,标出每一处可能产生等待的位置。指标要等有了这张图再看。
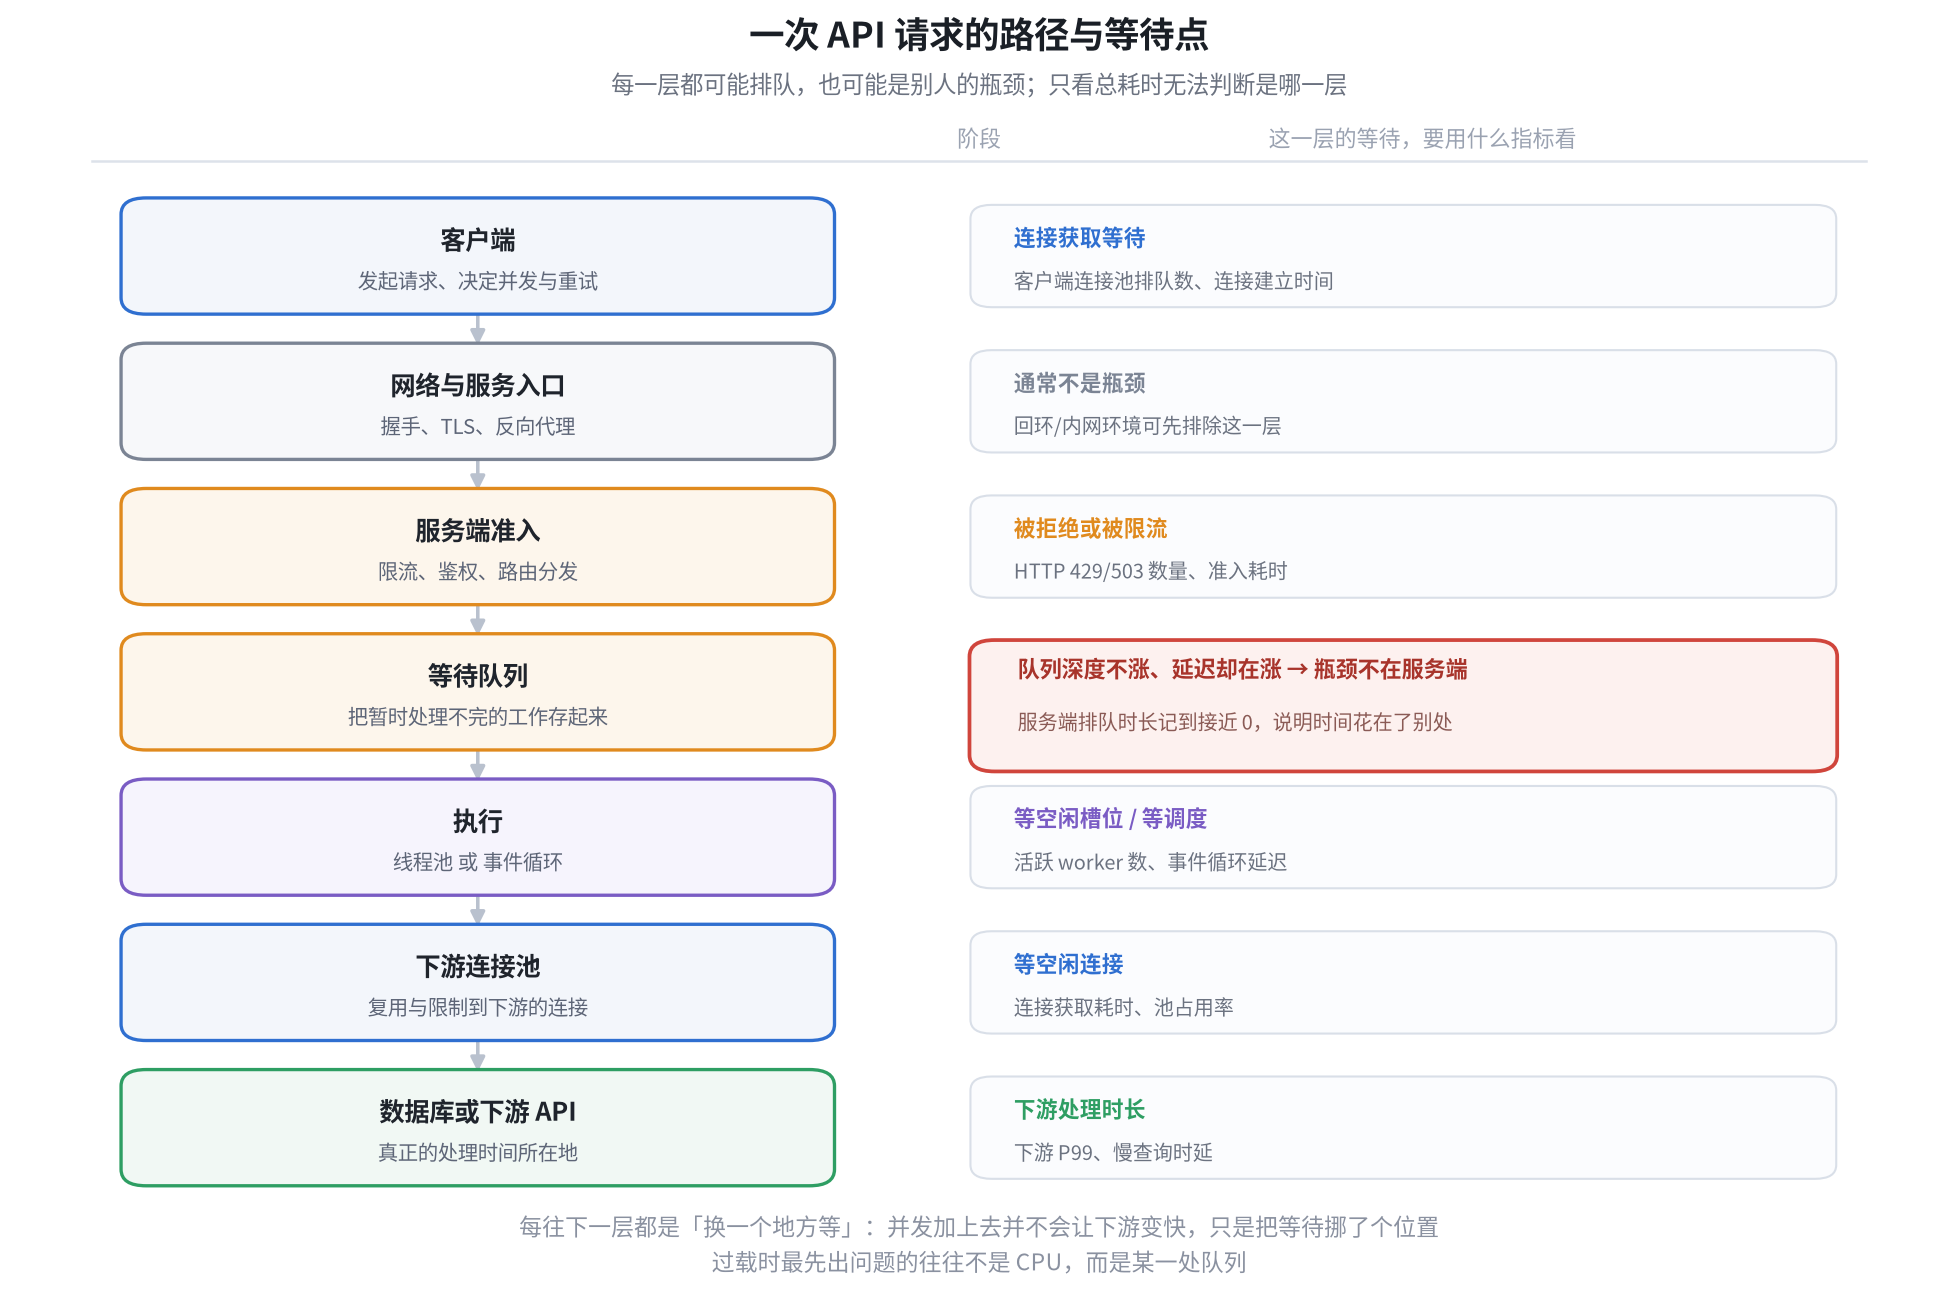
这张图想说的是:一次请求延迟里的每一毫秒,都归属于其中某一层。而这些层各自有自己的队列、自己的容量、自己的失败方式。
一次请求的总延迟可以粗略拆成:
1 | T_total = T_客户端连接池 + T_网络 + T_服务端准入 |
这个式子是个便于分析的分解模型,不是精确公式。真实系统里这些阶段会重叠,连接会复用,下游可能并行发起。但它的价值在于引导出一个具体的问题:
上面哪一项正在变大?
如果客户端连接池等待变长,去看客户端的池上限和连接建立时间;如果服务端队列深度在涨而执行时间没变,说明到达速率已经超过处理能力;如果事件循环的调度延迟在涨,去看有没有同步阻塞调用。
只看 API 的平均响应时间,这些问题一个都回答不了。平均值把所有阶段搅在一起,恰好抹掉了最需要的信息。
后面几章会依次把这里面最容易误判的几层拉出来,用实验数据说清楚它们各自是怎么失败的。
三、异步模型、线程池与连接池:它们解决的是不同问题
这三个东西经常被放在一起讨论,好像它们是同一类东西的三个选项。实际上它们管的不是一回事:事件循环管怎么调度,worker 管能同时执行多少,连接池管能同时占用多少下游资源。搞混这三个,就会出现「加了线程数但吞吐量没涨」或者「连接池开到 1000 反而更慢」这类结果。
3.1 异步 I/O 不等于请求可以无限执行
拿 Python 的 asyncio 举例。协程遇到可挂起的异步操作会让出执行权,事件循环转去处理其他就绪任务。下面这段代码创建 100 个协程:
1 | import asyncio |
asyncio.sleep() 不会阻塞事件循环线程,所以这 100 个任务几乎同时开始等待,整段代码大约 0.1 秒跑完。
但要注意:这里创建的是 100 个协程任务,不是 100 个并行执行的 CPU 工作线程。它们同时在等待,不是同时在做计算。
现在把 await asyncio.sleep() 换成 time.sleep()。任务数量、逻辑、服务时间都不变,唯一差别是那个 await:
1 | import asyncio |
这三个任务会依次执行,总耗时约 3 秒。因为 time.sleep() 不让出执行权,事件循环线程被占死,其他两个协程根本没机会开始。
这个差别在单个请求上可能看不出来,放到并发场景里就是数量级的差距。我把这一条做成了对照实验:同一个服务、同样的 32 个 worker、每个任务 20 毫秒,只把 await asyncio.sleep(SERVICE_TIME) 换成 time.sleep(SERVICE_TIME):
| 实现 | 成功吞吐量 | P50 延迟 | P99 延迟 | 服务端记录的排队时长 |
|---|---|---|---|---|
await asyncio.sleep |
1483.2 req/s | 129.2 ms | 147.1 ms | 103.6 ms |
time.sleep |
48.2 req/s | 4141.7 ms | 4163.8 ms | 1197.4 ms |
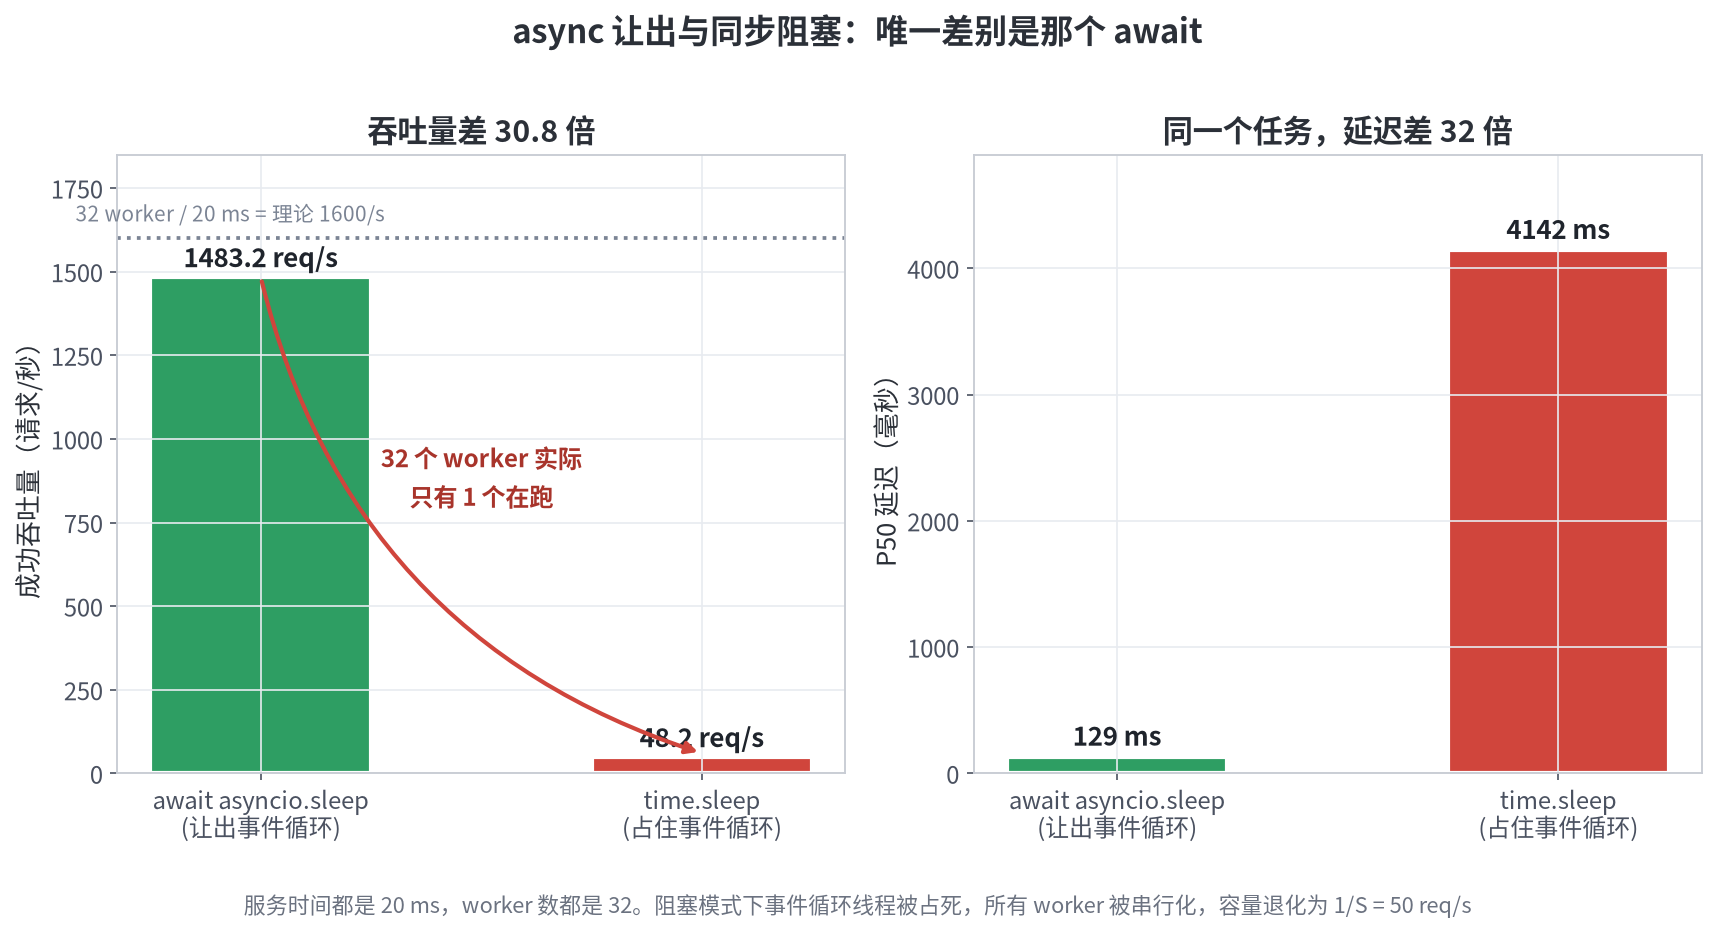
吞吐量差 30.8 倍,延迟差 32 倍。
关键在于怎么解释这个数:32 个 worker、每个任务 20 毫秒,理论上应该是 32 ÷ 0.02 = 1600 req/s。实测 48.2,接近于 1 ÷ 0.02 = 50。
也就是说,32 个 worker 在阻塞模式下退化成了 1 个。它们名义上都在「忙碌」,实际上排着队等同一个被占住的线程。/metrics 里的活跃 worker 数全程显示 32,这个指标完全没反映出问题。
这里有个值得记住的点:「worker 都在忙」不等于「系统在有效工作」。忙碌是一个状态,有用是另一回事。后面第五章会看到同一个陷阱的另一种形式。
Python 官方文档对 asyncio 的说明在参考资料里。如果确实需要调用阻塞型函数,可以用 asyncio.to_thread() 或专用执行器把它挪到线程里去。但这只是把阻塞挪了个地方,不会让任意 CPU 密集型 Python 代码自动获得线性加速,线程池本身也有容量和调度成本。
3.2 worker 数和服务时间共同决定容量
异步和阻塞只是其中一个变量。真正决定吞吐量天花板的,是能同时执行多少份工作以及每份工作要多久。对于一个固定服务时间、固定 worker 数的模型:
1 | μ ≈ N / S |
其中 N 是 worker 数,S 是单个任务的服务时间。这是个理想化估算,忽略了调度开销、内存分配、锁竞争等等。
实测验证一下。服务时间固定 50 毫秒,worker 数取 2、4、8、16、32:
| worker 数 | 理论容量 N/S | 实测成功吞吐量 | 偏差 |
|---|---|---|---|
| 2 | 40 req/s | 38.7 req/s | -3.2% |
| 4 | 80 req/s | 77.8 req/s | -2.8% |
| 8 | 160 req/s | 154.9 req/s | -3.2% |
| 16 | 320 req/s | 309.0 req/s | -3.4% |
| 32 | 640 req/s | 617.2 req/s | -3.6% |
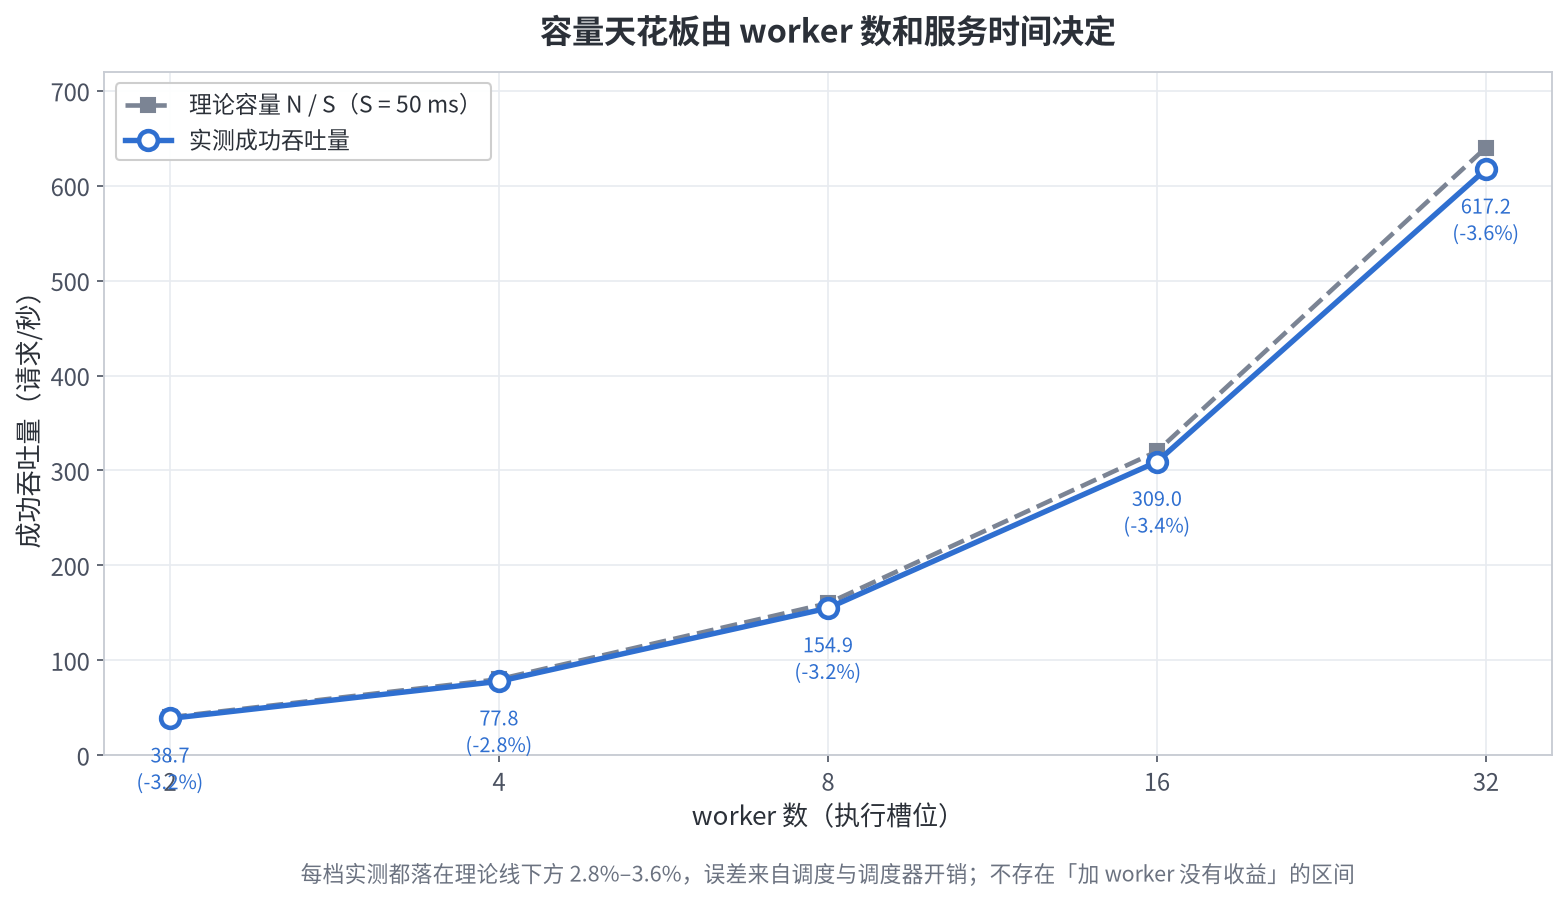
五档全部落在理论线下方 2.8% 到 3.6%,而且偏差随 worker 数缓慢增大(调度开销随并发数增长)。线性关系成立得很干净,没有出现「加 worker 没有收益」的区间。
这张表的价值在于它给出了动手之前就能算出的天花板。如果你的服务是 32 个 worker、每次下游调用 50 毫秒,那它不可能超过 640 req/s,无论客户端并发开多大、网络多快、客户端多强。想提高这个数,只有三条路:减少 S(让下游变快)、增大 N(加 worker,前提是下游扛得住)、或者减少每个请求要做的下游调用次数。
顺便说一句,这里的 3% 偏差本身就值得留意。「理论上限」和「实测上限」之间总有一条缝,缝里是调度器和内存分配的开销。做容量估算时把这条缝留出来,比事后解释为什么差 3% 要从容得多。
3.3 线程池限制的是工作执行能力
线程池和上面的 worker 是同一回事:它决定了能同时执行多少份工作。
任务到达速率持续高于线程池处理速率时,任务会等待空闲线程。增加线程数在一种情况下确实有效:工作线程大量时间花在等 I/O 上。如果线程都在等下游响应,加线程能让更多请求同时在途。
但线程不是越多越好,多出来的线程会带来几项开销:
- 更多的调度和上下文切换成本
- 每个线程的栈内存,以及线程相关的内核资源
- 更激烈的锁竞争
- 对数据库连接、文件描述符这类下游资源的额外压力
所以线程池的合理容量要结合任务类型、单任务执行时间、CPU 核数、下游容量和实际观测来定,没有通用公式。
这里还有一个常见的误判:线程池满了不等于 CPU 饱和了。线程可能在等数据库、等远程 HTTP 响应、等一个锁。判断依据应该是线程状态分布和 CPU 使用率一起看,单看任何一个都会得出错误结论。
3.4 连接池限制的是连接资源,不是整个服务的处理能力
连接池的作用是复用连接,并控制连接资源的创建与占用。它和 worker 数是两个独立的限制。
HTTP 客户端通常会限制同时打开的连接数。达到上限后,新请求要等连接释放,或者等超过池的超时时间后失败:
- aiohttp 的连接器配置(
limit、limit_per_host) - HTTPX 的资源限制(
limits) - HTTPX 的超时机制(
timeout)
连接池过小会造成不必要的等待,但过大同样有问题。如果 API 有 20 个实例,每个实例配 50 个数据库连接,那么数据库上的连接上限之和是 1000。 数据库能不能高效处理 1000 个并发连接是另一个问题,而它不会因为应用层把池开大就自动解决。
这里的关键是:调连接池不能只看应用自身,要把下游的连接预算一起算进来。
后面第五章会用实验说明连接池最隐蔽的一种失败方式:池子太小的时候,服务端的队列指标是完全干净的,延迟却高得离谱。 只看服务端监控会得出「服务端很闲」的结论,而真相是请求根本没到服务端。
四、队列积压:吞吐量不变,延迟为什么还会增长?
队列是理解高并发系统最重要的一环,也是最多被忽略的一环。
到达速率低于处理能力时,系统很快就能完成工作,队列基本是空的。到达速率接近处理能力时,短暂的流量波动或下游抖动就能让请求排上队。到达速率长期高于处理能力时,如果没有限制排队数量,工作就会持续堆积,而且不会自己恢复。
第一章那张表里,并发从 50 加到 400 吞吐量没变、延迟翻了 6.8 倍,原因全在队列。
4.1 Little 定律:把在途请求、吞吐量和延迟串起来
排队论里有一个简洁而有力的关系:
1 | L = λ · W |
L:系统中的平均任务数量(在途请求数)λ:长期平均完成速率;稳定状态下它等于到达速率W:任务在系统中的平均停留时间
这就是 Little 定律,来自 John D. C. Little 在 1961 年的论文。它的适用条件很宽:只要系统长期稳定、不丢任务、不凭空产生任务,关系就成立,不要求到达过程是泊松分布,也不要求服务时间服从某种分布。
用第一章的实测数据验证一下。客户端并发度控制在 C,那么稳定状态下在途请求数 L 就等于 C(每个客户端任务同时只有一次请求在途)。于是可以用 W = L / λ 反推平均停留时间,再跟实测的 P50 比:
| 客户端并发度 | 实测吞吐量 | L ÷ λ(Little 定律算出的停留时间) | 实测 P50 延迟 |
|---|---|---|---|
| 10 | 188.5 req/s | 53.1 ms | 52.5 ms |
| 25 | 470.2 req/s | 53.2 ms | 52.3 ms |
| 50 | 622.3 req/s | 80.3 ms | 91.1 ms |
| 100 | 620.3 req/s | 161.2 ms | 153.9 ms |
| 200 | 615.2 req/s | 325.1 ms | 311.6 ms |
| 400 | 613.0 req/s | 652.5 ms | 623.6 ms |
六档全部吻合,偏差在 10% 以内,而且方向一致:算出来的比实测的略大,多出来的部分是客户端的连接建立、HTTP 解析这些没有计入服务端的开销。
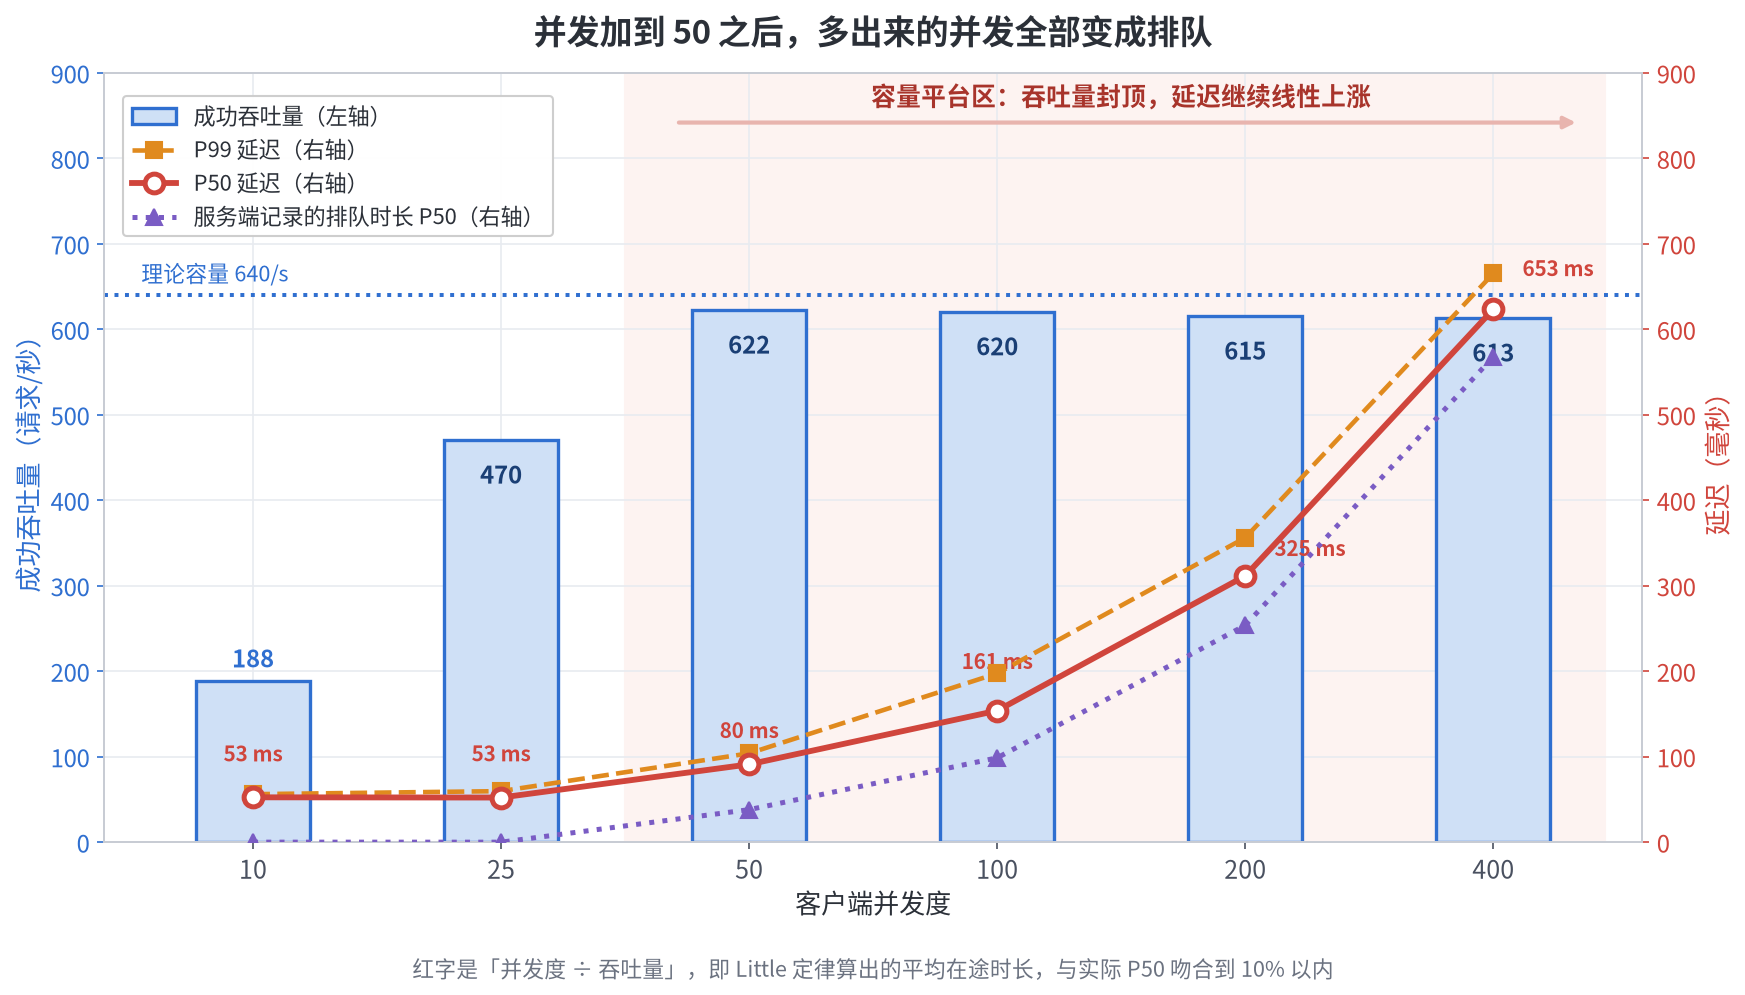
这张图把两件事放在一起看。柱子是吞吐量,从并发 50 开始就不再长高了。折线是延迟,从同一点开始近似线性地往上冲。而紫色虚线是服务端自己记录的排队时长,它和红色 P50 线几乎是平行的,中间隔着一段固定距离(那一段就是 50 毫秒的服务时间本身)。
队列深度和吞吐量都不变,延迟照样能一直涨。 因为延迟涨的不是执行时间,是等待时间。
Little 定律能干什么,不能干什么
它能告诉你的:给定吞吐量和在途请求数,平均停留时间必然是多少。这三个量里知道任意两个,第三个就被确定了。上面那张表就是反过来用它做校验的。
它不能告诉你的:
- 请求具体堵在哪个队列。 它只说「平均停留 W」,不说这 W 里有多少在客户端等连接、多少在服务端排队。要回答这个必须分阶段埋点。
- P99 延迟是多少。 它管的是平均值,跟尾延迟没有直接关系。一个系统可以平均延迟很低而 P99 很差。
- 系统是不是健康的。 高吞吐 + 低延迟、低吞吐 + 高延迟,都可能满足 L = λW。
所以它的定位是一个关系校验工具,不是诊断工具。当你从监控里读出三个数、发现它们不满足 L = λW 时,那是很有价值的信号,说明统计口径有问题,比如漏计了某一类请求,或者统计窗口不一致。
4.2 无界排队为什么危险
直觉上会认为,队列大一点总没坏处:排着队至少请求还在,万一后面处理快了呢。实际情况相反。下面这条链条一旦启动,会自己加速:
- 下游处理时间变长
- API 的处理速度下降
- 新请求继续进入系统,队列开始增长
- 排队中的任务持续占用内存和其他资源
- 请求超过客户端截止时间,客户端放弃并发起重试
- 重试带来额外负载,下游处理时间进一步变长
回到第 3 步。关键在于队列里的任务不是免费的。每个等待中的请求都占着内存、占着客户端的连接、最终还会被认领一次。如果它等到被认领时已经过期,那次认领就是纯浪费。
Google SRE 的《Addressing Cascading Failures》详细讨论过这类资源耗尽与级联故障的机制。
所以一个系统不仅要回答「每秒能接多少请求」,还要回答「最多允许多少请求同时在途」「最多允许等多久」。这两个问题的答案,就是第五章要说的东西。
五、背压:让系统只接收自己能够处理的工作
背压这个词常被简化成「把并发限制设小一点」,但它真正要解决的问题是:让上游能感知下游的容量,别让工作无限制地涌进来。
常见手段有这些:
- 有界队列:限制等待中的任务数量
- 并发准入:限制同时执行的任务数
- 快速拒绝:容量不足时立刻返回明确错误
- 超时与截止时间:避免过期请求继续占用资源
- 重试退避:避免失败请求立刻再制造压力
- 降级与负载削减:过载时砍掉非关键工作
几个容易踩的坑:
信号量不等于背压。 信号量能限制同时执行的任务数,但如果大量请求都堵在「获取信号量」这一步,等待者本身就是一个巨大的无界队列,只是换了个名字。
有界队列也不是万能的。 队列太小会增加拒绝率,太大则会让请求在队列里等到超过业务截止时间。边界要根据请求的价值、执行成本、截止时间和下游容量来定。
拒绝要快。 一个马上就要过期的请求,晚一点拒绝不如早一点拒绝,早拒绝能立刻释放客户端连接和服务端资源。
有界队列与无界队列的实测对照
这一条我做了完整对照。服务端容量 640 req/s(32 worker × 50 毫秒),用开环方式恒定每秒投放 1000 个请求,持续 12 秒,也就是稳定过载 1.56 倍。唯一变量是队列容量:无界、64、256。
| 队列策略 | 成功完成 | 服务端超时(504) | 拒绝(503) | 峰值队列深度 | 有效吞吐量 |
|---|---|---|---|---|---|
| 无界 | 3379 | 8505 | 0 | 2016 | 281.6 req/s |
| 有界 64 | 7651 | 0 | 4350 | 64 | 637.6 req/s |
| 有界 256 | 7833 | 0 | 4168 | 256 | 652.8 req/s |
无界队列少完成了 56% 的有效工作,而且一个请求都没有快速失败,全部拖到服务端超时才结束。
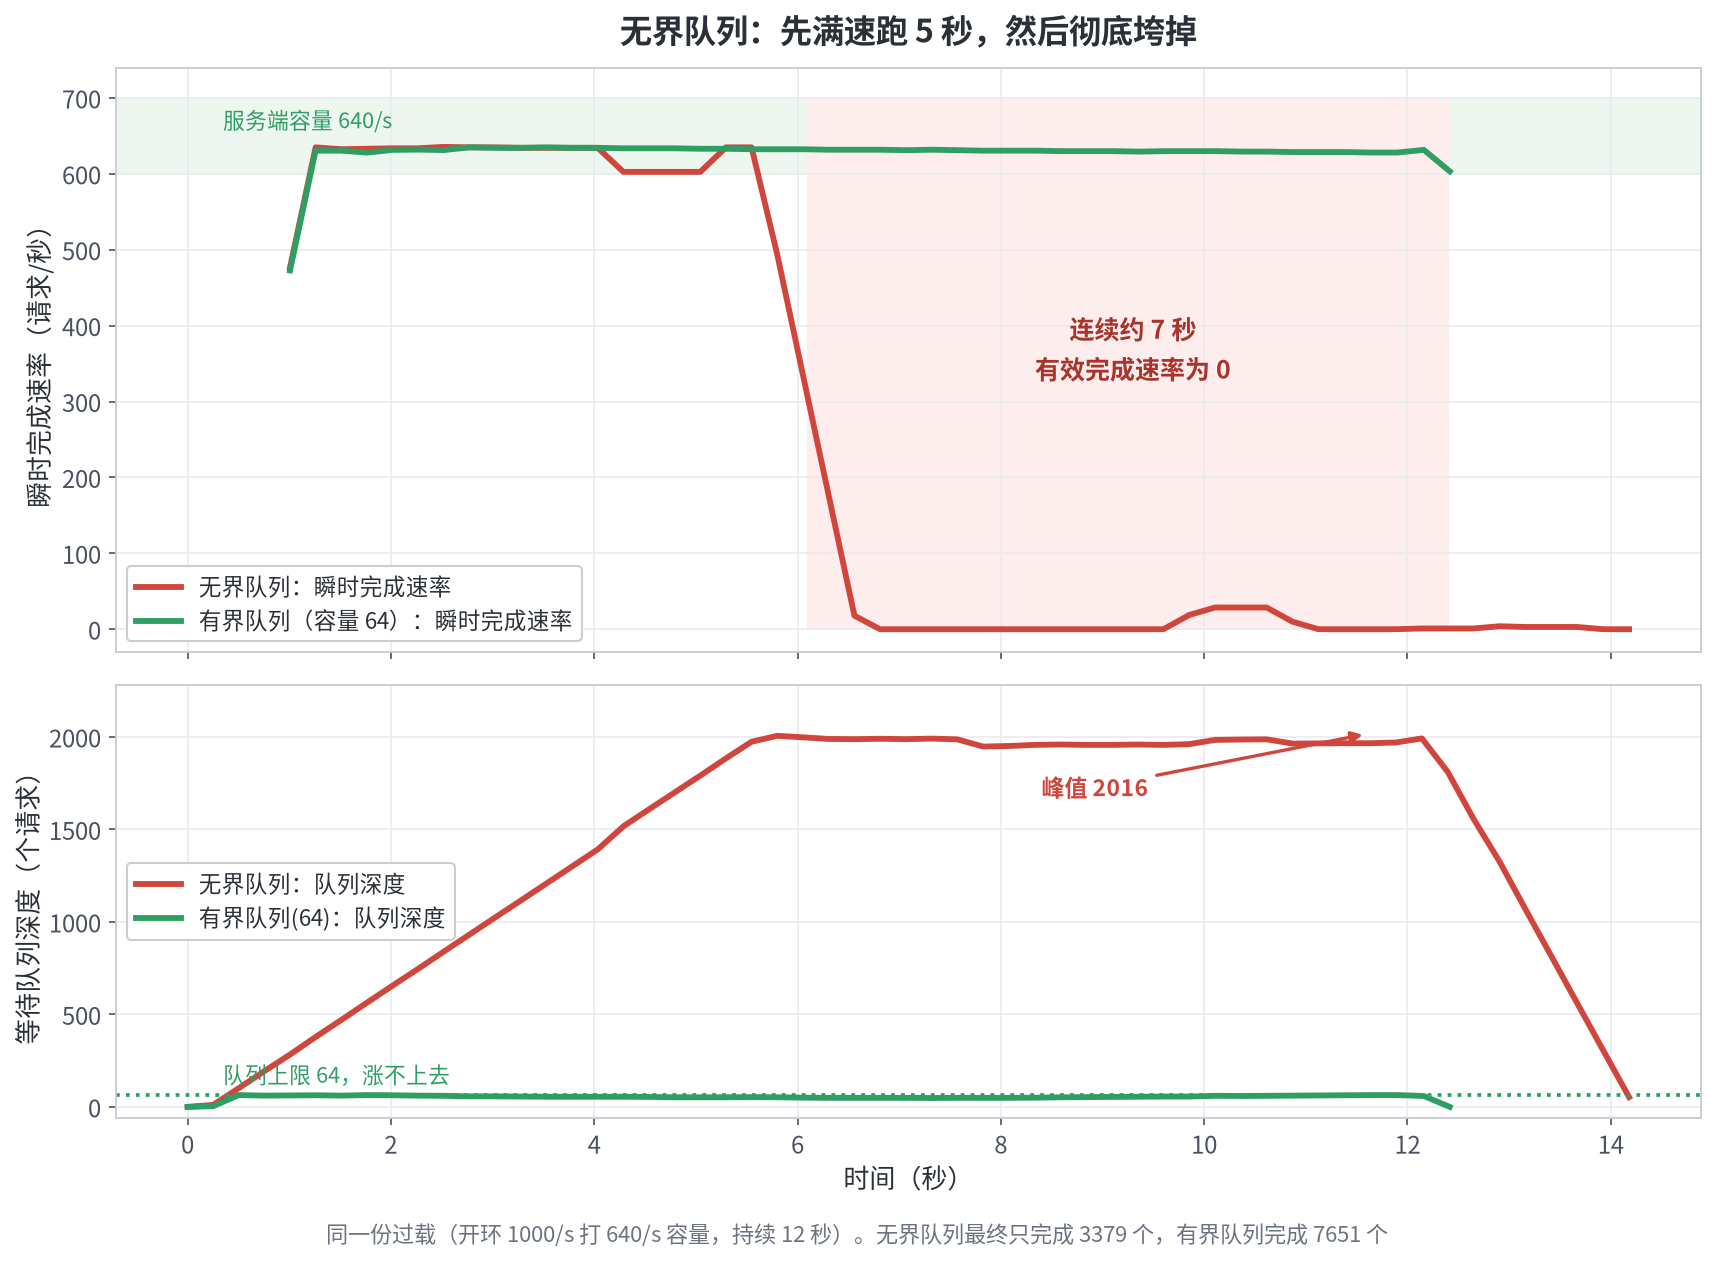
上图是三种策略的瞬时完成速率,下图是队列深度。看红色那条无界队列的线:
- 前 5 秒:完成速率稳定在 634 req/s,贴着容量跑,队列从 0 涨到 1791
- 第 5 秒到第 6 秒:完成速率开始下滑,第一批超时出现
- 第 6 秒之后:完成速率掉到 0,并一直保持到第 13 秒
从第 6 秒到第 13 秒,队列里平均躺着 2000 个请求,32 个 worker 全部处于忙碌状态,而这 7 秒内成功完成的请求数是零。
原因不复杂:队列按先进先出出队,队列深度以每秒约 360 个的速度增长,所以一个请求从入队到被认领的等待时间也在持续增长,很快就超过了服务端自己设的 2 秒截止时间。等到 worker 把它取出来时,请求早就过期了,直接跳过。worker 不闲,但它在处理一堆已经死掉的任务。
这就是第三章那个结论的另一种形态:「都在忙」不等于「在做有用的事」。
绿色那条有界队列的表现完全不同:
- 完成速率 12 秒全程稳定在 630 req/s 附近
- 队列深度稳定在 49 到 63 之间,从来不接近失控
- 多出来的 4350 个请求立刻拿到 503
同样的硬件、同样的过载倍数、同样的 12 秒。有界队列做了 2.26 倍的有效工作,延迟 P50 是 144 毫秒,而无界队列的 P50 是 2001 毫秒。
队列容量的选择是一个取舍
对比「有界 64」和「有界 256」这两行:256 的吞吐量略高(652.8 对 637.6),但它的延迟也更高。这不是矛盾,队列容量决定了请求最多愿意等多久。
以 640 req/s 的处理速率算,64 个位置意味着最坏等待约 100 毫秒,256 个位置意味着最坏等待约 400 毫秒。如果业务的截止时间是 200 毫秒,那么 256 这个配置会让一批请求在队列里等到超时,白白占用 worker 去认领一堆注定失败的任务。
队列容量的正确算法是从截止时间倒推,而不是从「能存多少」倒推:
1 | 队列容量 ≈ (截止时间 - 预期执行时间) × 处理速率 |
这个值不需要精确,量级对了就行。要避免的是数量级上的错配,比如一个 200 毫秒截止时间的接口配了能等 5 秒的队列。
六、构建一个可复现实验
要把上面这些结论落到自己的系统上,第一步是搭一个能重复跑的对照环境。真实数据库、网络抖动、其他进程的干扰都会让第一轮分析变成猜谜,所以先做一个模拟下游处理时间的服务:固定数量的 worker、有限队列、可配置的处理时间。
它不打算复现任何生产框架的内部实现,只用来验证排队、准入、过载保护这些基本机制。
6.1 环境
需要 Python 3.11 或更高版本,以及 aiohttp:
1 | python -m venv .venv |
两个文件:server.py 是服务端,load.py 是闭环压测端,load_open.py 是开环压测端。
服务端接受四个环境变量:
| 变量 | 含义 | 默认值 |
|---|---|---|
WORKERS |
并发执行槽位数 | 32 |
QUEUE_SIZE |
等待队列容量,0 表示无界 | 64 |
SERVICE_TIME |
每个任务模拟的下游处理时间(秒) | 0.05 |
REQUEST_TIMEOUT |
服务端等待自己任务完成的截止时间(秒) | 2.0 |
BLOCKING |
设为 1 时用 time.sleep 替代 await asyncio.sleep |
0 |
6.2 服务端:有限队列与固定 worker
1 | # @Moxin1044 2026-10-15 |
有两处设计值得说明。
worker 从队列取出任务后,先记录排队时长,再执行。 这两个量分开计量,才能回答「延迟是排队排出来的还是执行执行出来的」而不用猜。第五章那张崩溃曲线就是靠这个定位到的原因。
BLOCKING 开关。 它把 await asyncio.sleep(...) 换成 time.sleep(...),服务时间、worker 数、任务逻辑全部不变。第三章那组 30.8 倍的对照就是用它做的,同一份代码,只有一个开关不同。
启动服务:
1 | python server.py |
另开一个终端看当前状态:
1 | curl http://127.0.0.1:8080/metrics |
/metrics 返回的不只是累计计数,还有队列深度、活跃 worker 数,以及服务端自己观测到的排队时长分位数。
6.3 客户端:闭环压测端
1 | # @Moxin1044 2026-10-15 |
这个客户端是闭环的:固定数量的协程任务,每个任务等上一次请求结束才发下一次。它适合看「给定并发度下系统表现如何」,但有一个重要缺陷,第八章会用实验说明。
6.4 客户端:开环压测端
1 | # @Moxin1044 2026-10-15 |
6.5 怎么跑
一次基线测试:
1 | python load.py --requests 2000 --concurrency 50 --pool 50 |
逐步加客户端并发度:
1 | python load.py --requests 5000 --concurrency 100 --pool 100 |
固定并发度 200,单独改连接池上限:
1 | python load.py --requests 5000 --concurrency 200 --pool 20 |
开环方式:
1 | python load_open.py --rate 1000 --duration 10 |
这些命令只定义实验配置,不预设结果。跑之前建议先做一件事:标定压测端自己的天花板。把服务时间压到接近 0,看客户端能跑到多少 req/s。如果这个数跟被测系统的容量接近,那测出来的就是压测端的能力,不是系统的能力。
本文的实验里,压测端在并发 200 时能到约 6750 req/s。所有结论都落在这条线以下,最接近的是第三章那组 1483 req/s,留了 4 倍余量。
6.6 每次测试至少要记录什么
| 指标 | 来源 | 分析目的 |
|---|---|---|
| 成功 RPS | 压测端 | 实际完成的有效工作量 |
| P50 / P95 / P99 | 压测端 | 区分典型请求与尾部请求 |
| HTTP 503 数量 | 压测端 | 服务端主动拒绝的情况 |
| HTTP 504 数量 | 压测端 | 服务端等待超时的情况 |
| 队列深度 | 服务端 /metrics | 任务是否在积压 |
| 活跃 worker 数 | 服务端 /metrics | 执行槽位是否持续被占用 |
| 服务端排队时长分位数 | 服务端 /metrics | 延迟里有多少是排队 |
| CPU、内存 | 操作系统 | 压测端与服务端谁先到资源边界 |
两个容易漏掉的:
失败要分类。 503(主动拒绝)和 504(等到超时)是完全不同的信号,混在一起算「错误率」会把第五章那个结论完全掩盖掉,有界队列的失败是可控的,无界队列的失败是失控的,但它们的「错误率」看起来差不多。
压测端和服务端要分别看资源。 同机压测时二者互相争抢,尤其是 CPU。本文的做法是用 taskset 把服务端钉在 0-1 核、压测端钉在 2-3 核,尽量隔离。即便如此,同机压测的干扰也无法完全消除,这一点在附录里会说明。
七、性能曲线应该怎么读?
真正有价值的压测结果是负载、吞吐量、延迟、错误率四者之间的关系,一个最高 QPS 数字说明不了什么。至少要画三张图:
- 负载—吞吐量曲线:横轴是并发度或目标速率,纵轴是成功 RPS
- 负载—延迟曲线:同一横轴下画 P50、P95、P99
- 负载—错误率曲线:区分服务端拒绝、服务端超时、客户端超时和其他异常
第一章那张表和第四章那张图合起来就是前两张。形态上可以分成三段:
低负载段:资源有余量,吞吐量随负载线性上升,延迟基本不变(就是服务时间加一点固定开销)。这一段加负载是划算的。
容量拐点附近:吞吐量增长开始变慢,延迟对负载变得敏感。实测里这个拐点出现在并发 50 附近,对应容量 640 req/s。
过载段:吞吐量封顶甚至轻微下降,延迟线性上升,错误开始出现。这一段加负载纯粹是自伤。
但真实曲线比这复杂
上面是理想形态。实际系统的曲线会被这些东西影响:
- 缓存命中率随负载变化。 负载高时缓存被挤占,命中率下降,服务时间变长,容量跟着降。
- JIT 预热和垃圾回收。 冷启动前几十秒的数据不能代表稳态;GC 停顿会在延迟曲线上制造尖峰。
- CPU 限频。 高负载下 CPU 频率可能下降,容量随负载降低,出现「越忙越慢」的负反馈。
- 请求分布变化。 压测用的均匀请求和生产的重尾分布完全不是一回事。
- 下游波动。 下游不是恒定的,它的容量也在变。
所以不同工作负载可能出现多个不同的饱和点,一个系统在一种请求混合下 600 req/s 就饱和,换一种可能 1200 req/s 还游刃有余。不能只看一条曲线就断定「CPU 是瓶颈」或「连接池是瓶颈」。
闭环压测会掩盖真实的过载
这一条值得单独说,因为它是压测方法本身的问题,不是被测系统的问题。
load.py 是闭环的:固定并发数 C,每个任务等上一次请求结束才发下一次。它实际施加的到达速率是 C / 平均延迟,跟设定的并发数 C 完全是两回事。延迟一涨,它自己就减速了。
看一组对照。服务端配置 8 个 worker、50 毫秒服务时间,容量 160 req/s。两种压测方式,负载都远远超过容量:
| 压测方式 | 服务端实际收到 | 成功 | 504 超时 | 结论看起来像 |
|---|---|---|---|---|
| 闭环,并发 400 | 800 个(10 秒内) | 313 | 487 | 系统在 80 req/s 就崩了 |
| 开环,恒定 1000/s | 9870 个 | 368 | 9502 | 系统在 1000 req/s 的冲击下崩了 |
两种方式都把系统打垮了,但闭环压测低报了 12 倍的负载。它本意是施加 400 并发的压力,实际只把 800 个请求送到了服务端,因为响应太慢,客户端自己在等。
如果只用闭环压测来定容量,你会得出「这个系统在 80 req/s 的到达速率下就会崩溃」,从而去做一些完全没必要的优化。真相是它在 987 req/s 的持续冲击下崩溃。
结论:想研究饱和点和突发流量,必须用恒定速率的开环压测。 闭环压测适合回答「给定并发度下的延迟是多少」,不适合回答「系统能扛多少流量」。
开环压测自己要小心一件事:它会在过载时无限堆积在途请求,把压测机先拖垮。所以 load_open.py 有一个 --max-inflight 参数限制在途上限,这本身就是一种背压,不设的话压测端的内存和文件描述符会先耗尽。
八、故障边界:优化单个资源,为什么可能让整体更差?
前面几章都在讲「瓶颈在哪」。这一章讲另一件更容易踩的事:你以为的优化,可能只是把压力挪到了别处。
8.1 连接池调小,时间从服务端转移到了客户端
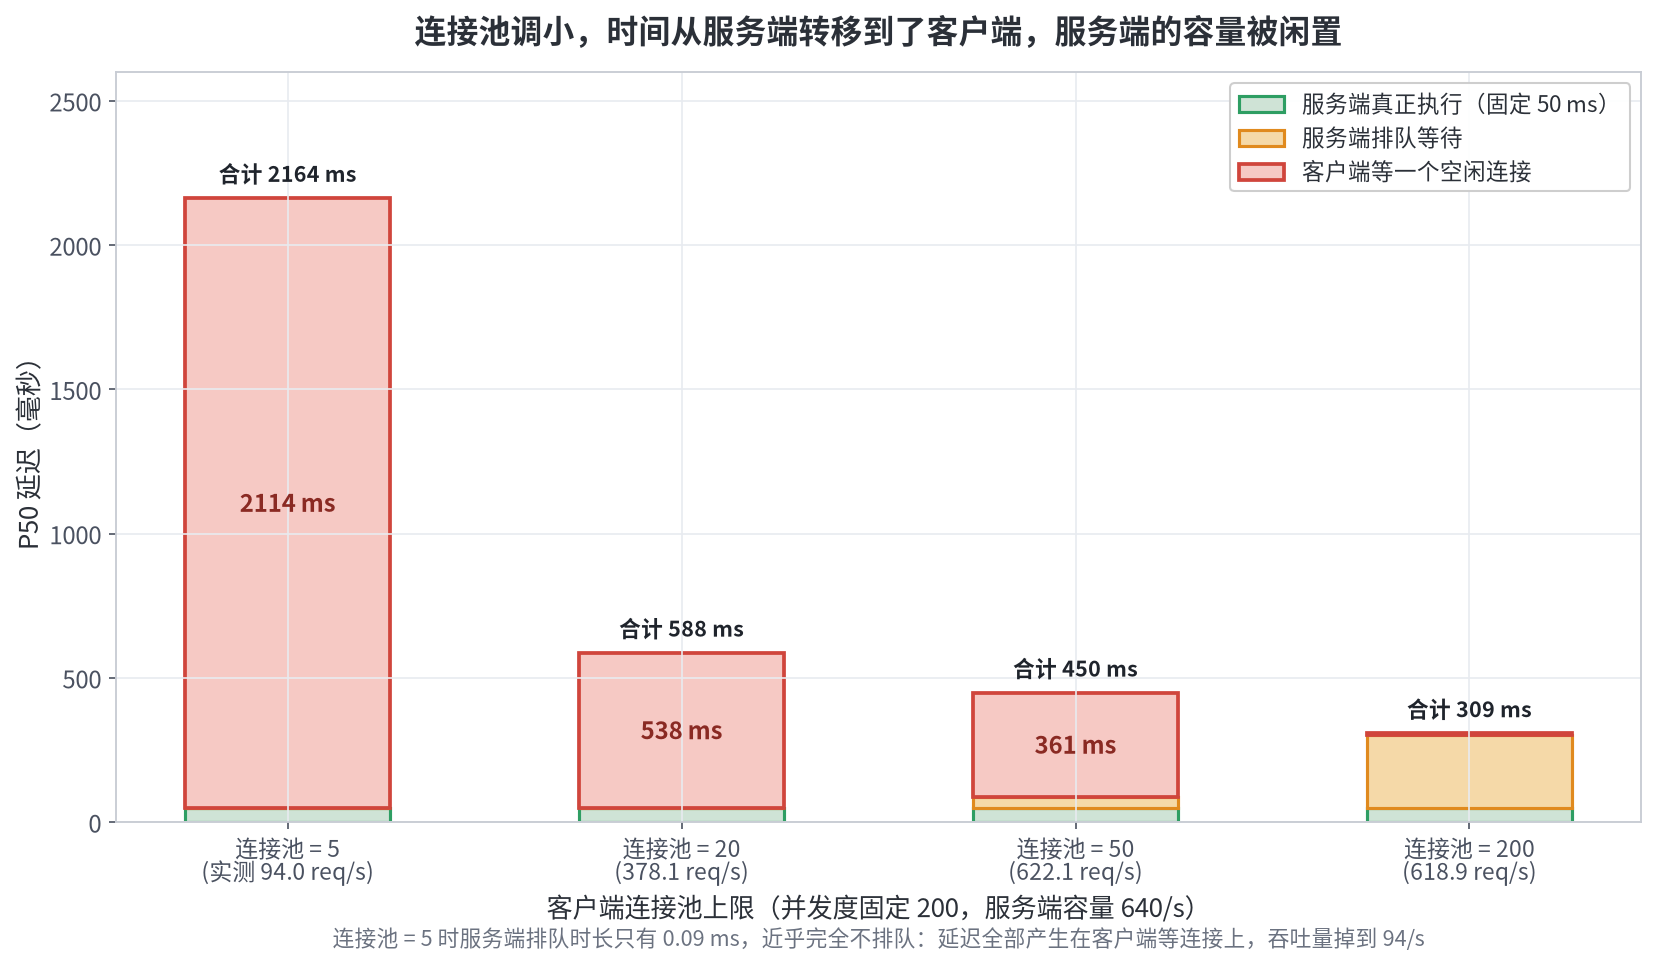
这是一组很能说明问题的实测。服务端容量 640 req/s(32 worker × 50 毫秒),客户端并发度固定 200,只改连接池上限:
| 连接池上限 | 成功吞吐量 | P50 总延迟 | 其中:服务端排队 | 其中:服务时间 | 其中:客户端等连接 |
|---|---|---|---|---|---|
| 5 | 94.0 req/s | 2164.4 ms | 0.09 ms | 50 ms | 2114 ms |
| 20 | 378.1 req/s | 588.1 ms | 0.06 ms | 50 ms | 538 ms |
| 50 | 622.1 req/s | 449.6 ms | 38.1 ms | 50 ms | 362 ms |
| 200 | 618.9 req/s | 308.8 ms | 253.7 ms | 50 ms | 5 ms |
看第一行和最后一行。
连接池 = 5 时,服务端记录的排队时长是 0.09 毫秒。服务端一点都不忙,队列是空的,worker 大部分时间闲着。但客户端测到的 P50 是 2164 毫秒,吞吐量只有 94 req/s,不到容量的 15%。
时间全部花在了「客户端等一个空闲连接」上。因为只有 5 个连接,200 个并发任务里同时最多只有 5 个能到达服务端。
连接池 = 200 时反过来:服务端排队时长 253.7 毫秒,客户端等连接只有 5 毫秒。瓶颈回到了服务端。
这两行合起来说明一件事:如果只看服务端的队列指标,连接池 = 5 那个配置看起来是最健康的(队列空、worker 闲)。而它实际上是表现最差的配置。
排查这类问题的方法很直接:把总延迟拆成「客户端等待 + 服务端排队 + 服务执行」三段,看哪一段占大头。服务端排队时长要自己埋点才算得出来,这就是 6.2 节那个设计的原因。
顺带一提,连接池 = 50 的吞吐量(622.1)已经和连接池 = 200(618.9)持平,说明 50 个连接就够喂满这个服务端了。池子再开大没有收益,只是让请求更多地堆在服务端队列里,延迟反而更低一点(因为服务端排队比客户端等连接更「高效」)。这也是为什么「加大连接池」经常看起来有效,它确实降低了延迟,但降的是等待的位置,不是等待的总量。
8.2 连接池扩容会把压力转移给数据库
上一节的另一端:如果下游数据库的处理能力没有提升,扩大连接池只是允许更多请求同时到达数据库。
数据库内部的锁竞争、内部排队、CPU 饱和都会因此加剧。表现是数据库的整体吞吐量下降,而每个应用实例都觉得自己没做错什么。
连接池应该和数据库容量、请求执行时间、事务持续时间以及全局连接预算一起设计。汇总是关键:10 个实例各配 100 个连接,数据库面对的是 1000 个并发连接,这个数不会因为每个实例「只配了 100」就变小。
8.3 增加线程可能加剧资源竞争
线程池扩容能增加阻塞型任务的并发执行能力,但同时也增加内存开销、调度成本和下游压力。
如果所有线程都在等一个已经过载的下游,增加线程不会解决问题,它只会让更多请求同时压在那个下游上。第三章那个 time.sleep 的实验是这条的极端形式:32 个 worker 全部在等同一个被占住的资源,增加 worker 数完全没有收益。
8.4 超时不意味着工作一定停止
客户端超时只代表客户端不再愿意等。它不代表:
- 服务端停止处理这个请求
- 下游数据库查询被取消
- 已经占用的内存和连接被释放
这几件事需要分别设计。要区分清楚的至少有五层:
- 客户端超时
- 服务端处理截止时间
- 下游调用超时
- 请求取消的传播(客户端断开后,服务端知不知道)
- 取消之后资源是否真的释放
最容易出问题的是最后两层。第五章那个无界队列的实验就是典型:客户端早已放弃,服务端仍在为一批过期请求消耗 worker。所以 6.2 节的实现里,worker 取出任务后先检查 future.cancelled(),已经过期的直接跳过,不再执行。
8.5 重试可能放大故障
下游过载时,如果所有调用方都立刻重试,系统会收到额外的请求流。重试要有明确的截止时间、退避策略、随机抖动和重试预算。
这里有一个反直觉但成立的原则:对于已经确定无法及时完成的请求,尽早失败比继续消耗资源更有利于整体恢复。 第五章的实测数据支持这一点,有界队列立刻拒绝掉 4350 个请求,反而把有效吞吐量保住了;无界队列让 8505 个请求缓缓超时,把有效吞吐量拉低了一半以上。
8.6 单机背压不等于全链路背压
服务端的有界队列保护的是当前这个进程。如果反向代理、消息队列、调用方或者中间的其他服务仍在无限制地积压工作,整个链路的等待总量只是换了个地方存放。
所以要沿着完整请求路径检查每一个队列的容量、超时、拒绝策略和资源释放行为。一条链路上任何一个无界队列都足以让整条链路的背压失效,因为上游会认为「我发出去了」,而实际上工作堆在了下游某个看不见的缓冲里。
九、如何把实验扩展到真实生产技术栈
模拟实验验证的是基本机制。把结论用到真实服务上,还需要在这四个方向上补实验。
连接池实验
用真实的 HTTP 客户端或数据库驱动,分别记录这几项而不是只想看总耗时:
- 连接获取等待时间(从请求发起到拿到连接)
- 连接建立时间(含 TCP 握手、TLS)
- 下游处理时间
- 总请求延迟
把整个请求耗时直接当成「连接池等待时间」是最常见的错误。第八章那张表说明了为什么,同一个 2164 毫秒的延迟里,客户端等连接和服务端排队是两件完全不同的事,处理方向也相反。
线程池实验
构造两种可控负载,分别改线程数:
- 阻塞 I/O 型(大量等待下游)
- CPU 密集型(几乎不等待)
观察线程活跃状态、CPU 使用率、上下文切换次数、队列等待时长和延迟分布。这两种负载的最优线程数完全不同,CPU 密集型的合理值通常在核数附近,阻塞型的可以高很多。同一套参数套用到两种负载上必然有一边是错的。
事件循环实验
对照正常异步 I/O 和「事件循环里混进了同步阻塞调用」两种情况,记录事件循环调度延迟和请求尾延迟。
第三章那组实验用的是极端形式(整个处理过程都阻塞)。真实系统里更常见的是局部阻塞:一个同步的文件读写、一次没走线程池的 DNS 解析、一个用了同步库的加密操作。这类问题的特征是尾延迟突然变差而平均延迟没变,因为只有在恰好的时机才会撞上。
做这个实验前要先确认测试环境本身不是瓶颈:客户端和服务端同机、客户端先跑满 CPU,都会让结论失去意义。
背压实验
在相同负载下比较四种策略,观察过载期间的在途请求数、队列深度、内存、成功吞吐量和恢复时间:
- 无界等待
- 有界队列
- 并发准入(信号量)
- 快速拒绝
恢复时间这一项经常被忽略,但它很重要。第五章那张崩溃曲线里,无界队列在负载停止后还要花几秒清理积压的 2000 个过期任务,这段时间系统对外仍然不可用。有界队列没有任何积压要清理,负载一停就能立刻恢复。
所有实验的共同要求
- 先预热,再进入固定观测窗口
- 保留原始数据、配置、代码版本和环境信息
- 每种配置重复多次,记录均值、分位数和波动范围
- 一次只改一个主要变量
最后一条听起来是废话,但实践中经常被违反。把并发度和连接池同时调大,然后看到吞吐量上升,你无法知道是哪一个起了作用,也无法知道如果只调其中一个会怎样。
十、结论:真正的瓶颈是系统无法及时完成的那部分工作
回到开头那个问题:高并发 API 服务的瓶颈究竟在哪里。
这次实验给出的答案落在一个结构上:
1 | 容量 = 能并行执行的工作数 ÷ 每份工作的耗时 |
这个数在改代码之前就定死了。实测里五档 worker 数的吞吐量全部落在这个公式上下 4% 以内。超过容量的请求不会让系统做得更多,它们只会去某个队列里排队,而排队这件事在平均响应时间上是看不出来的。
各组件的关系可以用一句话概括:
| 组件 | 它决定什么 | 它不决定什么 |
|---|---|---|
| 事件循环 | 任务如何被调度 | 能同时执行多少 |
| worker / 线程池 | 能同时执行多少份工作 | 下游能承受多少 |
| 连接池 | 能同时占用多少下游连接 | 服务端的处理能力 |
| 队列 | 暂时处理不完的工作放在哪 | 系统能不能恢复 |
| 背压 | 超出能力时如何拒绝 | 系统能处理多少 |
没有哪个组件能脱离其他组件单独优化,第八章那张表就是一个例子:把连接池从 200 调到 5,服务端队列指标变得最干净,整体表现却最差。
具体的工程方法可以落成六步:
- 画出请求路径,标出每一处可能发生等待的位置
- 建立可证伪的假设,明确「哪项指标支持这个判断、哪项指标否定它」
- 控制变量做实验,一次只改一个主要参数
- 同时看吞吐量、尾延迟、队列深度和错误分类,不要只追最高 QPS
- 限制过载时的在途工作量,用有界队列、截止时间、快速拒绝和重试预算保护系统
- 保留可复现证据,把配置、原始数据、脚本和分析结果纳入版本管理
最后要回答的问题不是「连接池该设成多少」或者「线程池该有多少线程」,而是:
在给定的资源预算、请求成本和下游能力下,这个系统能持续完成多少有效工作?当需求超过这条线时,它能不能控制排队、及时拒绝过期工作,并在负载恢复后迅速回到稳定状态?
第七章那个闭环与开环的对照,最后一列「恢复时间」的缺失,都是这个问题的一部分。而它们都比「最高能跑多少 QPS」更接近真实的容量边界。
附录 A:实验环境
所有数据来自这台机器:
1 | 操作系统 Arch Linux |
进程绑核:用 taskset 把服务端钉在 0-1 号核、压测端钉在 2-3 号核,减少同机争抢。
压测端天花板标定:把服务端处理时间压到 0.1 毫秒后,压测端在并发 200 时达到约 6750 req/s。本文所有结论都在这条线以下,最接近的一组是 1483 req/s。
必须跟着结论一起讲的限制
同机压测的干扰无法完全消除。 服务端和压测端共享同一台 4 核机器,即使做了绑核,L2/L3 缓存、内存带宽、中断处理仍然是共享的。表里的绝对数字含有这部分噪声,但所有对照实验的两个对比组在同样的干扰下运行,所以结论的方向是可靠的,绝对数值只在这个环境下成立。
关键配置的重复性。 第二章那张并发度曲线的每一档都跑了两遍,两遍的成功吞吐量差异小于 0.5%(例如并发 400 档:612.1 与 613.9;并发 100 档:620.4 与 620.2)。延迟分位数的差异在 1% 以内。表中填的是两次的均值。
无界队列实验的一次性。 第五章那张崩溃曲线只跑了一次。它展示的是一个动态过程,重复跑时间点上会有偏移(比如速率掉到零的确切秒数可能是 6.1 秒也可能是 6.5 秒),但形态和量级是稳定的。
没有做 CPU 绑频和关闭其他服务。 实验期间机器上仍有其他常驻进程,没有做 CPU 隔离或实时优先级设置。这会让绝对吞吐量比空载机器略低。
附录 B:复现步骤
1 | # 1. 环境 |
复现时最值得自己动手改的三处:把 SERVICE_TIME 换成你真实下游的 P50 时延,看容量公式算出来的上限跟你的监控对不对得上;把 QUEUE_SIZE 设成你线上队列的值,跟 64 和 256 对比一下;给你的服务加上「服务端排队时长」这个埋点,本文好几处结论都依赖它,而绝大多数服务默认没有这个指标。
附录 C:完整实验数据
容量天花板(服务时间 50 毫秒,队列无界,闭环并发 200):
| worker | 理论 N/S | 实测吞吐量 | 偏差 | P50 | P99 |
|---|---|---|---|---|---|
| 2 | 40 | 38.7 | -3.2% | 2592.0 ms | 5028.8 ms |
| 4 | 80 | 77.8 | -2.8% | 2539.9 ms | 2550.4 ms |
| 8 | 160 | 154.9 | -3.2% | 1276.4 ms | 1286.3 ms |
| 16 | 320 | 309.0 | -3.4% | 621.9 ms | 666.6 ms |
| 32 | 640 | 617.2 | -3.6% | 309.3 ms | 354.5 ms |
worker = 2 那档的 P99 超过了客户端 5 秒超时,所以有 4 个请求记为 504。
连接池对照(worker 32,服务时间 50 毫秒,并发固定 200):
| 连接池 | 吞吐量 | P50 | P99 | 服务端排队 P50 |
|---|---|---|---|---|
| 5 | 94.0 | 2164.4 ms | 2234.7 ms | 0.09 ms |
| 20 | 378.1 | 588.1 ms | 683.8 ms | 0.06 ms |
| 50 | 622.1 | 449.6 ms | 508.8 ms | 38.1 ms |
| 200 | 618.9 | 308.8 ms | 354.3 ms | 253.7 ms |
事件循环对照(worker 32,服务时间 20 毫秒,并发 200):
| 实现 | 吞吐量 | P50 | P99 | 服务端排队 P50 |
|---|---|---|---|---|
await asyncio.sleep |
1483.2 | 129.2 ms | 147.1 ms | 103.6 ms |
time.sleep |
48.2 | 4141.7 ms | 4163.8 ms | 1197.4 ms |
参考资料
Python 官方文档:asyncio — Asynchronous I/O:事件循环与协程的正式语义,
asyncio.to_thread()的适用场景。aiohttp 官方文档:Client Connectors:
limit与limit_per_host的确切含义,以及连接获取的排队行为。HTTPX 官方文档:Resource Limits:连接池上限的配置方式。
HTTPX 官方文档:Timeouts:超时分层(连接、读写、池、总时长)的设计。
John D. C. Little, A Proof for the Queuing Formula: L = λW, Operations Research, 1961:Little 定律的原始证明。
Google SRE Book:Handling Overload:过载识别与负载削减策略。
Google SRE Book:Addressing Cascading Failures:资源耗尽、长等待、超时与级联故障的关系。
Linux Kernel Documentation: Scaling in the Linux Networking Stack:内核视角下高连接数时代的扩展问题。
本文所有数据均为本机实测,三个实验脚本的源码在第六章给出,可自行编译复现。