计算机是怎么记录声音的?详解 mp3 与 wav 格式文件和录音的原理
先摆三个事实,它们看起来有点矛盾。
第一个。我录了三秒声音,存成 WAV,文件 517 KB。同一段声音转成 MP3,只剩 48 KB,缩小到 9.2%。用耳朵听,我听不出区别。
第二个。这个 517 KB 的 WAV 文件里,真正描述”这段录音的参数”的部分只有 44 个字节。剩下的全是采样数据,一个字节都不省。
第三个。如果我把采样率从 44100 改成 8000,再改成单声道,文件立刻掉到 47 KB,跟 MP3 差不多大。但这时候的音质,你一听就知道是电话里的声音。
这三个事实指向同一件事:声音在电脑里怎么存,取决于三个环节。怎么把空气的振动变成电信号,怎么把电信号变成数字,怎么决定哪些数字可以丢掉。
这篇文章把这三个环节从头走一遍,走到字节级别。
一、声音的本质是空气在抖
声音不是一种”东西”,它是空气的一种状态。
你说话的时候,声带在振动。振动推动它旁边的空气,那层空气又被压缩,去推动下一层。这样一层推一层,一路推到你朋友的耳朵里。中间没有任何东西从你嘴里飞到对方耳朵里,传过去的只是”压缩和稀疏”这个状态。
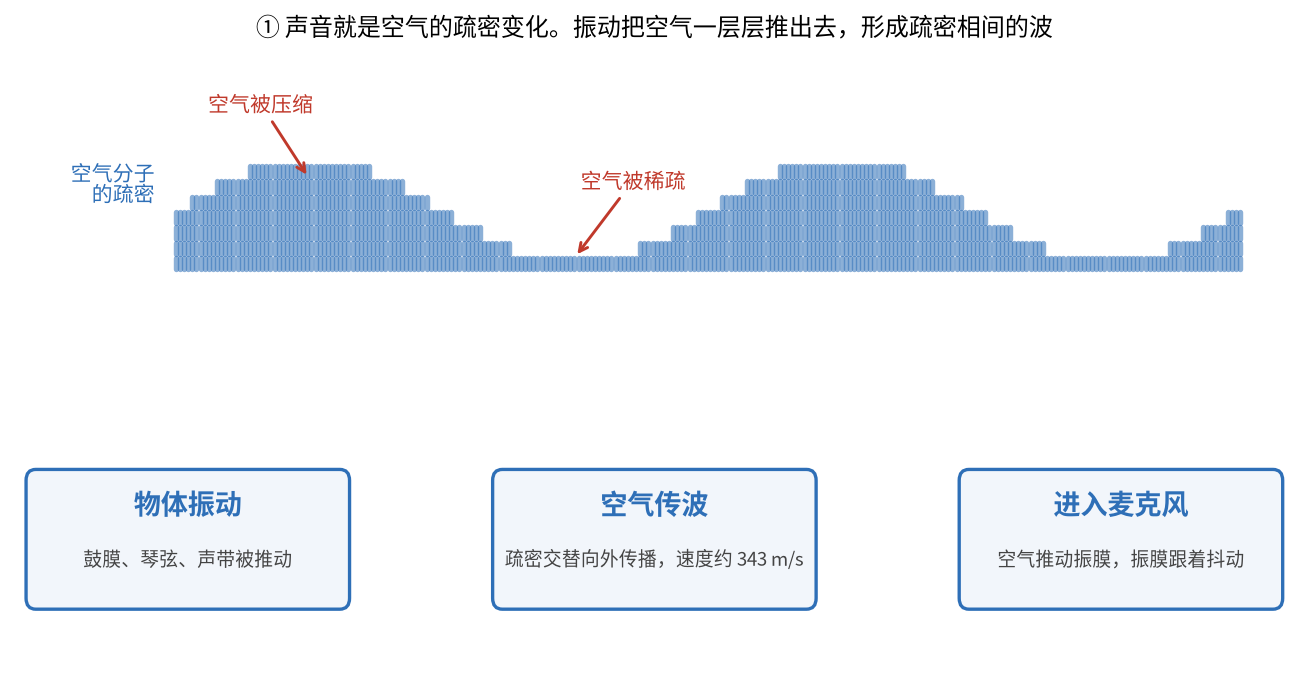
被压缩的区域,空气分子挤在一起,密度高,压强比周围大一点。被稀疏的区域反过来,密度低,压强小一点。这两个区域的压强差,就是麦克风能”感觉到”的东西。
传播速度大概是 343 米每秒,温度会影响这个数字。频率决定音调,振幅决定响度。
到这一步为止,全是物理,跟计算机一点关系没有。
二、麦克风怎么把抖动变成电压
麦克风的核心任务是:把空气压强的微小变化,变成电压的微小变化。
动圈式:用电磁感应
老式话筒、KTV 里那种,多半是动圈式的。
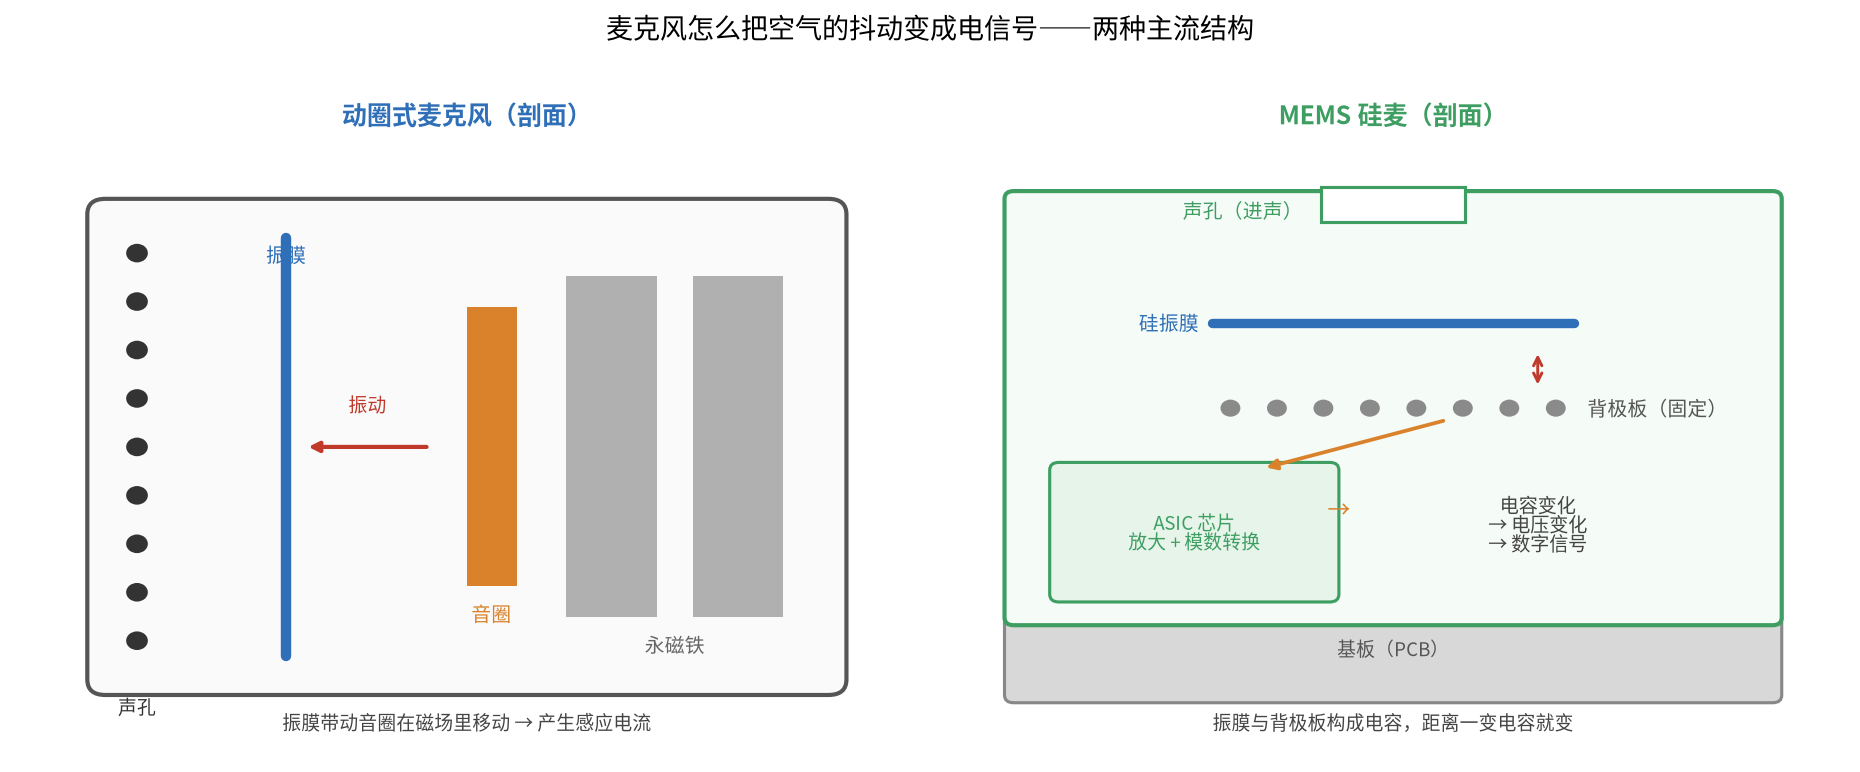
它内部有个极薄的振膜,连着一个小线圈,线圈套在永磁铁的磁场里。空气推振膜,振膜就带着线圈前后移动。线圈在磁场里移动,两端就会产生感应电压。振膜动得快,电压变化就快;动得幅度大,电压就大。
这套结构简单可靠,不需要供电,但体积下不来,因为磁铁和线圈都占地方。
MEMS 硅麦:用一块会动的硅
手机、笔记本、蓝牙耳机、智能音箱里几乎全是硅麦。它的大小跟一粒米差不多。
硅麦的思路完全不同。它用半导体工艺在硅片上刻出两样东西:一层可以振动的硅振膜,和一层固定不动的背极板。这两层之间隔着一个很小的空隙,构成一个电容器。
空气推振膜,两层之间的距离就变,电容量随之改变。旁边有个 ASIC 芯片负责把电容的变化转成电压变化,顺便做放大和模数转换。
为什么手机都用它?三个原因。体积小到可以塞进边框缝隙里。功耗低到不影响续航。还有就是能用标准的芯片生产线批量做,一致性非常好,一批几万颗性能差异都很小。
从电压到数字,还得有人做转换
不管哪种麦克风,输出的都是模拟电压,连续的、会随时间任意变化的电压。
计算机要的是 0 和 1。这个转换由 ADC 完成,就是常说的模数转换器。它是下一个环节的主角。
三、采样与量化:模拟变数字的两步
一个人对着麦克风唱了 3 秒,输出电压是一条连续曲线。你怎么把它变成一列整数?
分两步做。
第一步:采样,按固定间隔量一下
不连续记录,改成每隔固定的时间量一次”此刻电压是多少”。
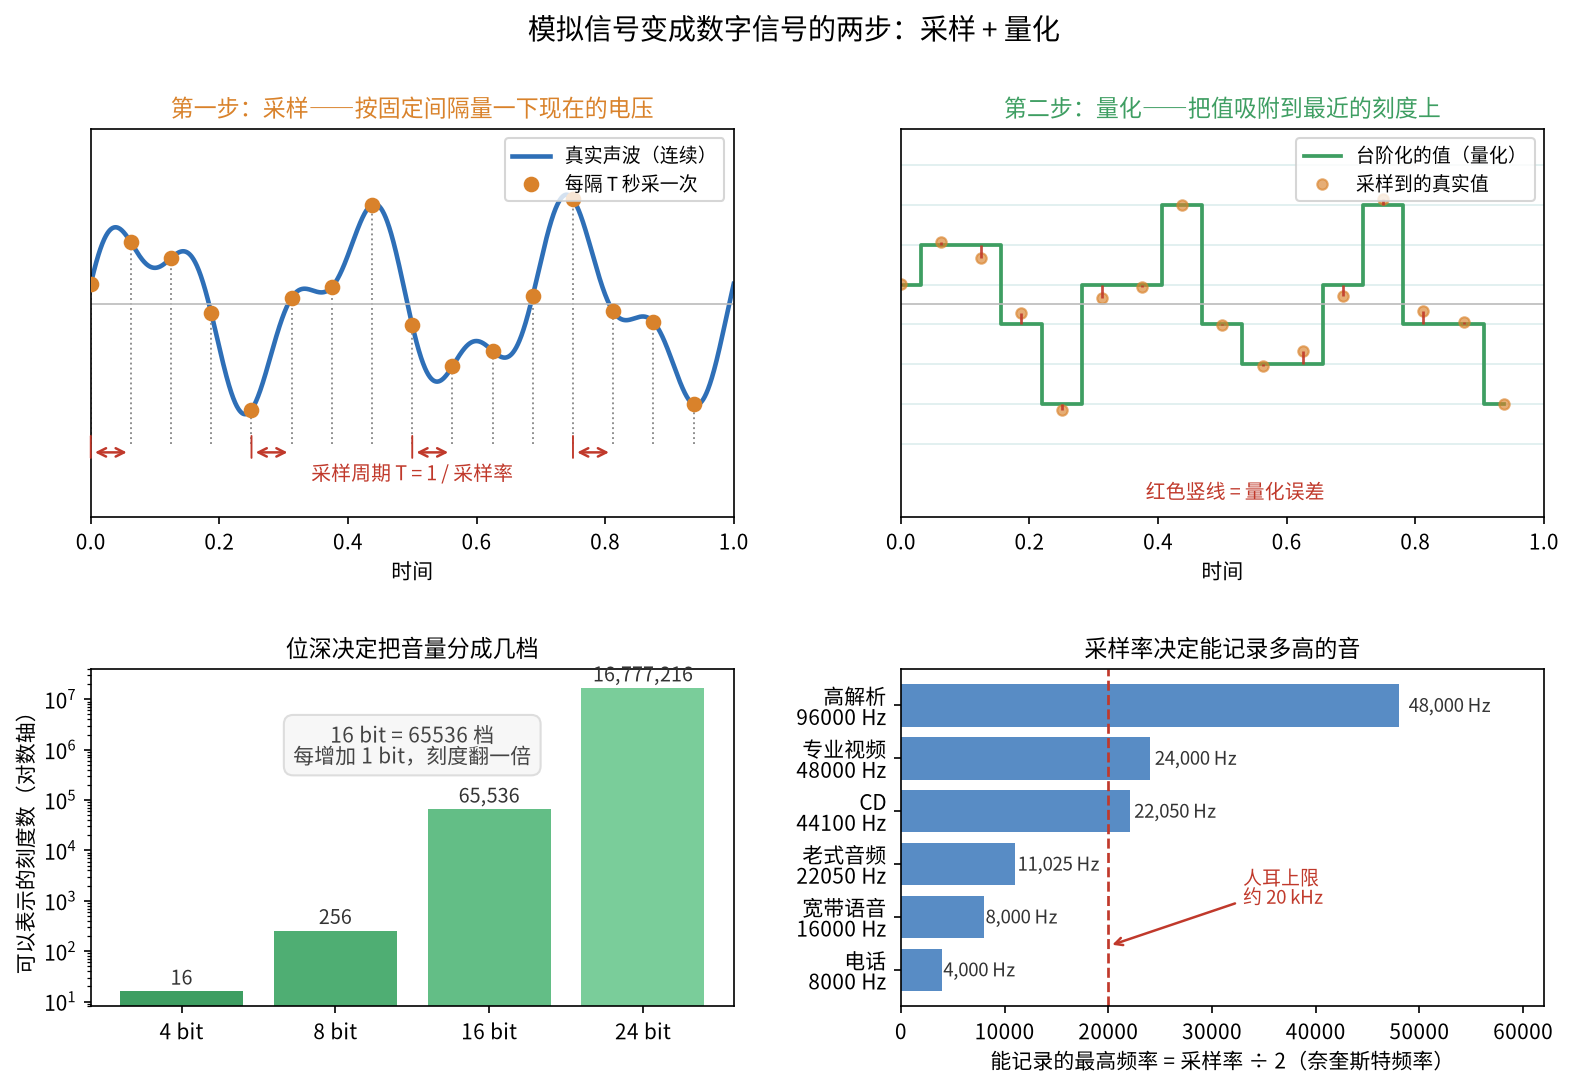
这个固定间隔的倒数,就是采样率。44100 Hz 的意思是每秒量 44100 次,间隔约 22.7 微秒。
采样率决定能记录多高的音。这里有个硬性限制,叫采样定理:采样率必须大于信号最高频率的两倍,否则高频信号会被”折叠”成错误的低频信号,产生一个根本不存在的音调。
因为人耳能听到的上限大约 20 kHz,所以 CD 定的采样率是 44100 Hz,刚好是 20 kHz 的两倍多一点,留了点余量给滤波器。这就是这个数字的来源,不是随便定的。
第二步:量化,把值吸附到刻度上
量到的电压是任意实数,但存储必须用有限位数的整数。
做法是把整个电压范围切成若干档,量到的值吸附到最近的档位上。
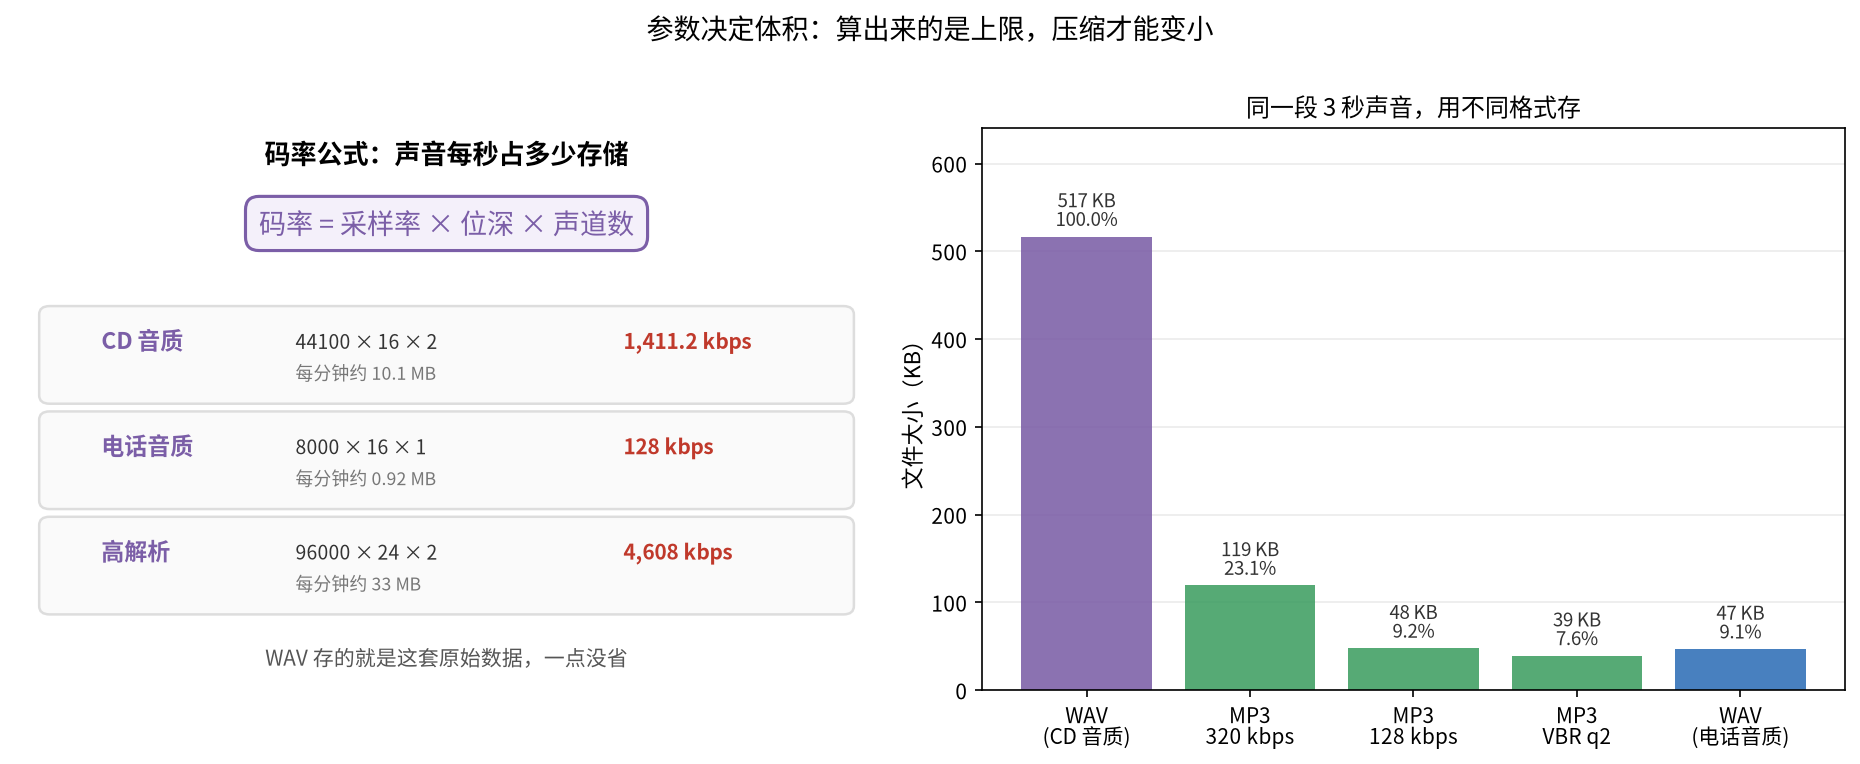
档位的个数由位深决定。位深 n 意味着有 2 的 n 次方个档位。16 bit 是 65536 档,24 bit 是 1677 万档。
吸附必然带来误差。真实值是 0.50001,被记成 0.5,这个差就是量化噪声。位深每加 1,档位翻倍,误差减半。粗略地说,16 bit 的信噪比约 96 分贝,24 bit 约 144 分贝。
码率:每秒要存多少
把参数乘起来,就是一个很简单的公式:
1 | 码率 = 采样率 × 位深 × 声道数 |
CD 音质是 44100 × 16 × 2,算出来每秒 1,411,200 bit,也就是 1411.2 kbps。一分钟大约 10.1 MB。
这个公式给出的数字,就是 WAV 存这些数据时的实际大小。它不是估出来的上限,是精确值,因为 WAV 一点不压缩。
四、从麦克风到文件:硬件和软件的接力
麦克风采集到的数据,要经过好几手才变成你硬盘上的文件。
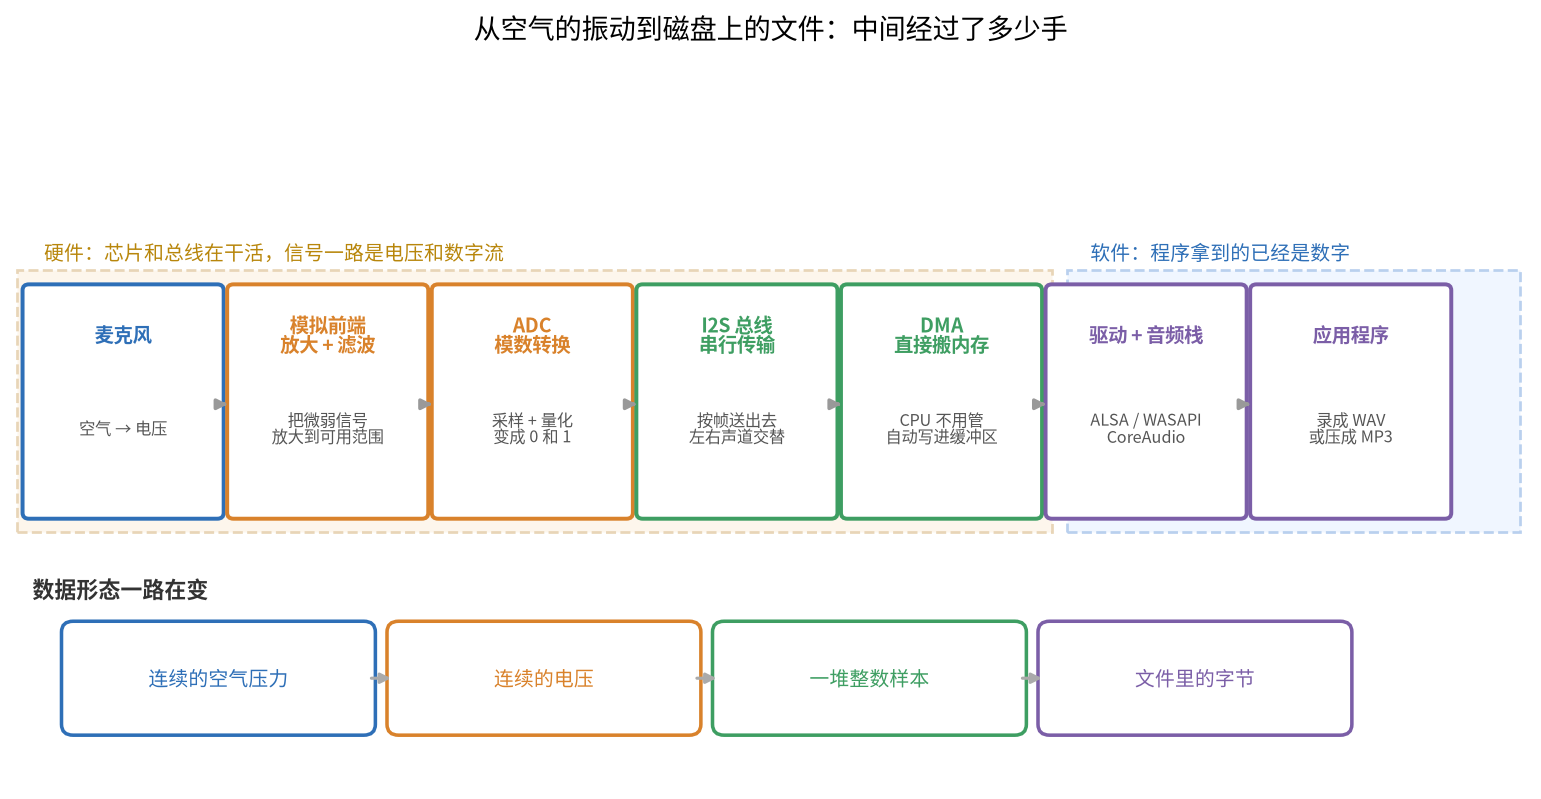
麦克风芯片把模拟电压送进 ADC 之后,出来的是数字流。这个流通过 I2S 总线串行送出去。I2S 是一根专门传音频的线,它会在每个采样周期里依次传左声道和右声道的数据。
接下来是 DMA,直接内存访问。音频是持续不断的,如果每一帧都要 CPU 亲自去搬,CPU 就什么别的都干不了了。DMA 的作用是让数据在硬件和内存之间自动搬运,CPU 只管每隔一段时间来处理一批。
数据进了内存,操作系统里的音频子系统接手。Linux 上是 ALSA 和 PulseAudio,Windows 上是 WASAPI,macOS 上是 CoreAudio。这一层的职责是协调多个程序对麦克风的访问、做重采样和混音、处理缓冲区。
到了这一步,你的程序调用录音接口,拿到的已经是一列整数了。程序要做的事只剩一件:把这些整数按某种格式写进文件。
这个格式,要么是 WAV,要么是 MP3。
五、WAV:44 字节的头,剩下全是数据
WAV 是微软和 IBM 在 1991 年一起定的格式,全称是 Waveform Audio File Format。
它的结构简单到有点朴素。整个文件就是一个 RIFF 容器,里面装着两个块。
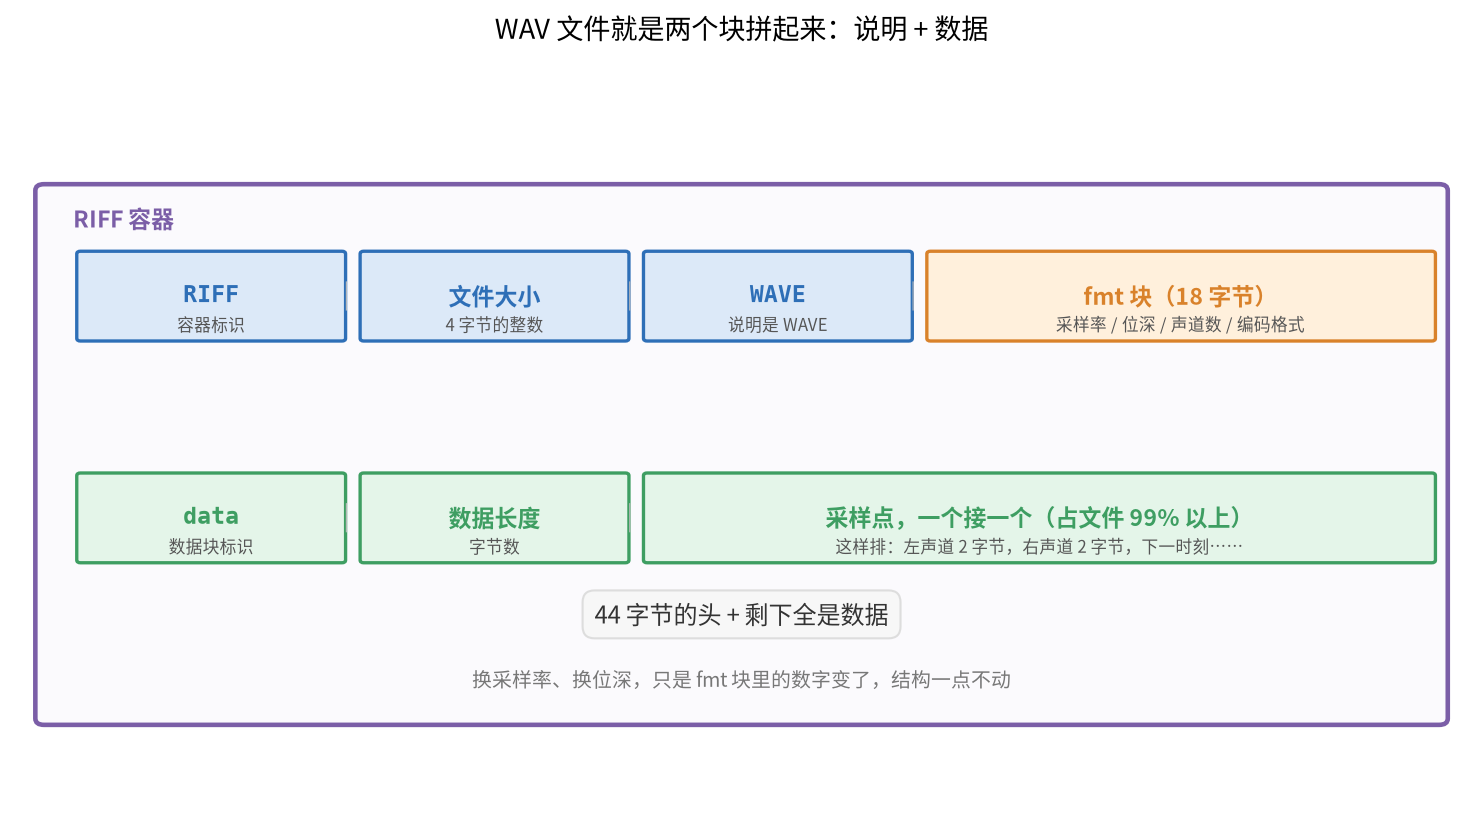
RIFF 是 Resource Interchange File Format 的缩写,是当时一套通用的容器规范。它的规矩是:每个块都以 4 个字节的标识开头,接着 4 个字节说明这个块有多长。
WAV 只用了其中两个块。fmt 块描述音频参数,data 块装实际数据。就这么多。
逐字节拆一个真实的 WAV
光看结构图不够,我实际用代码写了一个 WAV 出来,把它的前 64 个字节打印出来看。
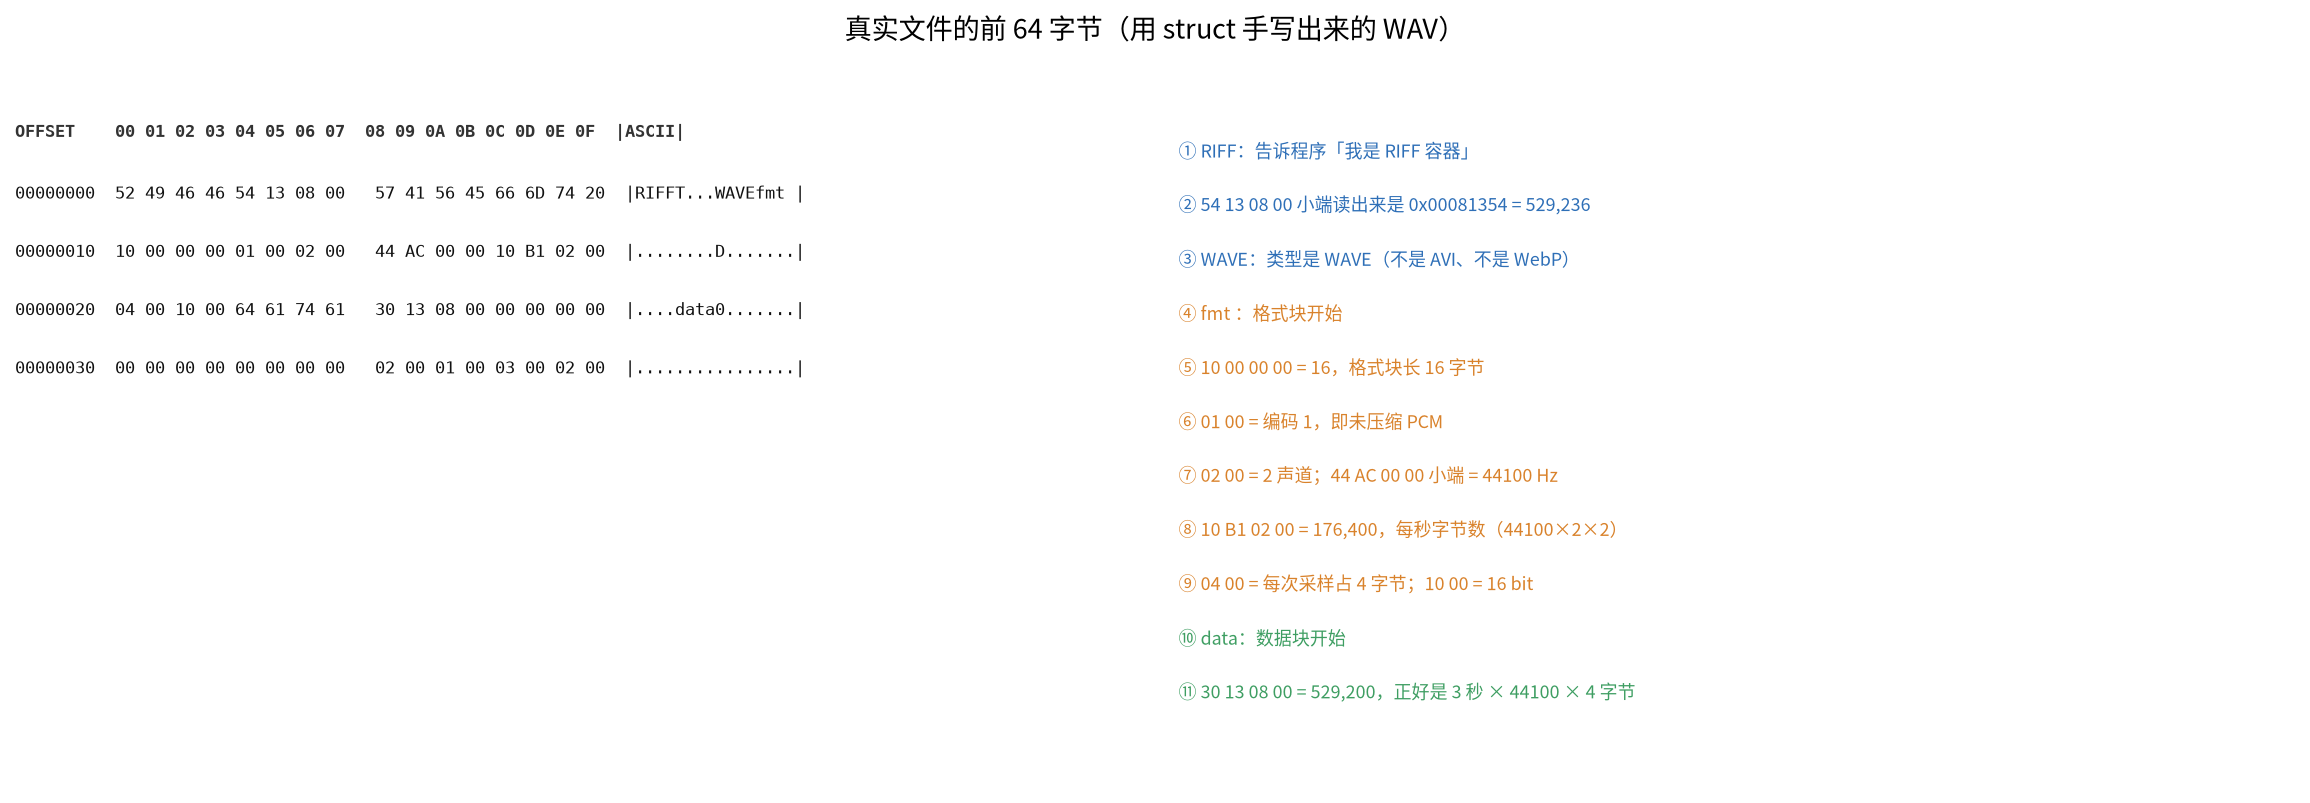
对照着看,前 44 个字节是这样排的:
1 | 偏移 0 52 49 46 46 RIFF 容器标识 |
有几处值得停下来看一眼。
偏移 4 那个数字是 529,236,不是文件大小 529,244。 因为它算的是”除了标识和长度这 8 个字节之外,后面还有多少”。529,244 减 8,正好是 529,236。
偏移 28 的 176,400 是可以从别的字段推出来的。 44100 × 2 声道 × 2 字节(16 bit),正好 176,400。它不是独立信息,是冗余存储的,方便程序快速读取。
偏移 40 的 529,200 就是三秒的数据量。 44100 × 3 秒 × 2 声道 × 2 字节 = 529,200。严丝合缝。
所有多字节整数都是小端存放的。 44100 的十六进制是 0xAC44,但文件里写成 44 AC,低位在前。这是 x86 系列的字节序传统,读的时候要注意。
WAV 的优点是简单,缺点也是简单
它不压缩。517 KB 就是 517 KB,不会因为内容简单而变小,也不会因为内容复杂而变大。
这在某些场景下反而是优点。音频编辑软件要反复读写、要精确定位到某一个采样点,一个结构固定、不需要解码的文件要方便得多。所以专业录音棚里,存档用的通常还是 WAV。
代价就是体积。三分钟 CD 音质要 31 MB,一张 CD 装不下几首歌。
六、软件怎么写一个 WAV
写 WAV 其实不需要任何音频库,就是拼字节。
Python 里有个 wave 模块,但为了看清楚每个字段在哪,我直接用 struct 手动拼了一个。
1 | import struct |
struct.pack 的第一个参数里的 < 表示小端,I 是 4 字节无符号整数,H 是 2 字节无符号整数,h 是有符号的 2 字节整数。
跑完这段代码,你就得到了一个能双击播放的 WAV 文件。总共 44 个字节的头,加后面的数据,没有别的东西。
真正录音时,samples 那部分来自音频接口。以 Python 为例,用 sounddevice 库可以这样录:
1 | import sounddevice as sd |
拿到的 audio 是形状为 (132300, 2) 的数组,132300 就是 44100 乘 3。每一行是一个时刻的左右声道值,范围是 -1.0 到 1.0。把它喂给上面那段拼字节的代码,就成了一个 WAV 文件。
七、MP3 凭什么能压到十分之一
WAV 的问题是太诚实,听到什么就存什么。MP3 的思路是:有些东西你听不见,那就不存了。
这个”听不见”不是拍脑袋,是有科学依据的,叫心理声学。
人耳有掩蔽效应
假设同时有两个声音。一个很响,在 1000 Hz 附近。另一个很弱,在 1300 Hz 附近。
强音会把附近的弱音盖住。你的耳朵在那个频率位置上,感知不到弱音的存在,哪怕它确实在空气里。
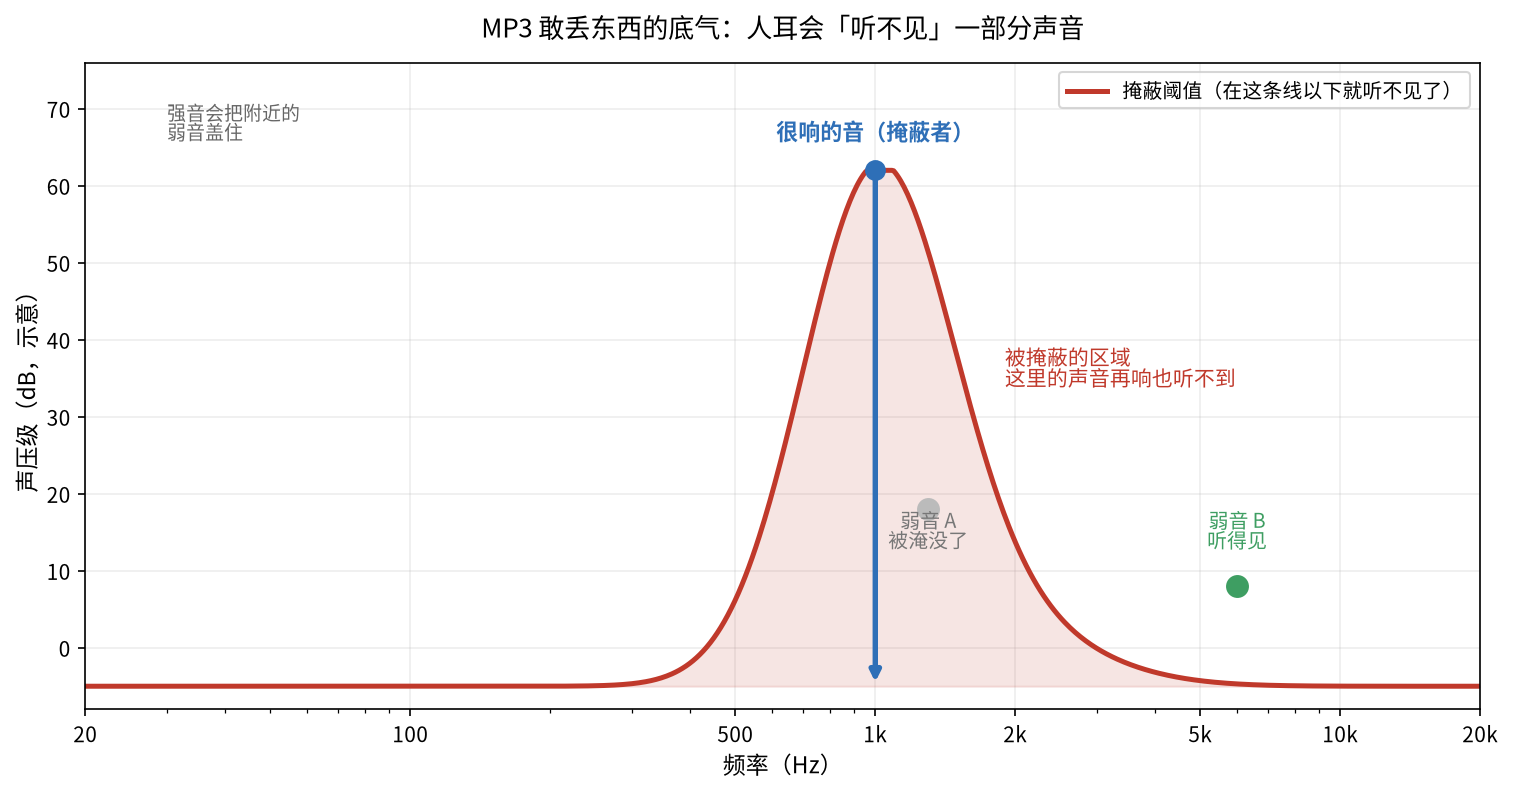
这个效应的作用范围是一条曲线,不是窄窄的一条。离强音频率越近,盖得越狠;离远了才慢慢恢复。而且这条曲线是不对称的,往高频方向盖得更宽。
还有一个上限
人耳能听到的最高频率大约 20 kHz。超过这个频率的声音,无论多响,绝大多数人都听不见。而且这个上限随年龄下降,三四十岁的人往往只能听到 16 kHz 左右。
这两个事实合起来,就给了 MP3 操作空间。凡是落在掩蔽区里的成分,凡是超过听觉上限的成分,都可以用很少的比特去表示,甚至直接丢掉。
编码流程
MP3 的编码是一条流水线,每一站都在做取舍。
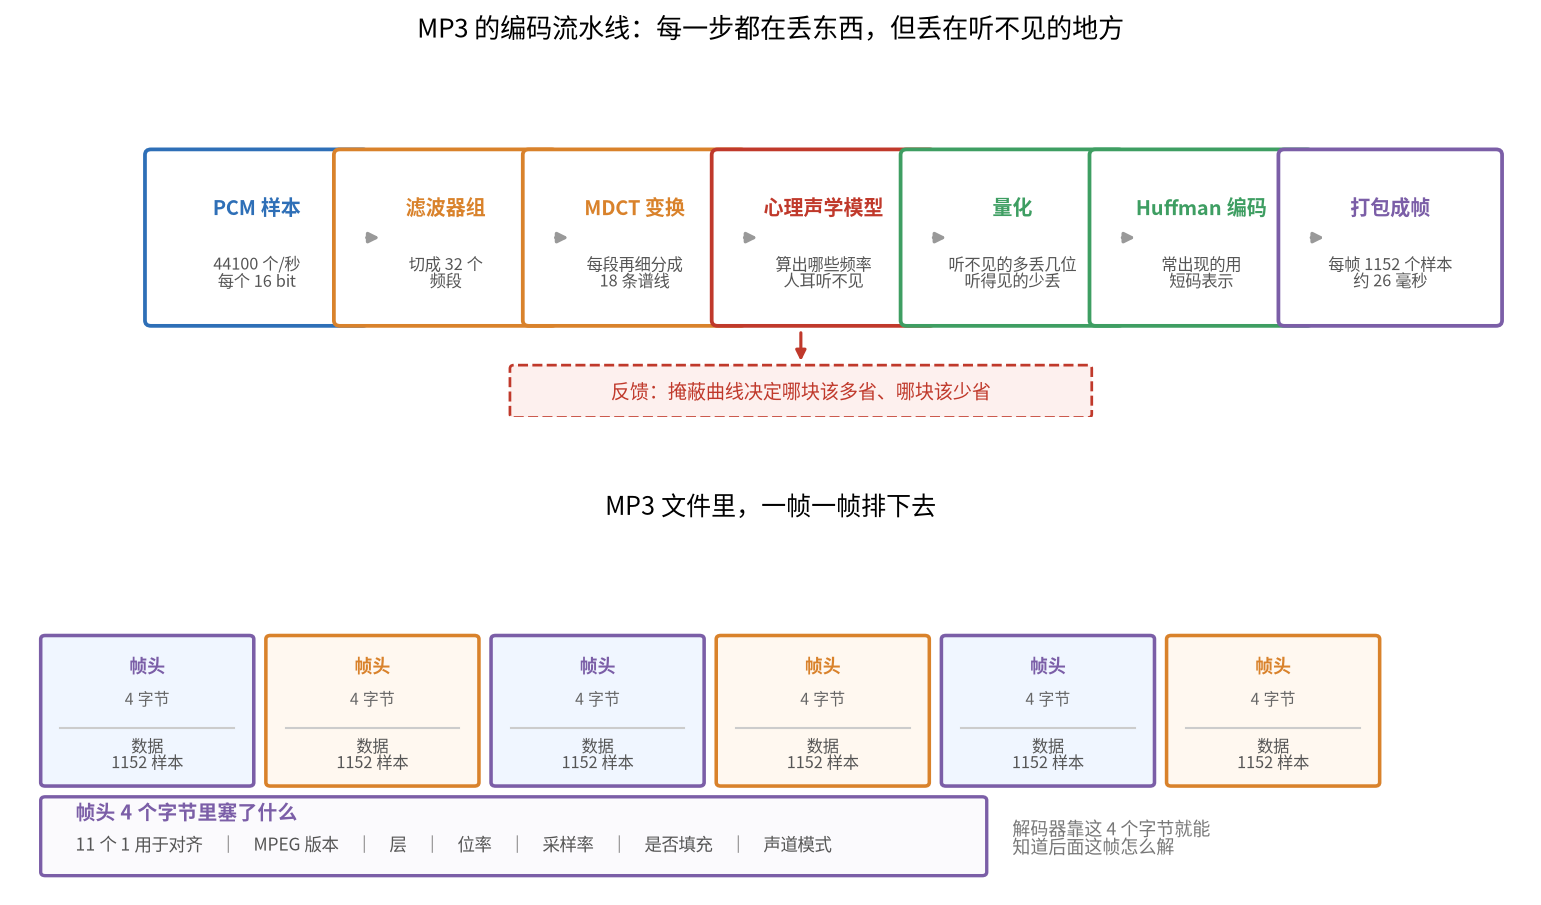
滤波器组把信号切成 32 个频段,这样后面的处理可以分频段进行。
MDCT 变换(改进的离散余弦变换)在每个频段内部再细分成更细的谱线,粗算下来一个时间窗内能分出几百条。这一步把时域波形转成了频域表示,只有到了频域,才谈得上”哪些频率听不见”。
心理声学模型根据当前这一窗信号的强度分布,算出一条掩蔽阈值曲线。这条曲线告诉编码器:哪些谱线是必须保留的,哪些可以粗略表示。
量化是最关键的一步。量化步长按掩蔽阈值来定,每个频段都不一样。听不见的地方步长放大,误差大也无所谓;听得见的地方步长收紧,保证精度。
Huffman 编码是最后一道无损压缩。经常出现的数值分配短码,不常出现的分配长码。这一步不产生任何损失,纯粹是省比特。
打包成帧。每 1152 个样本打包成一帧,44100 Hz 下大概是 26 毫秒。一帧内所有信息打包在一起,前面加 4 个字节的帧头。
帧头里有什么
那 4 个字节的信息密度很高,塞了一个解码器需要的全部信息。
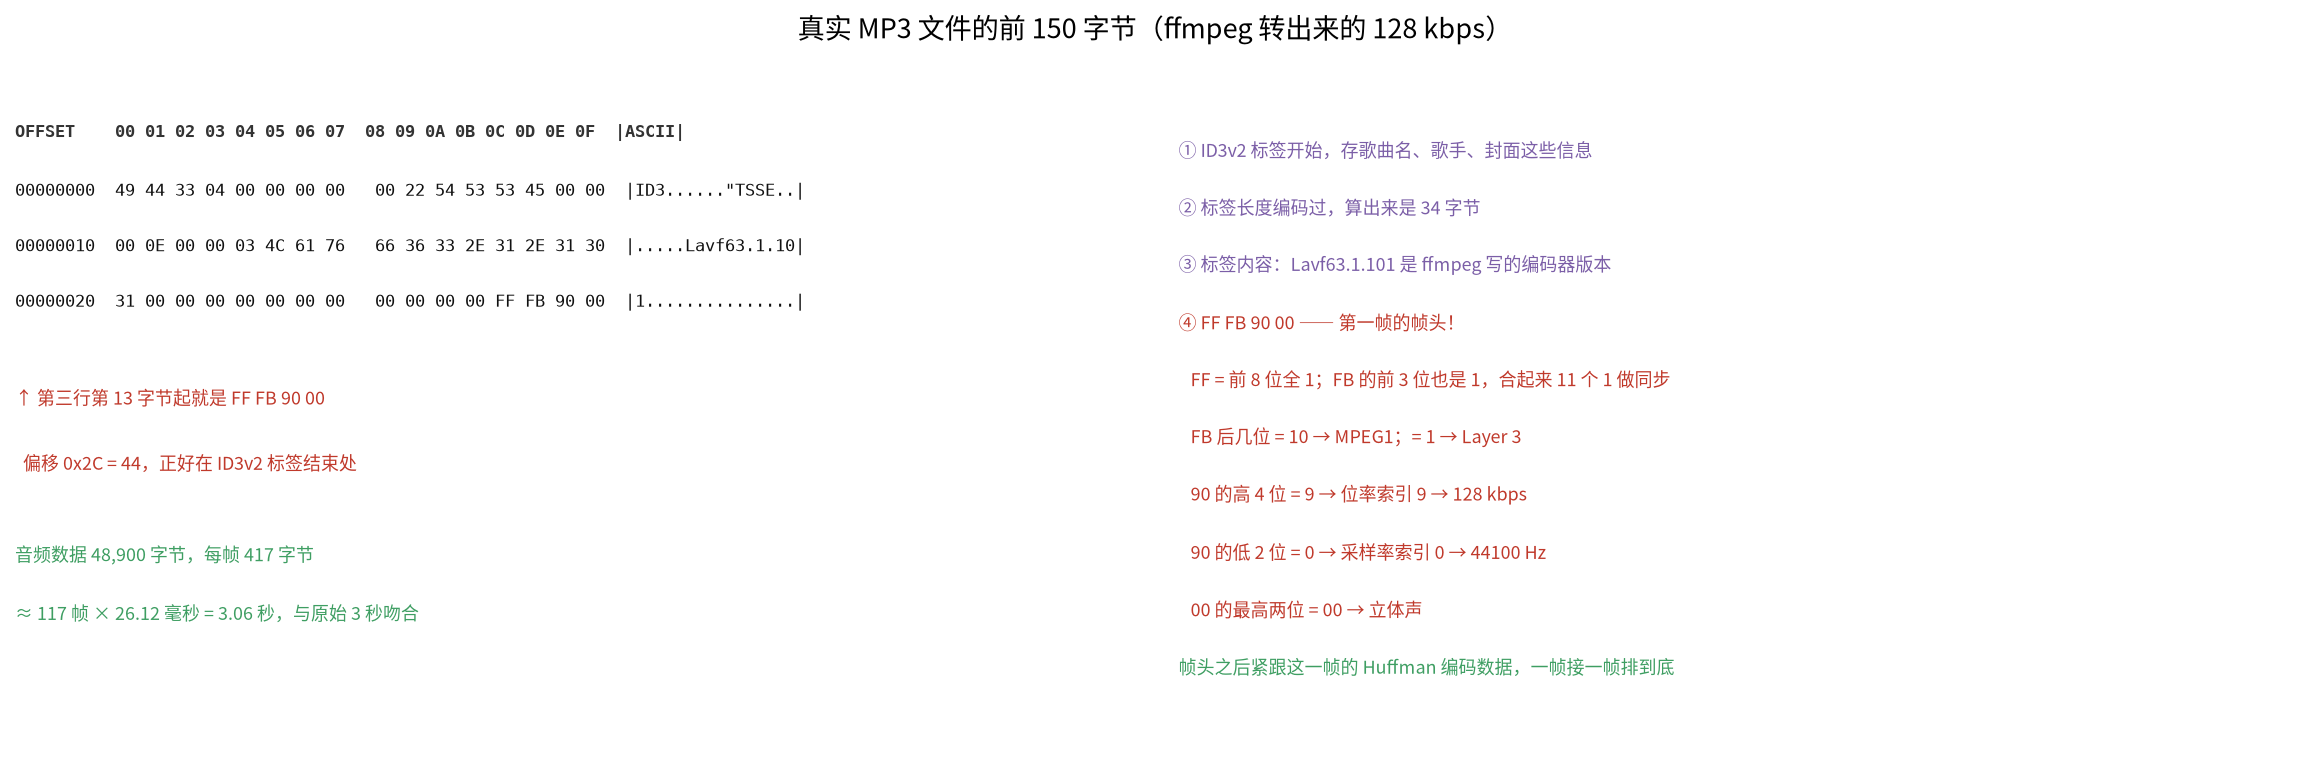
拿我实际生成的那个 128 kbps 文件来说,第一帧的帧头是 FF FB 90 00。
前 11 位全是 1,这是同步字。解码器在文件里搜索这 11 个连续的 1,找到就认为一帧从这里开始。MP3 没有固定的帧位置表,全靠这个同步字来切分。
接下来的位段依次是:MPEG 版本、层号、位率索引、采样率索引、是否填充、声道模式。我这里解出来是 MPEG1、Layer 3、位率索引 9(对应 128 kbps)、采样率索引 0(对应 44100 Hz)、立体声。
这个文件的音频数据一共 48,900 字节。128 kbps 下每帧 417 字节,除下来大约 117 帧。每帧 26.12 毫秒,117 帧正好凑成 3.06 秒,跟原始的三秒音频对得上。
顺带说一个自己动手时会踩的坑。如果只是简单地在文件里搜索 FF 开头、后一位的高三位也是 1 的位置,会数出一大堆候选,远多于真实帧数。因为压缩后的数据接近随机,FF 这种字节组合本来就会自然出现,属于误检。想数准,得先用帧头里的位率索引算出这一帧有多长,跳过去再找下一帧。这个判断逻辑就是解码器切分帧的方式。
文件头的 ID3 标签
你可能注意到,上面那段十六进制里,第一帧的位置是从偏移 44 开始的,前面那段是 49 44 33,也就是 ID3。
这是 ID3v2 标签。歌曲名、歌手、专辑、封面图片这些信息都存在这里,跟音频数据分开。因为长度可变,它有自己的长度字段,前面那个文件里算出来是 34 字节的内容长度。
这也意味着一个 MP3 文件里,音频数据的位置不是从 0 开始的。写解析器的时候要先跳过这段。
八、同一段声音,两种格式,差在哪
我把同一段三秒的声音用两种格式存了一遍,然后把它解码回来看频谱。
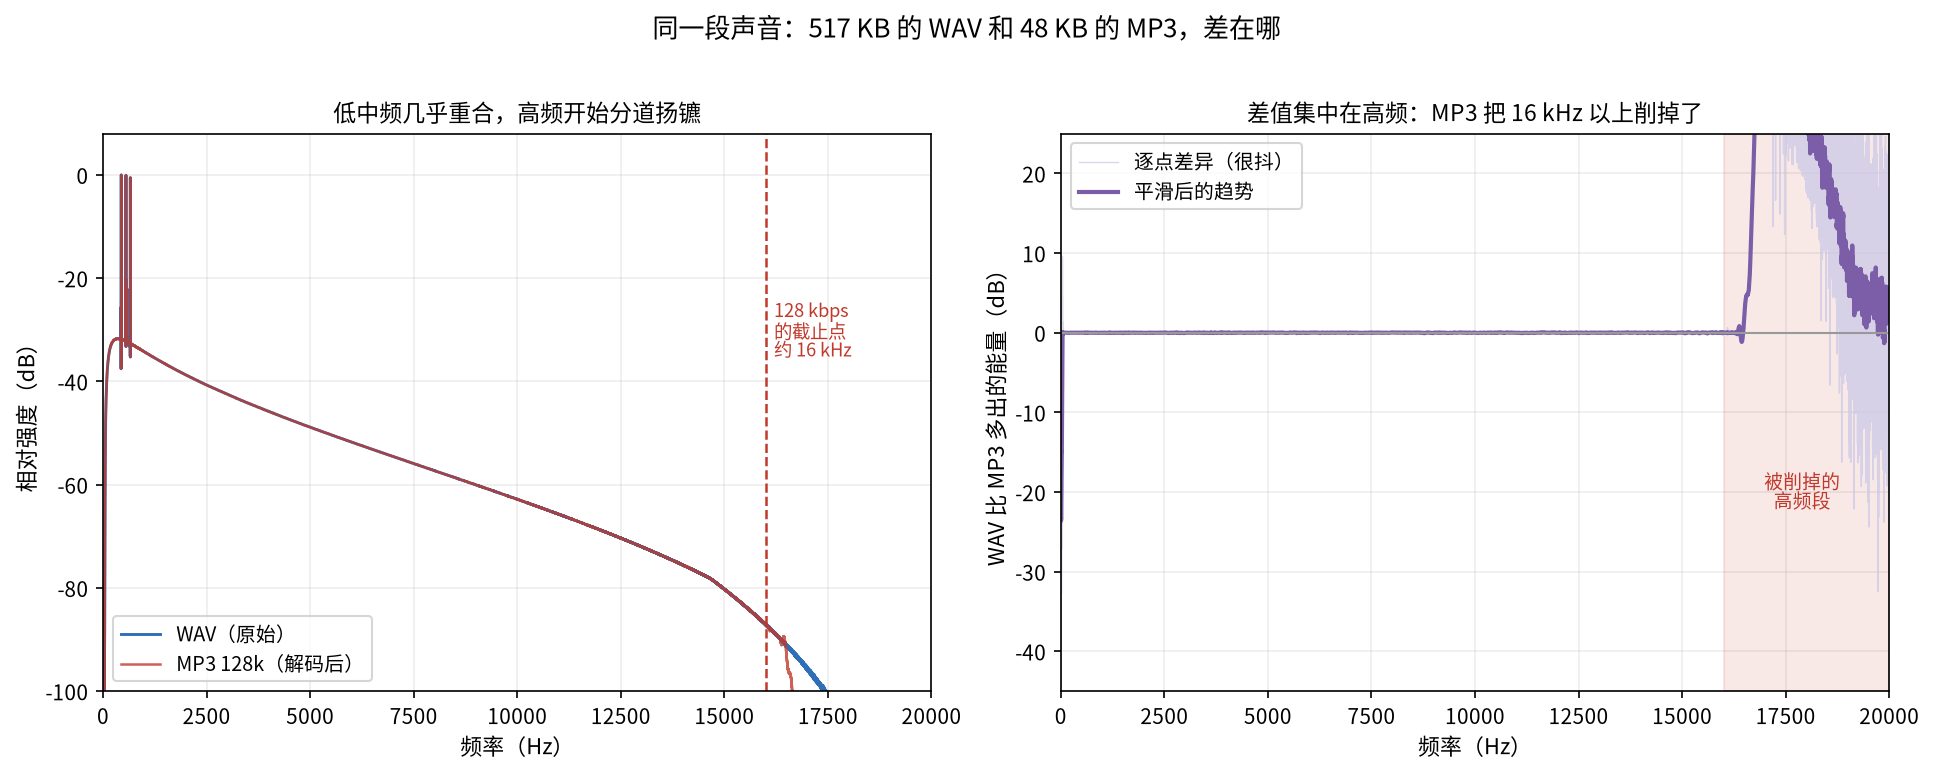
左边这张图里,蓝线是 WAV,红线是 MP3 128 kbps 解码回来的。低频和中频部分两条线基本重合,几乎看不出差别。到了 16 kHz 之后,红线直接掉了下去,而蓝线一直延伸到 20 kHz。
右边这张图把差值画出来。16 kHz 之前差值基本是 0,之后陡然上升。这就是 MP3 省下来的东西,它把高频砍掉了。
砍掉的这部分,绝大多数人在正常听音环境下察觉不到。要听出来需要好几个条件同时满足,得有不错的耳机、安静的环境,还得是特别熟悉、高频又丰富的曲目。
几个实测数字:
| 格式 | 文件大小 | 相对 WAV |
|---|---|---|
| WAV(CD 音质) | 517 KB | 100% |
| MP3 320 kbps | 119 KB | 23.1% |
| MP3 128 kbps | 48 KB | 9.2% |
| MP3 VBR q2 | 39 KB | 7.6% |
| WAV(8 kHz 单声道) | 47 KB | 9.1% |
最后一行值得看一眼。它也是 WAV,没有做任何压缩,但因为把采样率降到 8000、声道降到单声道,体积就掉到了 47 KB。
这说明一件事:决定体积的有两个环节。一是采样和量化时选什么参数,二是编码时丢不丢东西。前者是”一开始就不记”,后者是”记了再扔”。WAV 和 MP3 的区别在于用不用第二招。
九、自己动手
上面提到的数字都可以自己复现。需要的工具不多。
看自己的 WAV 文件
Linux 或 macOS 下,直接用 xxd 看前 64 个字节:
1 | xxd -l 64 your_file.wav |
你会看到 52 49 46 46 开头,然后是文件长度、57 41 56 45(WAVE)、66 6D 74 20(fmt )、64 61 74 61(data)。对照第五节的表逐个读。
Windows 下可以用 PowerShell:
1 | Format-Hex -Path your_file.wav -Count 64 |
转格式比大小
装了 ffmpeg 的话,一条命令就能对比:
1 | # 造一段测试音频,3 秒,CD 音质 |
最后那条命令会生成一张频谱图,高频截止的位置一眼就能看到。
猜帧头
找个 MP3 文件,用 xxd 往后翻,找到第一个 FF 开头、后面一位的高三位也是 1 的位置,那就是第一帧的帧头。把 4 个字节抄下来,对照第七节解释的意思自己解一遍。
1 | FF F? ?? ?? |
自己解一遍之后,这一串十六进制就不再是天书了。
十、最后
回到开头那三个事实。
为什么 517 KB 能变成 48 KB? 因为 MP3 砍掉了人耳听不见的部分。掩蔽效应让一部分频率可以粗略表示,20 kHz 以上的部分直接丢掉。这两招加起来,省下了九成体积。
为什么 517 KB 里只有 44 字节是参数? 因为 WAV 的格式设计极度简单。一个 RIFF 容器,两个块,参数总共 44 字节,其余全是原始采样。这种简单是有意为之。1991 年定这个格式的时候,可预测性和易解析性比体积重要得多。
为什么改采样率能到 47 KB? 因为体积是采样率、位深、声道三个参数的乘积。任何一项降下来,体积就按比例降。这里没有魔法,就是乘法。
声音从空气的振动开始,经过麦克风的转换、ADC 的采样量化、总线和驱动的搬运,最后落在磁盘上,成为一个有固定结构的字节序列。
这个序列长什么样,取决于你在哪一步做了取舍。