飞秋(FeiQ)3.0.0.2 协议缺陷分析:设备名册伪造与消息缓冲残留
飞秋(FeiQ)是一款局域网即时通讯工具,在机房、教室和不少单位的内部办公网里还在使用。它装完即可使用,不需要服务器和账号,同一网段内的机器会自动出现在好友列表里,通信走 UDP 2425。
我最近对它的协议做了分析,并写了一个内网设备探测工具。分析过程中发现两个问题,一个在协议设计层面,一个在内存安全层面。本文记录协议还原的结果、两个问题的原理、实测数据和修复建议。
报文格式
飞秋的协议没有公开文档,但与 IPMSG(IP Messenger)同源。抓取 3.0.0.2 广播的报文可以看到,一条报文就是一段可读字符串,字段之间用 # 和 : 分隔:
1 | 1_lbt6_0#128#001122334455#0#0#0#4001#9:1792156361:USER:PC-NAME:0:<消息>\0 |
报文分两段。# 之前是第一段,最多八个字段;: 之后是第二段,格式与 IPMSG 一致。字段含义见图一。
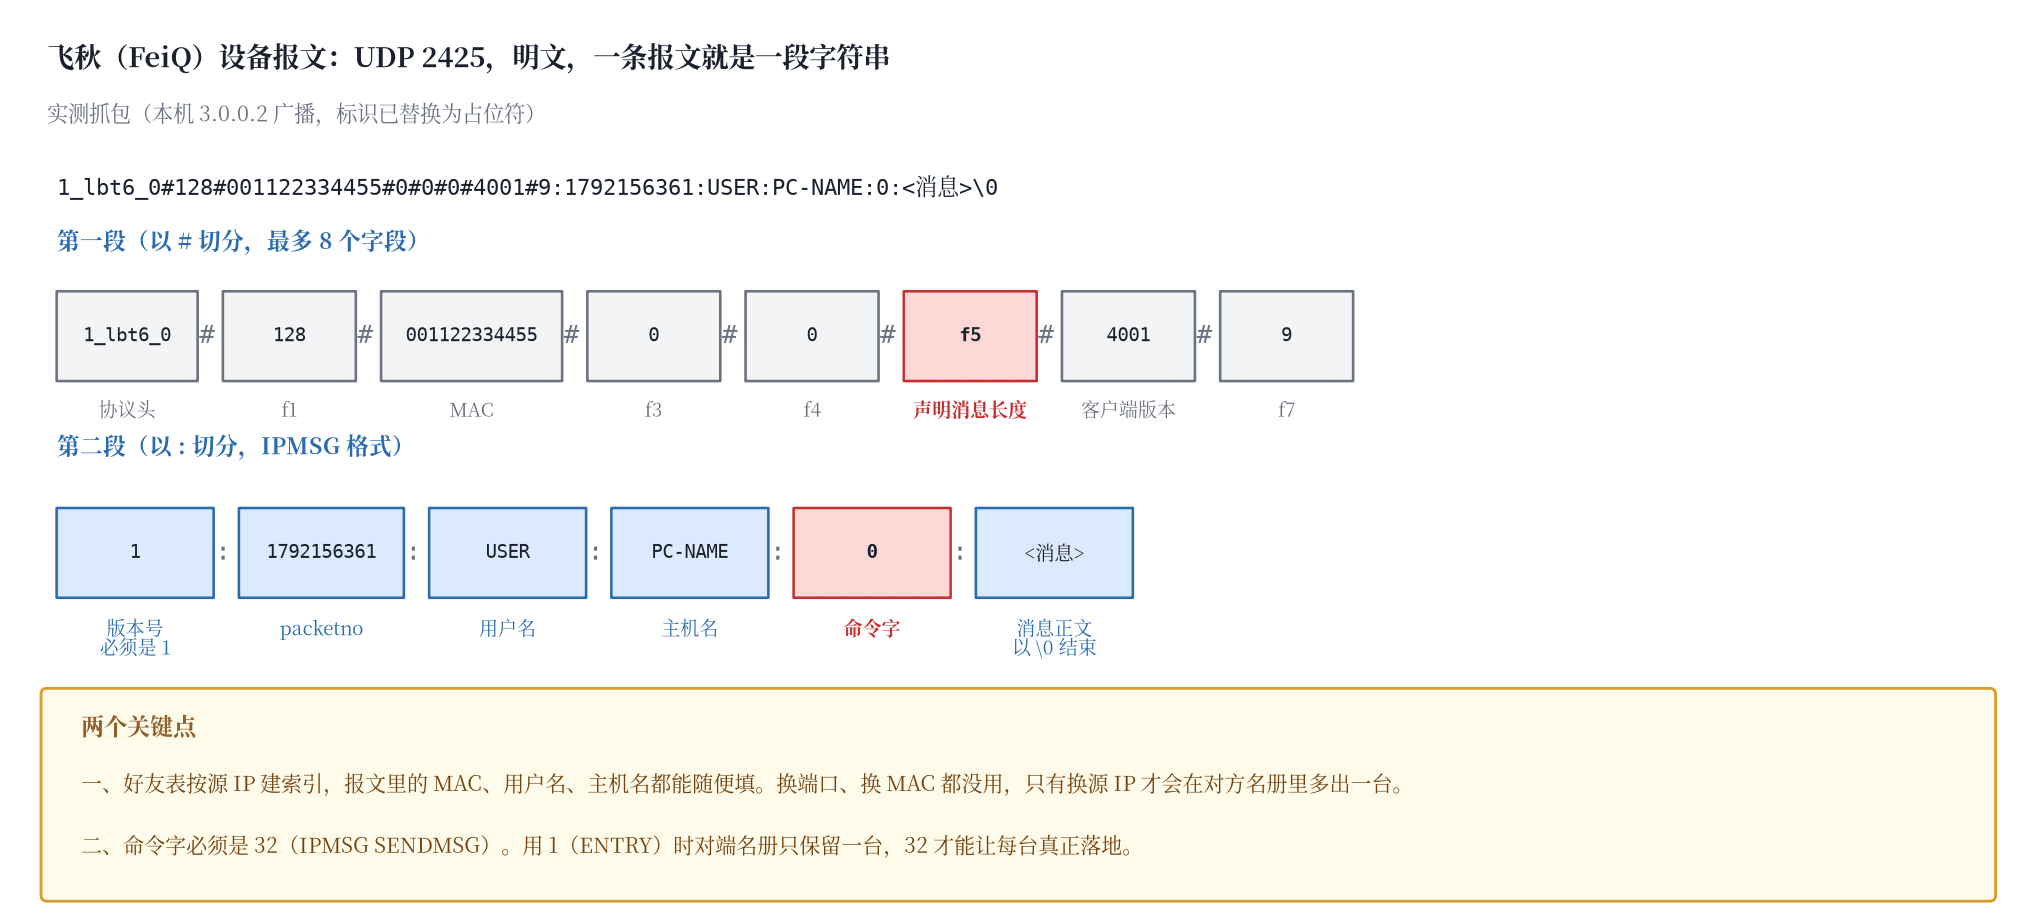
有两个字段需要单独说明。
f5 声明这条消息的字节数,第二个缺陷与它直接相关。
命令字必须填 32(IPMSG 中的 SENDMSG)。填 32 时对端会把你登记进名册并回包确认;填 1(ENTRY)时,如果对端已经有一台设备使用同一个源 IP,名册里只会保留一台,这一点在调试工具时反复遇到。
样本为 FeiQ.3.0.0.2.exe,18,290,688 字节,PE32 格式,未加壳(.text 段熵 6.43),MD5 是 BFEA3E87B66B4164BADD346DE8172A36。链接时间戳为 2013 年 6 月,字符串中保留了构建路径 F:\FeiQ2012\source\Client\FeiQClient\Win32\Release\FeiQ.pdb。用 IDA 反编译后,报文解析部分的逻辑可以读成伪代码,本文引用的都是反编译结果。
缺陷一:设备名册以源 IP 为键
飞秋的好友表按源 IP 建立索引,一个源 IP 对应一个账户。报文中的 MAC、用户名、主机名虽然都存在,但不参与身份判定。
这一结论来自实验,不是来自代码阅读。第一版工具只修改 MAC 和源端口时,对方列表里始终只有一台;改用不同的源 IP 之后,设备数才开始增加。
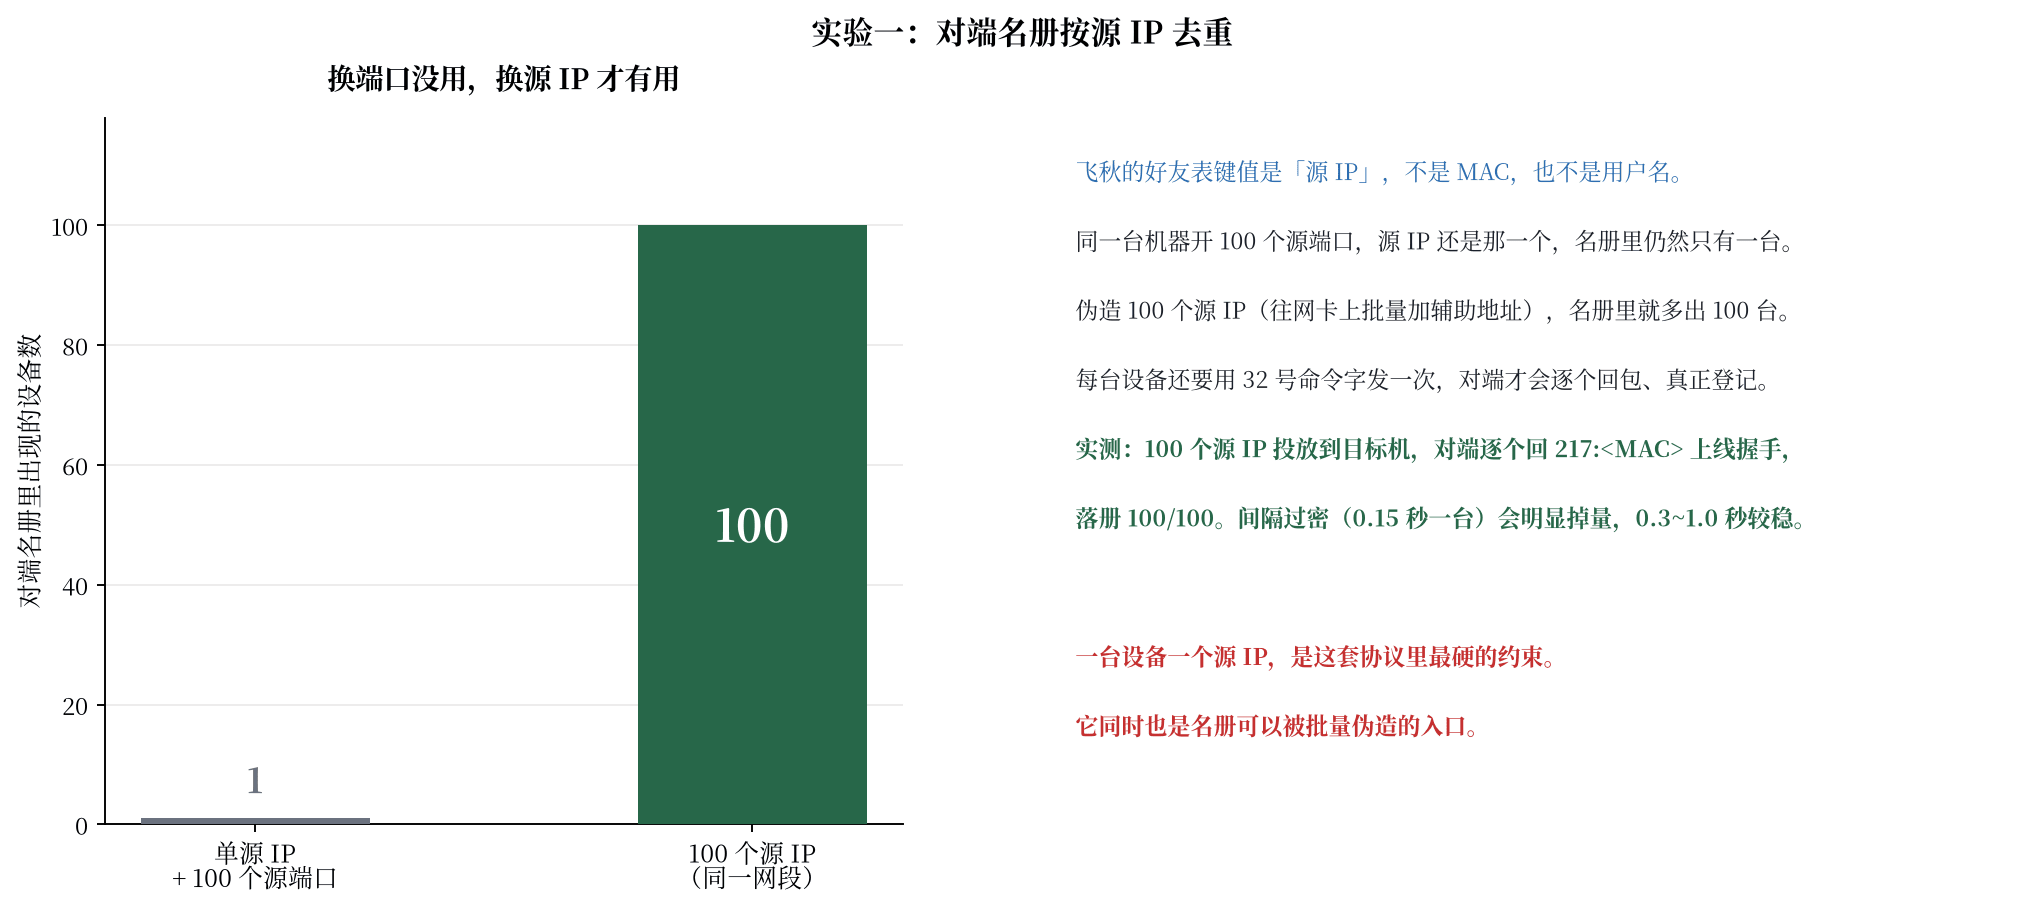
对端名册中的设备数等于不同源 IP 的数量:
说人话:对端认的是数据包的来源地址,不是设备名或 MAC。同一台机器开一百个端口,来源地址仍然是一个,所以只算一台;换一百个来源地址,就成了一百台。
实测结果如下。单个源 IP 配 100 个源端口时,对端显示 1 台;伪造 100 个源 IP 时,100 台全部登记成功,抓包可以看到对端逐个返回 217:<MAC> 的上线握手。工具的处理方式是先探测目标走哪块网卡,在同一网段里挑一段空闲地址,用 CreateUnicastIpAddressEntry 批量添加到网卡上,然后逐台发包。发送间隔过密会掉量,0.15 秒一台时明显丢失,间隔 0.3 到 1.0 秒比较稳定。
这一项属于协议设计层面的信任模型问题,无法通过修改单个函数解决,需要改变协议中的身份定义。
缺陷二:消息缓冲区缺少终止符
第二个问题属于内存安全,复现稳定。
解析报文时,消息正文会被拷贝到会话对象里一块 0x8000 字节的缓冲区,偏移为 +0x118。反编译后的代码大致如下:
1 | /* 0x860489 附近,伪代码 */ |
这里有三个问题。
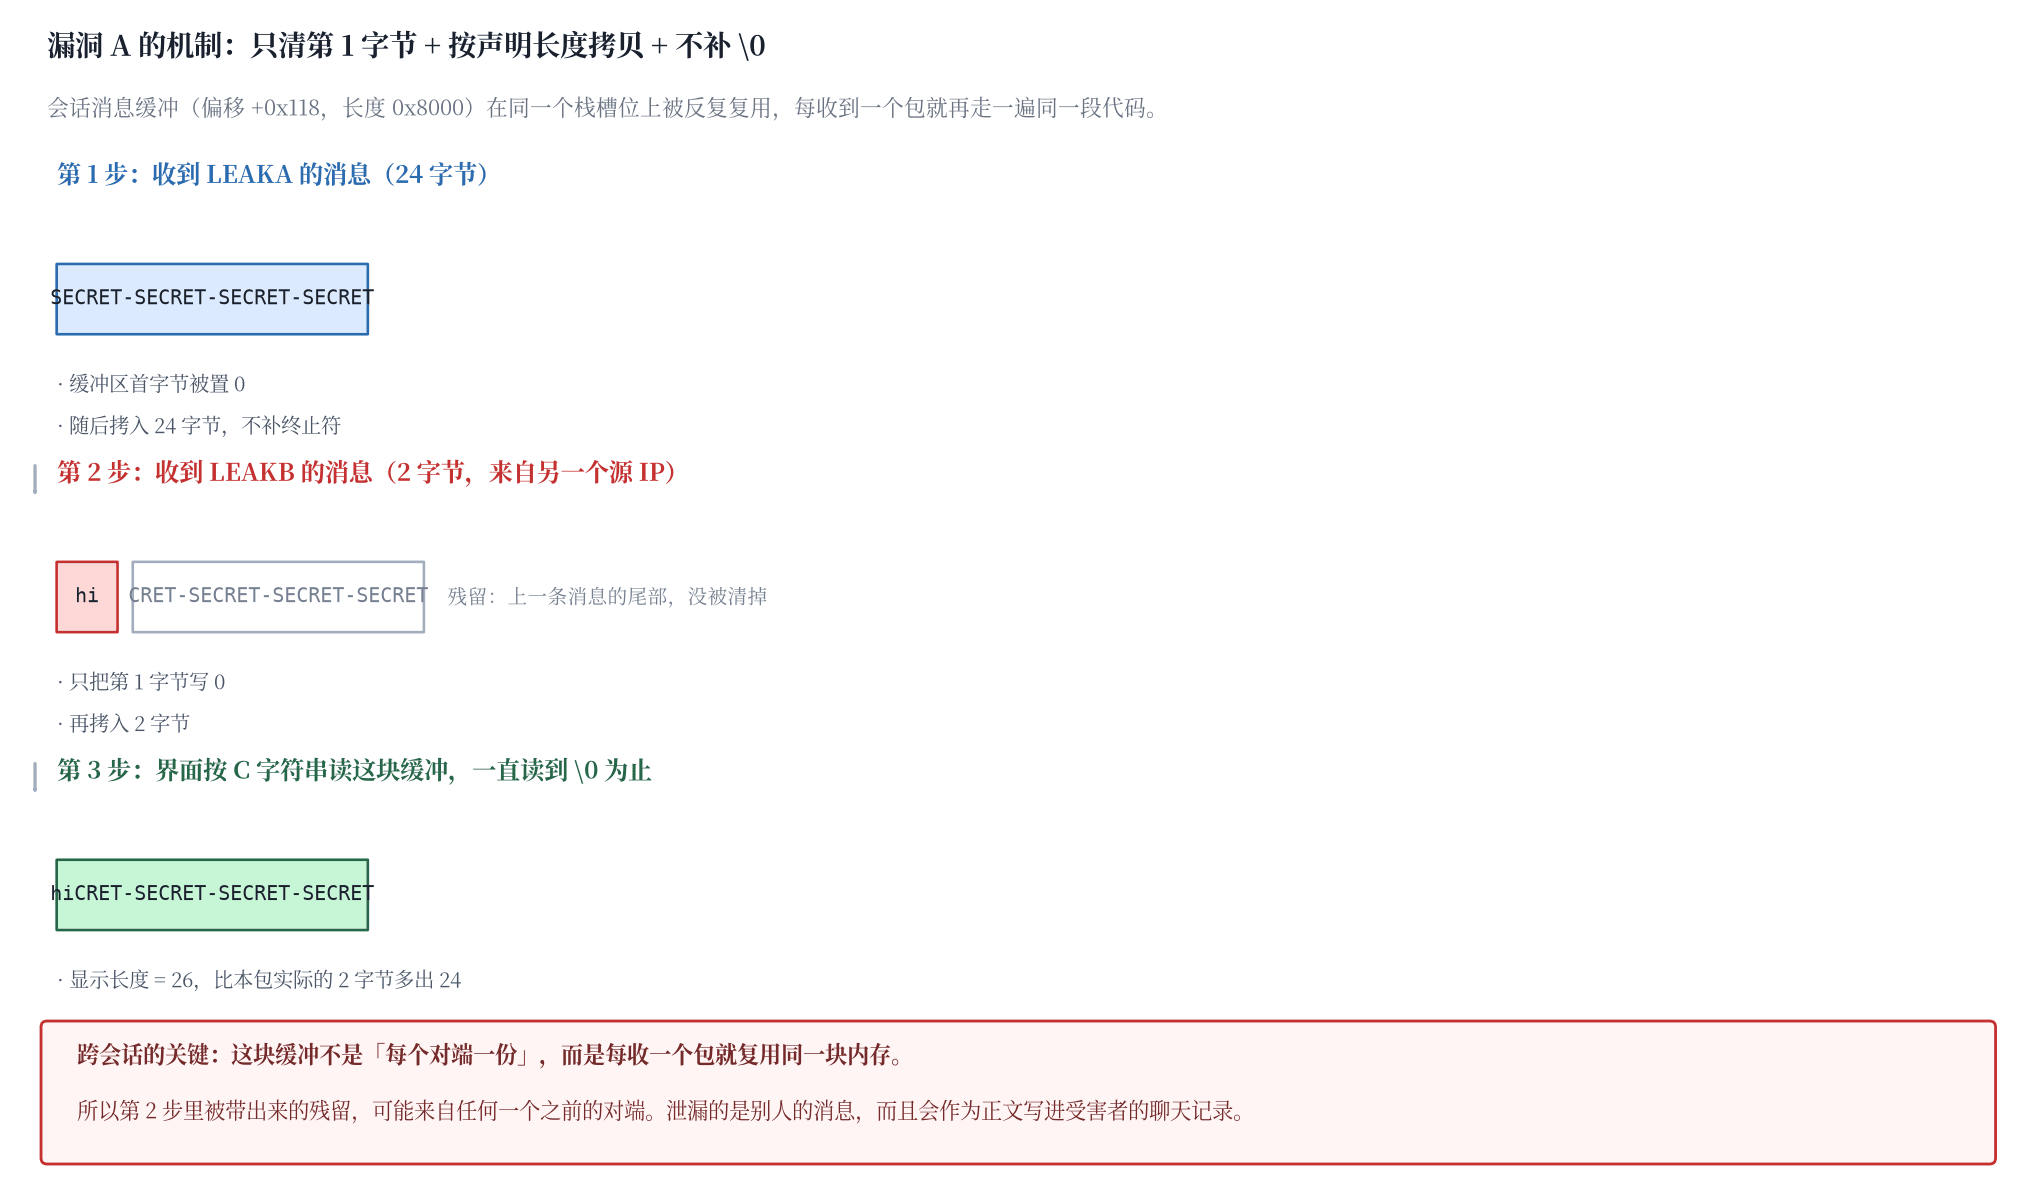
缓冲区没有整体清空,只把第一个字节置为 0,a2+0x118 之后的内容仍然是上一次留下的。
拷贝按字段 f5 声明的长度进行,不保证结尾是 \0。
长度记账写的是「声明长度加一」,但实际写入的字节中没有这个终止符,账目与实际不一致。
聊天窗口和聊天记录把这块缓冲区当作 C 字符串读取,会一直读到 \0 为止。当本次消息比上一条短时,多出来的部分就是上一条消息的残留。
写成不等式:
说人话:程序显示多长,取决于缓冲区里第一个零字节在哪儿;这条消息实际写了几个字节,它并不关心。两者之间的旧数据就一起被读出来了。
实测
构造两条消息,分别来自不同源 IP:
| 设备 | 源 IP | 消息正文 | 声明长度 | |
|---|---|---|---|---|
| A | LEAKA | 127.0.0.62 | SECRET-SECRET-SECRET-SECRET |
24 |
| B | LEAKB | 127.0.0.63 | hi |
2 |
先发 A,再发 B。受害者飞秋窗口里的实际显示如下,这是用 WM_GETTEXT 读取 RichEdit 控件原文得到的,不是肉眼观察:
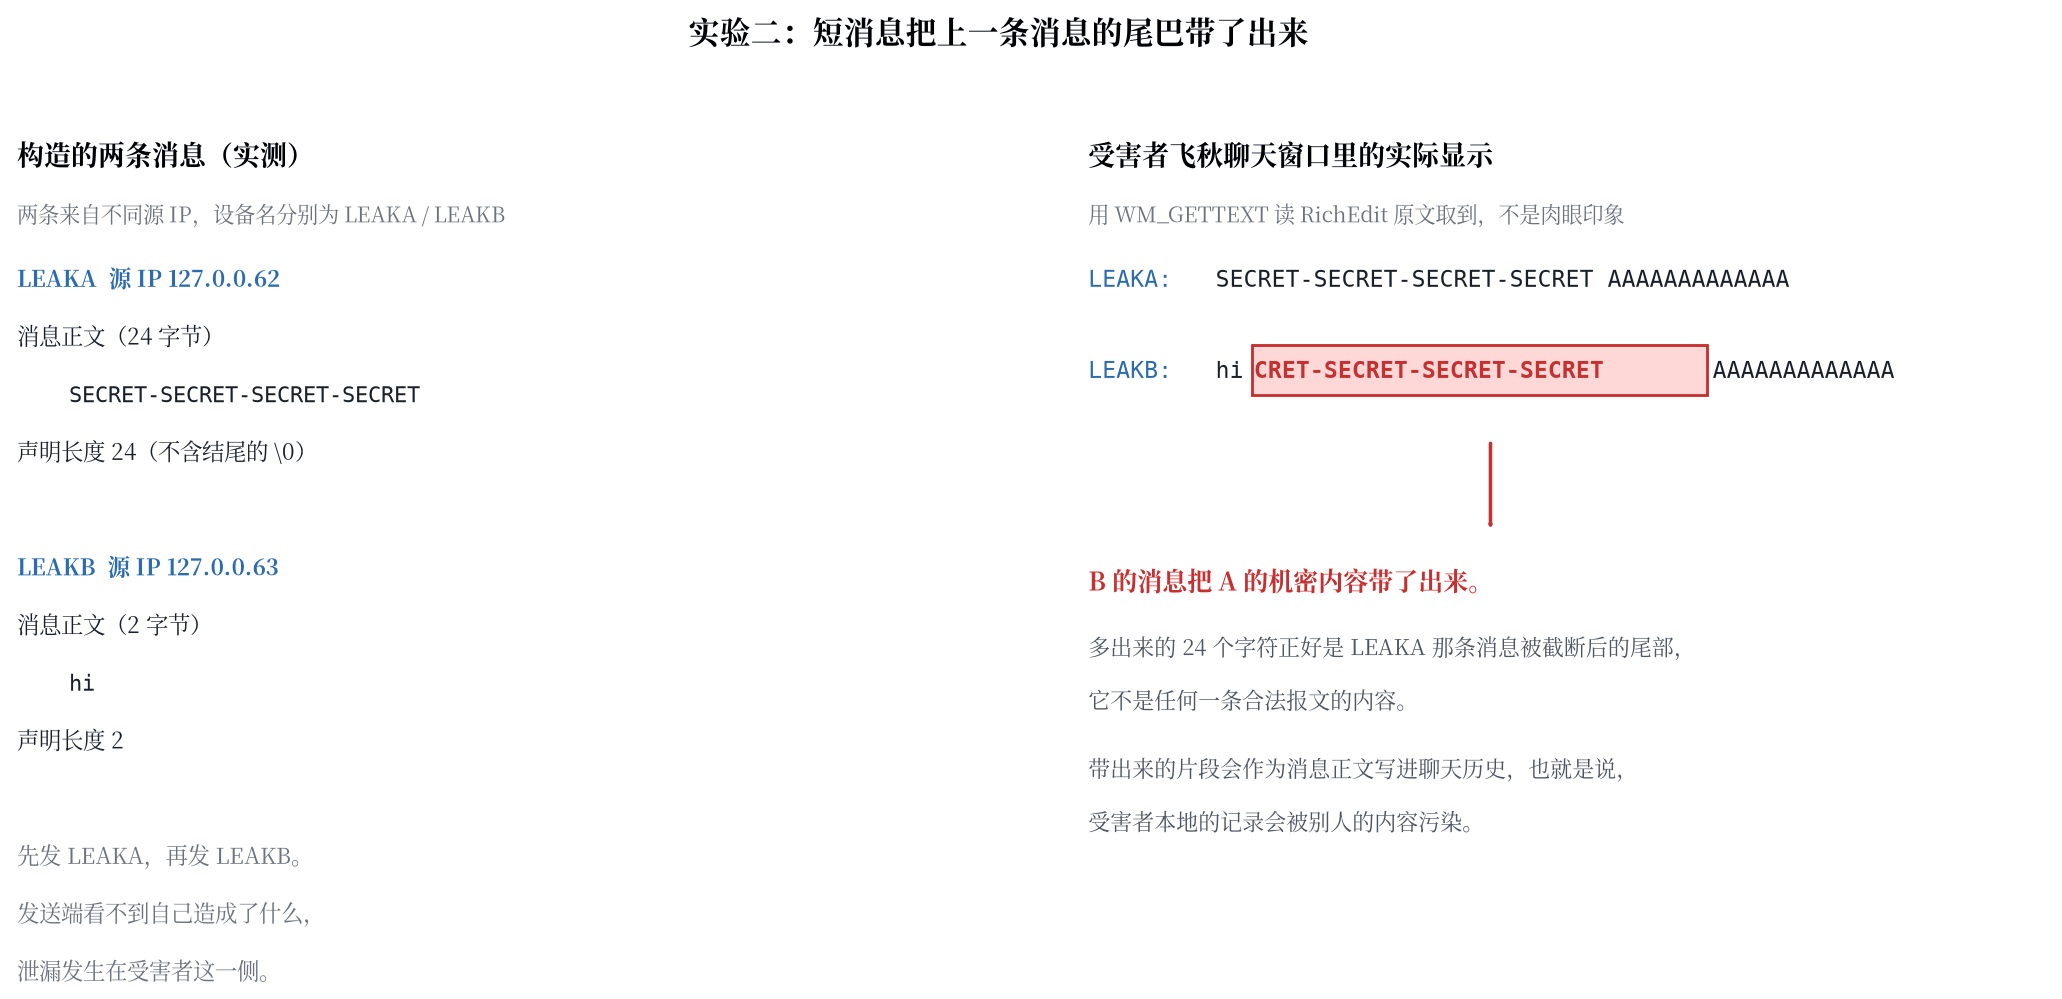
B 的消息把 A 的内容带了出来,多出的 24 个字符正是 A 那条消息被截断后的尾部。
跨会话的原因
这块缓冲区不是每个对端一份。消息处理函数中的会话结构是栈上的局部变量,每收到一个包都会重新执行同一个函数,同一个栈位置被反复使用。因此残留内容不限于上一个对端,可能来自更早的任意一个连接。
发送端看不到自己造成的泄漏,泄漏发生在接收端。检测方式是在受害者机器上抓包记录收到的正文,再与窗口或历史记录里显示的内容比对,显示内容比报文长出来的部分就是残留。
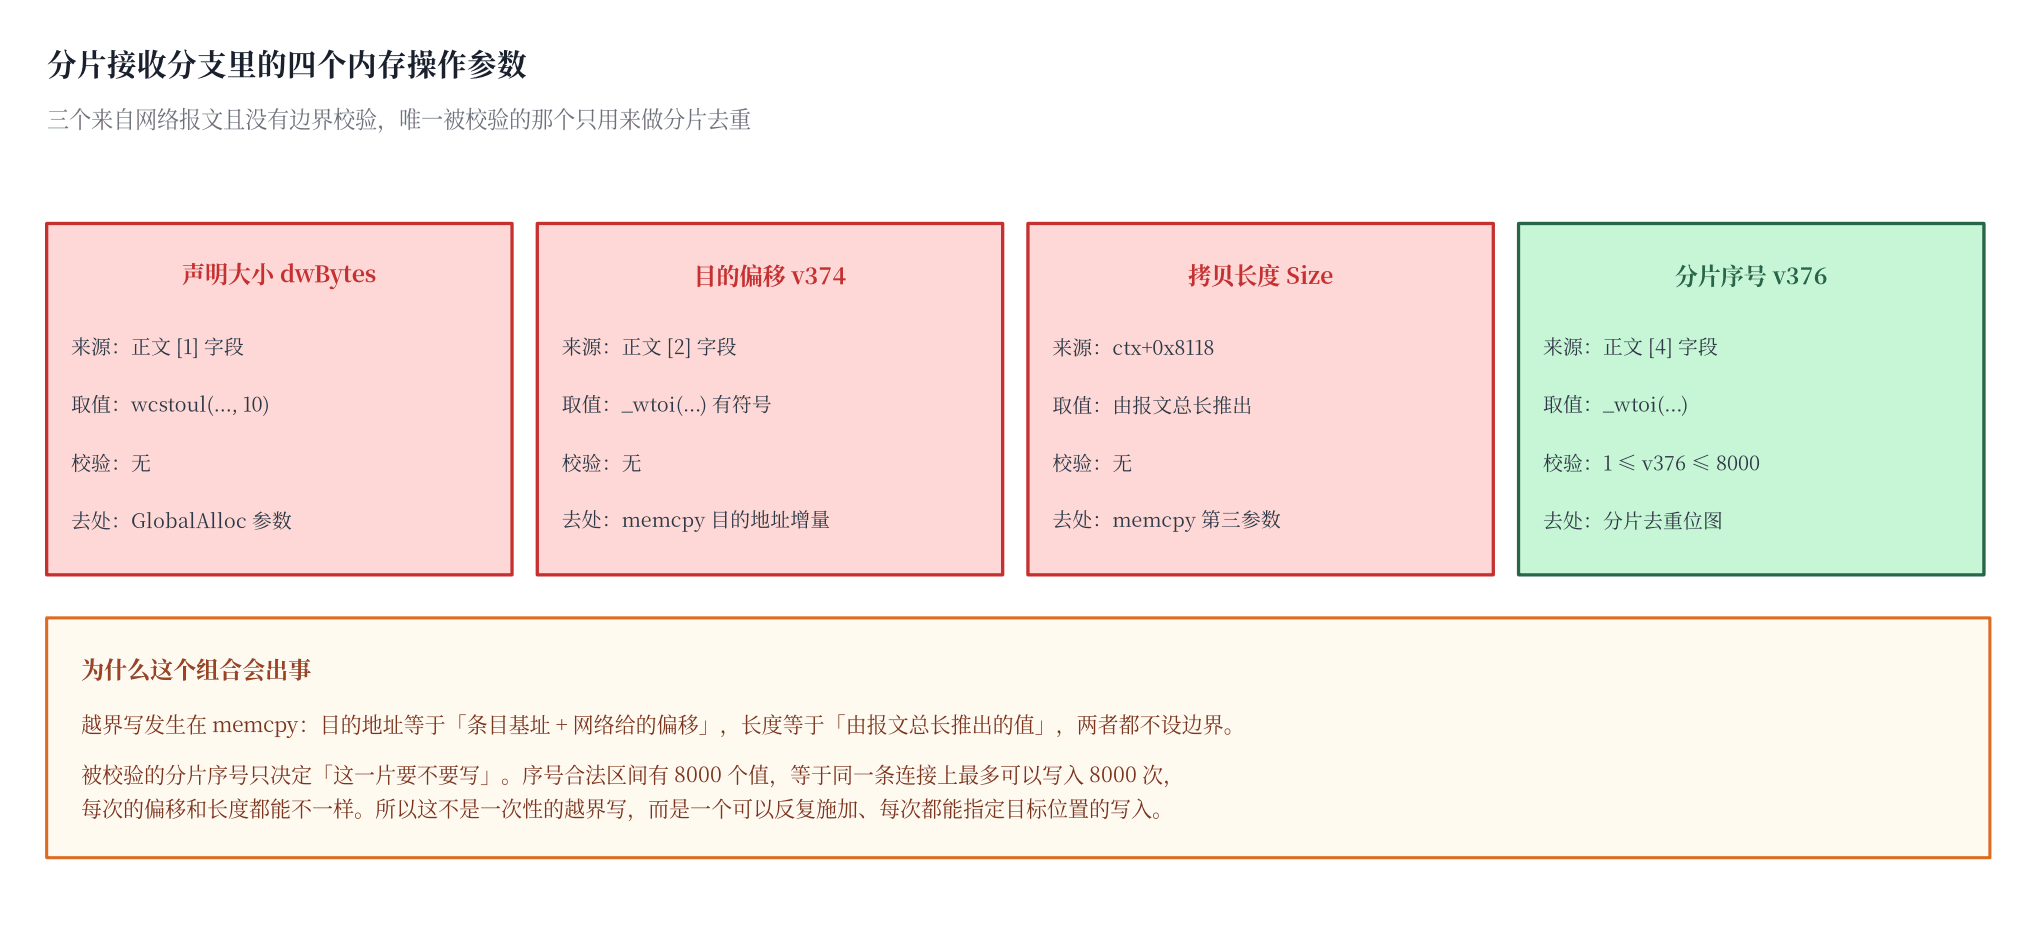
未验证:分片接收的偏移字段
飞秋的图片和文件采用分片传输,接收端按报文中的字段计算写入地址:
1 | /* sub_6B8600,伪代码 */ |
偏移字段直接来自报文,代码中没有检查「偏移加长度是否仍在缓冲区范围内」。同一个文件里群消息分支反而做了长度白名单校验,两处对比可以看出这里缺少检查。
如果 *(条目+0x14) 是缓冲区基址,这里就是一个远端可控偏移的越界写。
但我没有验证成功。用合法分片加超大偏移(例如 0x7FFF0000)投递多轮后,目标进程没有崩溃,说明函数开头的状态判断(this+0x98、cmd != 0x7F 等条件)在拷贝之前就返回了。这一项目前的状态是已定位、未验证,不作为本文的结论。
危害
先说已经证实的部分。
对端名册可以被任意主机批量伪造。攻击者不需要任何凭据,只要能向目标网段发包,就能让目标机器的飞秋列表里出现大量设备,并且每台都可以向它发消息。实测 100 个源 IP 全部登记成功。
消息缓冲区残留会造成跨会话的内容泄漏,泄漏出来的片段会作为消息正文写入聊天记录。受害者本地的聊天记录会被其他人的内容污染,对事后取证也是问题,记录内容的完整性不再可信。
有一类可以合理推断,但没有逐项实测。
在教室和机房这类使用场景里,上述两条可以组合成一种干扰手段。飞秋在课堂上承担发文件、收作业和通知的功能,如果名册被灌入大量陌生设备、每台带一条消息,实际使用的设备会被淹没。这来自协议信任模型被利用后的直接推论,但具体影响到什么程度取决于现场如何配置和使用飞秋,我没有在真实教学环境中测试过。
还有一类是推不出来的。
分片接收处的偏移未校验能否构成实际的越界写,目前没有证据。在验证成功之前,不应把它写成可用漏洞。
修复建议
第一优先是消息缓冲区。拷贝前整块清零,或者拷贝后显式补终止符,使长度记账与实际终止符保持一致。
1 | /* 方案一:拷贝后显式补终止符 */ |
第二优先是分片接收。对偏移做区间校验,要求 offset + size <= 缓冲长度,越界时丢弃并断开会话。同时把「长度字段与长度比较」的位置统一改成无符号比较,并显式判断负值。
第三优先是身份绑定。将 MAC、用户名与源 IP 做一致性校验,名册按 IP 和 MAC 双键索引,新设备上线时增加一次握手确认。这一项需要修改协议,改动最大,对应的是缺陷一的根本原因。
发送端有一个临时规避办法:把结尾的 \0 计入声明长度,对端会连终止符一起拷贝,字符串被正确截断。这只是绕过,无法修复其他机器上的同一个缺陷。
工具与复现
文中用到的工具整理在下面的仓库,使用 C 语言编写,无第三方依赖,包含设备投放和内网探测两部分:
https://github.com/Moxin1044/feiq-virtual-devices
投放工具需要管理员权限,因为要向网卡添加源 IP;探测工具使用普通权限即可,支持主动扫描网段和被动监听两种模式,被动监听只监听 UDP 2425 上的广播,不主动发包。
投放出来的设备是伪造的名册条目,不是真实节点,重启对端的飞秋即可清除。
小结
缓冲区的问题是编码时漏掉一行,容易修复。而「谁在网段里发包,谁就是一台设备」这个前提来自协议设计,它决定了这套网络里身份概念的实际约束力很有限。对局域网软件来说,这一层的设计比代码细节更值得关注。
文中的测试在自有设备和自有网络内完成。伪造设备上线会对办公网络造成实际干扰,不要在未获授权的网段上测试。